



从一次线上故障说起
上周发现数仓有张 ADS 表停更了一周,下游的搜索服务数据源直接断了。
传统排查路径:DataWorks 控制台 → 找节点 → 看日志 → 上游失败 → 再往上追 → 发现 ODS 同步配置错了。3 个系统 7 个页面来回跳。
我实际的操作:
我: 查看搜索链路的调度状态→ ads_report_daily: 最新分区 ds=20250328,停滞 7 天→ 上游 ods_dim_tag: 0 分区,从未同步成功→ 上游 ods_audit_log: 0 分区,同上→ 根因: 数据源类型注册为 rds,实际应为 postgresql
一个对话窗口,没切过页面,3 秒定位根因。最终三小时完成数仓链路重构:
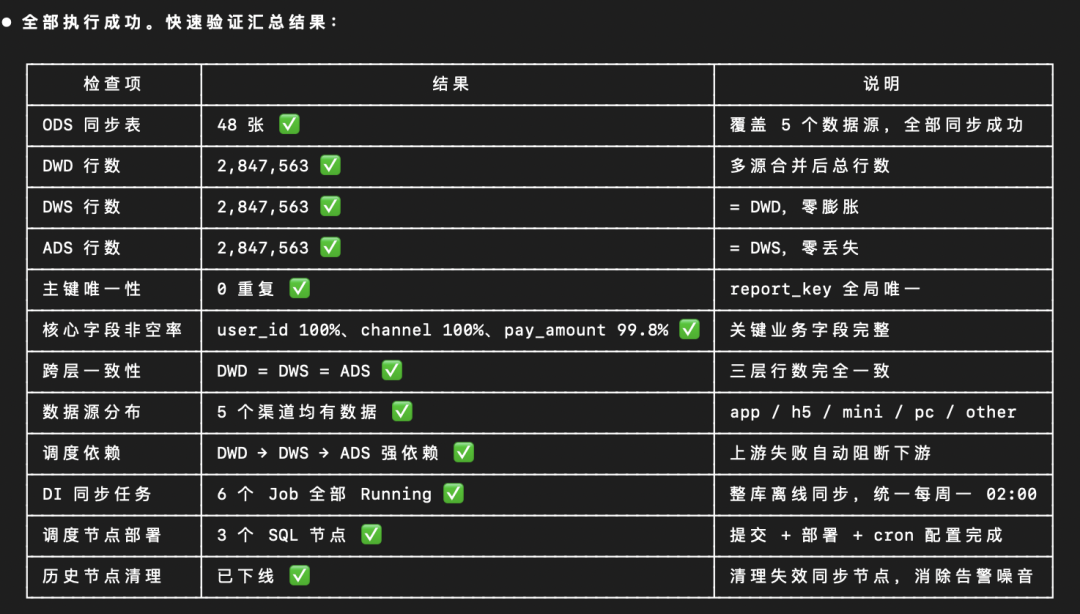
这背后是一套我用 Claude Code Skill 封装的数仓开发工具链。
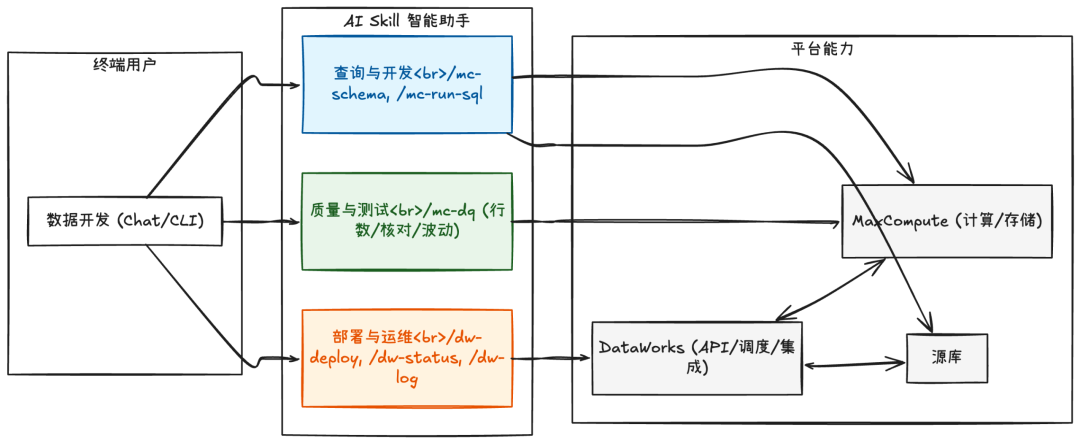
一、数据开发的时间都花在哪了
做过数仓的都懂,最耗时的不是写 SQL,而是围绕 SQL 的一切:
1. 查表结构开一个页面,查数据开一个,查调度又一个,一次排查 5 个 Tab2. ETL 写完了还得到控制台建表、建节点、配依赖,全是表单弹窗3. 部署一个节点 8 步点击(保存→提交→填备注→等 pipeline→部署→确认),3 个节点 24 步4. 跑完 ETL 手写验证 SQL:COUNT、COUNT DISTINCT、非空率、跨层对比,每次都差不多但每次都要写5. 35 个节点统一改个 cron 表达式,控制台操作 1 小时起
加一块,一天能专心写 SQL 的时间可能不到 30%。
二、从开发链路看 Skill 怎么用
1. 开发阶段
/mc-schema ods_order_main→ ods_order_main (28 cols, 分区: ds, 最新: ds=20250406)order_id: STRINGuser_id: STRINGstatus: STRINGchannel: STRINGpay_amount: DECIMALcreated_at: DATETIME
/pg-query biz_db SELECT channel, COUNT(1) FROM orders WHERE status='paid' GROUP BY channel ORDER BY 2 DESC→ channel | countapp | 328,106h5 | 215,773mini | 134,529
不装客户端,不配连接串,对话里直接查。
/mc-run-sql etl_dwd_order_detail.sql 20250405→ 执行中... Instance: 2025040502xxxx→ 完成! 耗时 47 秒→ 合计: 2,847,563 行→ channel_app: 1,203,421 | channel_h5: 876,330 | channel_mini: 512,108→ channel_pc: 255,704
自动替换日期变量,跑完直接输出行数分布。
Skill 的 prompt 核心就这几行:
读取本地 SQL 文件 {file_path},将 ${bizdate} 替换为 {bizdate},去掉 SET 语句(通过 hints 传入),调用 PyODPS execute_sql 执行,等待完成,自动执行 SELECT source, COUNT(1) ... GROUP BY source 输出行数分布。
2. 测试阶段
这是我觉得 Skill 提效最明显的环节。之前每跑完一轮 ETL 都要写一堆验证 SQL,现在:
/mc-dq ads_report_daily 20250405→ 总行数: 2,847,563→ 主键 report_key: 2,847,563 unique, 0 重复 ✅→ 较上期 (2,831,207): +0.6% 波动 ✅→→ 字段非空率:→ user_id: 100.0% ✅→ channel: 100.0% ✅→ pay_amount: 99.8% ✅→ city: 97.2% ✅→ device_type: 85.3%→ coupon_id: 32.1%→→ 跨层一致性:→ DWS: 2,847,563 = ADS: 2,847,563 ✅
一行命令跑完行数、唯一性、非空率、跨层对比、环比波动。这个 Skill 的 prompt:
对 {table_name} 的 ds={bizdate} 分区执行数据质量检查:1.SELECT COUNT(1) 总行数2.主键唯一性:根据表名推断主键(ads_* → report_key,dwd_* → order_id+dt),执行 COUNT(1) - COUNT(DISTINCT key) 检查重复3.核心字段非空率:取前 10 个 STRING 列,统计 COUNT(CASE WHEN col IS NULL OR col='' THEN 1 END) / COUNT(1)4.跨层一致性:ADS 表自动找上游 DWS 表对比行数5.与上一分区对比行数波动重复 >0、空值率 >5%、波动 >20% 时标注告警。
我: coupon_id 非空率为什么只有 32%?→ coupon_id 关联 dim_coupon 表→ 只有参与优惠活动的订单才有 coupon_id,非活动订单为空→ 32.1% = 914,068 / 2,847,563,与运营侧活动覆盖率一致,符合预期
DQ 检查 → 发现异常 → 追因 → 确认预期,同一个对话里闭环。这是脚本做不到的——脚本只能告诉你"49%",不会帮你分析为什么。
3. 部署阶段
/dw-deploy etl_dwd_order_detail etl_dws_order_agg etl_ads_report_daily→ 更新 3 个节点 SQL...→ 提交...→ 部署... 3/3 ✅
这个 Skill 背后做的事:
# Skill 实际调用的 API 链路forfile_idinfile_ids:client.update_file(file_id,content=sql # 更新 SQLclient.submit_file(file_id) # 提交time.sleep(8) # 等 pipelineclient.deploy_file(file_id) # 部署
8 步手动操作 × 3 个节点 = 24 步点击,现在 1 行命令。
/dw-create-dijob pg_external new_schema ods_new_ --cron "00 00 02 ? * 1" --tables 26→ 创建 DI Job: ods_new_full_sync→ 配置 26 张表映射 + 分区规则 + 调度参数→ dijob_id: 10086 ✅→ 启动... Running ✅
4. 运维阶段
/dw-status→ === DI 同步 (9 个) ===→ 全部 Running ✅→ === 链路 A (规则引擎) ===→ DWD → DWM → DWS → ADS: SUCCESS ✅→ === 链路 B (搜索服务) ===→ DWD(03:31) → DWS(04:01) → ADS(04:31): SUCCESS ✅→ 数据新鲜度: ds=20250406 ✅
/dw-log etl_ads_report_daily 20250405→ FAILED: column pay_time cannot be resolved→ 原因: 上游源表字段从 pay_time 重命名为 paid_at(修完 SQL 后)/dw-deploy etl_ads_report_daily/dw-rerun etl_ads_report_daily 20250405→ SUCCESS (32 秒) ✅
查日志 → 看到原因 → 改 SQL → 部署 → 重跑 → 验证,全在一个窗口里。
三、三小时完成一次链路重建
以上来自真实业务场景:搜索服务的数仓链路设计有问题,需要从源表出发完整重建。
原来的 ADS 表错误依赖了另一条链路的中间表,数据粒度和字段都对不上。需要分析多个异构数据源的表结构差异,逆向现有同步脚本的字段转换逻辑,重新设计 DWD→DWS→ADS 三层架构,多源做 UNION ALL 合并。
用 Skill 搞定:
-
分析: /pg-query+/mc-schema快速遍历所有表结构,/mc-query核对数据量和分布 -
开发:编写 3 个 ETL SQL(~900 行), /mc-ddl批量建 12 张表 -
验证: /mc-run-sql逐层执行,/mc-dq全套质量检查——百万级数据零膨胀零重复 -
部署: /dw-deploy批量部署节点,/dw-set-deps配置依赖链,/dw-update-cron统一调度频率,/dw-create-dijob创建同步任务,/dw-offline清理失效节点
如果完全在控制台操作,需要多久呢?
四、如何开始构建 skill ?
三步:
1. 梳理你的高频操作
回想过去一周,哪些操作每天都在重复?查表结构、查调度状态、部署节点、写验证 SQL。这些就是 Skill 候选。
2. 找到对应的 API
3. 写 Skill prompt
核心就是一段 prompt:做什么、调哪些 API、怎么输出。
/dw-status查看 PROD 调度状态:1.ListDIJobs 获取同步任务状态2.ListInstances 获取最近 2 天实例(按链路分组)3.检查 MaxCompute 表最新分区4.输出:按链路分组,标注异常
AI 会处理参数拼装、分页、错误重试、结果格式化。你只需要定义"要什么"。
五、写在最后
数据开发的核心价值在于理解业务、设计模型、保障质量,而不是在控制台上点来点去。
工具的进化方向,永远是让人回归思考本身。

相关文章


