



在数字化转型的深水区,企业往往面临这样的困境:业务系统林立,数据分散如孤岛;想要做分析,却发现数据口径不一、质量参差不齐。为了解决这些问题,“数据中台”成为了热词。
但在实际落地过程中,很多技术人员和业务管理者常常混淆两个核心概念:数据集成与数据开发。它们到底有什么区别?在构建数据资产的过程中各自扮演什么角色?
今天,我们就结合 qData 数据中台 的实战能力,为大家彻底理清这两者的边界与联系。
一、核心定义:从“搬运”到“炼金”
如果把数据比作矿石,那么数据集成就是“采矿与运输”,而数据开发则是“提炼与加工”。
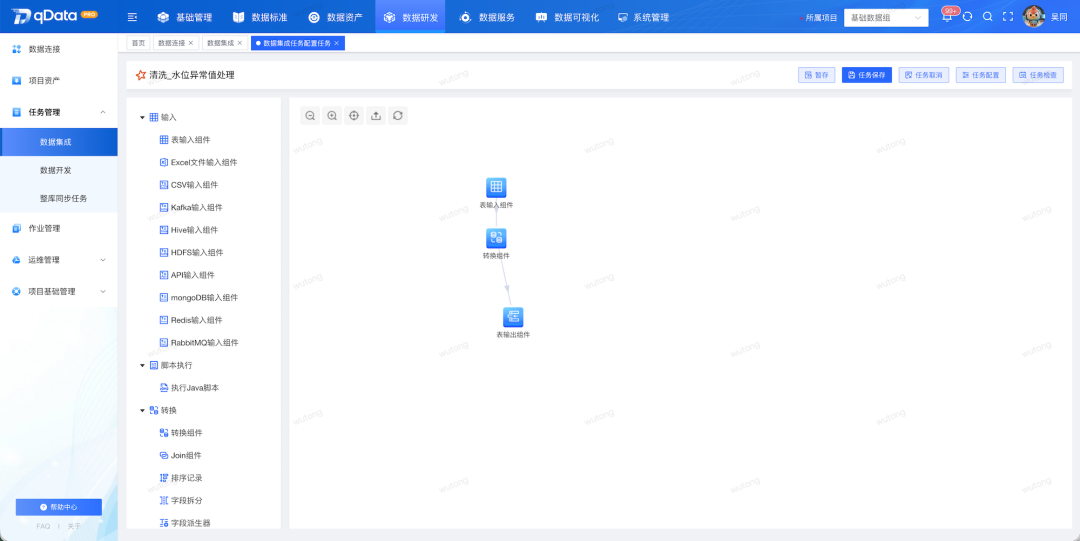
1. 数据集成 (Data Integration)
定义:将散落在各个业务系统(如 ERP、CRM、MES 等)中的数据抽取出来,汇聚到一个统一的地方(通常是 ODS 贴源层),并进行基础的格式统一。
核心动作:抽取 (Extract)、加载 (Load)、基础转换 (Transform)。 技术实现:通过内置的 JDBC、Binlog、API 等驱动,利用可视化拖拽配置输入输出组件,完成 ETL 操作。 目标:解决“数据在哪里”和“如何拿过来”的问题,实现物理上的集中。 
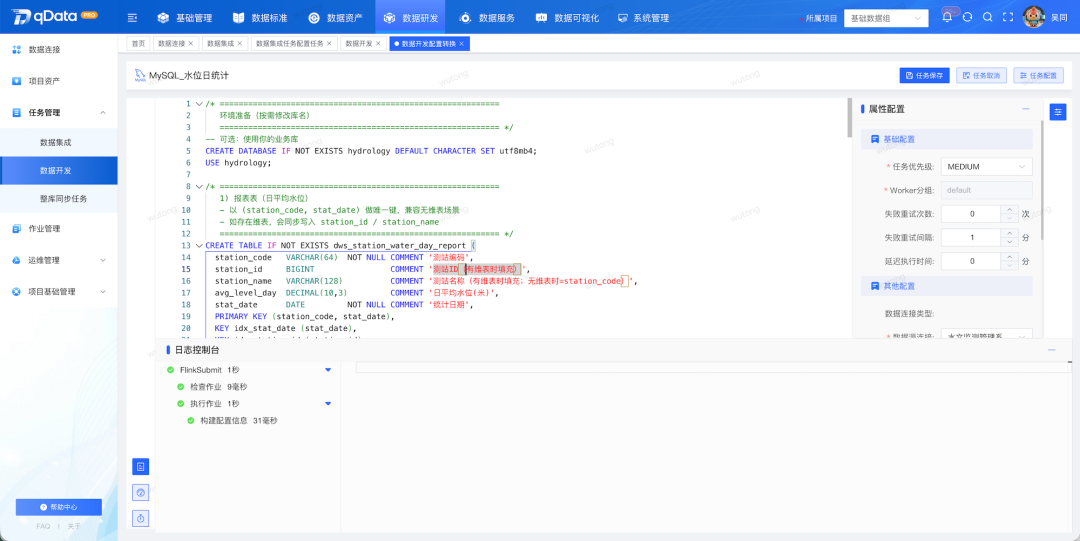
2. 数据开发 (Data Development)
定义:基于集成后的原始数据,编写复杂的业务逻辑代码,计算出具体的业务指标、标签和宽表。
核心动作:复杂计算、逻辑清洗、模型构建、指标加工。 技术实现:主要通过 SQL (Hive/Spark/Flink SQL)、Python 或 Shell 脚本,在专业的 IDE 环境中实现。 目标:解决“数据代表什么业务含义”的问题,将原始数据转化为可直接服务上层应用的数据资产。
“
一句话总结:数据集成负责把数据“搬进仓库”,数据开发负责在仓库里把数据“做成商品”。
”
二、深度对比:四大维度看差异
为了更直观地理解,我们从技术实现、处理对象、应用场景及在 qData 中的功能表现四个维度进行对比。
| 处理对象 | 原始数据 | 加工后数据 |
| 技术门槛 | 低代码/可视化 | 代码驱动 |
| 核心逻辑 | 同步与映射 | 业务运算 |
| qData 功能支撑 | 数据集成任务 | 数据开发任务 |
三、场景实战:什么时候用哪个?
在实际项目中,选对工具事半功倍。以下是典型的适用场景:
🎯 数据集成的主场
贴源层建设 (ODS) 场景:需要将 10 个不同业务系统的 500 张表,原封不动(或仅做轻微清洗)地同步到数据仓库。 qData 实践:利用“整库同步”功能,一键配置源端 MySQL 和目标端 Hive,自动创建表结构并全量/增量同步数据。
数据库迁移与备份 场景:旧系统下线,需要将历史数据整体迁移到新库,或建立异地灾备。 qData 实践:配置定时同步任务,确保新旧库数据一致性,支持断点续传。
实时数据采集 场景:监控业务库的 Binlog,实时捕获订单变更并发送到 Kafka。 qData 实践:使用 Flink CDC 组件,实现毫秒级的数据捕获与分发。
🛠️ 数据开发的主场
管理报表与指标计算 场景:老板要看“过去 7 天华东地区的销售总额”、“日活用户数 (DAU)”、“复购率”等统计指标。 qData 实践:编写 Spark SQL 任务,关联订单表、用户表和地域维表,进行聚合计算,生成 DWS 层宽表。
复杂数据清洗与标准化 场景:不同系统对“性别”的定义不一致(男/女 vs 1/0 vs M/F),需要根据复杂的字典对照表进行统一;或者需要回溯用户的历史状态变化(拉链表)。 qData 实践:在 IDE 中编写 Python 脚本或复杂 SQL,调用平台内置的“清洗规则”(如手机号格式化、身份证校验),实现深度治理。
算法模型训练数据准备 场景:为 AI 预测模型准备特征工程数据。 qData 实践:通过多步 SQL 任务,进行特征提取、归一化处理,输出训练集。
四、为什么需要一体化平台?
在传统架构中,数据集成可能用 Kettle,数据开发用 Hue 或 DataGrip,调度用 Crontab 或 Azkaban。工具割裂导致了元数据断层、血缘不清晰、运维困难等问题。
qData 数据中台 的核心优势在于将“集成”与“开发”融合在同一个底座上:
统一的作业管理无论是可视化的集成任务,还是手写的 SQL 开发任务,都可以在作业管理模块中进行统一的依赖编排。支持串行、并行、条件分支,形成完整的数据流水线 (Pipeline)。 全链路血缘追踪从源系统表 -> 集成任务 -> ODS 表 -> 开发任务 -> ADS 报表,qData 能自动生成字段级血缘图谱。当源端字段变更时,可快速评估对下游报表的影响。 标准化的数据治理在开发和集成过程中,直接调用平台统一的数据标准(数据元、字典)和质量规则(稽查、清洗)。实现了“设计即治理”,确保产出的数据资产天然合规。 自主可控的源码交付对于有深度定制需求的企业,qData 提供源码级交付。企业不仅拥有软件的使用权,更拥有对集成引擎、开发环境的完全掌控权,避免被厂商“黑盒”锁定,真正实现技术资产的沉淀。
五、结语
数据集成是地基,数据开发是高楼。只有地基打得稳(数据全、准、快),高楼才能建得高(指标准、模型优、价值大)。
在选择数据中台时,不应只看单一功能的强弱,更要看其是否具备批流一体的集成能力、灵活强大的开发环境以及贯穿全流程的治理体系。qData 正是这样一套能够陪伴企业长期演进、真正自主可控的数据基础设施。
💡 互动话题: 在你的工作中,是花在“洗数据”(集成/清洗)的时间多,还是花在“写逻辑”(开发/建模)的时间多?欢迎在评论区留言讨论!

相关文章


