



在AI产业全面进入大推理时代的当下,企业一边为AI业务的综合成本而焦头烂额,另一边又在花大价钱锁定各类ICT设备产能。这一现象背后,是企业越来越明显的算力困境:每Token成本下不来,企业就没有足够的利润支撑未来AI业务投资,而不断细分的AI场景又让针对性的优化难以实现。从追求绝对算力的“一根筋”,到性能与效率的“两头堵”,通往智能时代的路径似乎比以前更模糊了。
问题看似复杂,但症结只有一个:可选的算力平台太少,能应对的场景太少,能满足的需求层次也太少。
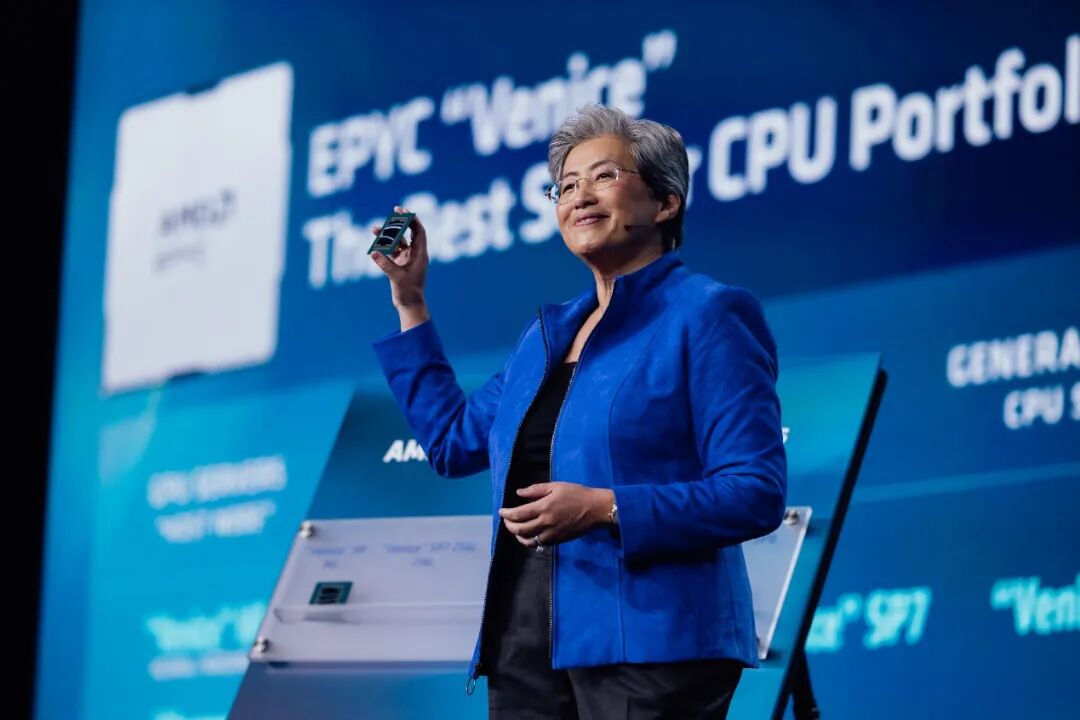
而在前段时间举办的Advancing AI 26大会上,AMD则用追求极致的算力平台和多样化的产品技术给出了破局之法。
AMD的平台化
既要单项第一,也要综合领先
作为上游,硬件厂商要帮助企业真正降低每Token成本,不止要提供更强的GPU,还要提供更强大的系统级平台来实现效能的综合优化,继而从更高维度来实现超越摩尔线程的效能提升。同时,硬件厂商还需要有更强的CPU、更高效的网络、更好用的软件堆栈和更针对性的场景优化方案,以便企业能够根据自身需求和实际场景来搭建丰富且高效的业务架构。
一言以蔽之,硬件公司既要提供单项第一的各种产品,又要用这些产品来组建1+1>2的平台。
而更令人惊叹则是,这种“既要又要”的需求,AMD竟然做到了!
从芯片到平台
为每一种AI业务赋能
要看懂AMD的平台化,首先要看懂AMD在AAI 26上发布的海量产品如何在AI场景中发挥价值,而后要搞清这些产品如何彼此连接、彼此放大,最终在多样化的场景中,降低企业的每Token成本。
01、CPU:把模型变为产品和服务

AI模型只是一个记录了算法和权重的大型文件,而真正有价值的AI服务则是要把模型和N种已有业务联系起来,帮助终端用户解决实际问题。以目前流行的AI智能体业务为例,从前端的用户请求响应,到构建Prompt和上下文分析,到执行层面的Planning、Reasoning和决策,再到后续的多轮循环控制、失败重试、超时控制,以及顶层的系统控制和业务编排……都需要依靠CPU算力来实现。换言之,CPU能否高效处理整个AI业务流程才是GPU火力全开的前提。
因此在大推理时代,我们才能看到CPU与GPU的数量比不断逼近1:1的现象。而AI业务场景也正是第六代EPYC处理器发挥优势的典型场景。
从架构层面来看,AMD第六代EPYC处理器同样包含Zen 6和Zen 6c两种核心。
其中,Zen 6核心能提供更高主频、更高IPC,每个AI进程提供极致的性能和更低的延迟,代表产品是EPYC 9676F。其拥有96核心/192线程、384MB三级缓存和8个内存通道Boost频率可达5GHz,提供128个PCIe 6.0高速通道和对DDR5 8000MT/s标准DIMM及12800MT/s MRDIMM的支持。
而Zen 6c核心则能带来更高的计算密度,让各类云原生业务获得更好的TCO,代表型号是EPYC 9996。其包含256核心/512线程、1024MB三级缓存和16个内存通道,Boost频率可达4.1GHz,同样支持PCIe 6.0以及DDR5 8000MT/s标准DIMM和12800MT/s MRDIMM。
两种不同侧重的处理器能让用户根据自身前后端业务比例和传统业务需求灵活搭建基础架构,实现AI业务与传统业务性能的精确匹配。同时,PCIe 6.0总线和MRDIMM的支持也能大幅提升CPU的GPU和内存子系统的数据传输速率,继而提升系统的整体效能。
当然,由于第六代EPYC处理器实现了IPC、多核性能、核心数量、能效和连接性等的全维升级,即便没有AI参与的云和传统业务也能从新处理器中获得可观的综合性能收益。
02、GPU:为AI算力提供全新路径
本次AAI大会上,AMD发布了使用CDNA5架构的Instinct MI455X和MI430X两款GPU新品;前者定位于前沿AI研究、AI工厂和大规模训练和推理场景,而后者则主要服务于主权AI、科学计算和HPC应用。
除在架构层面进行持续优化之外,Instinct MI400系列GPU也围绕下一阶段AI基础设施的发展需求,在计算能力、能效表现、数据处理效率以及规模化部署能力等方面实现全面提升,而这也能让用户在保持模型精度的前提下大幅降低计算和数据传输开销,实现效果与成本的高维平衡,并最终降低每token成本。
Instinct系列GPU的持续升级迭代已经为行业提供了打造巅峰AI算力的另一条路径。并且伴随ROCm框架在功能、易用性和用户积累方面的持续完善,Instinct系列GPU的算力同样能满足各种业务的实际需求。
03、网络与DPU:高速、高效、开放
Pensando网络是AMD将CPU、GPU等算力产品连接成完整平台的关键拼图,也是AMD完成平台化发展的必备技术。
在产品方面,AMD在本次AAI大会上发布了Salina DPU和Vulcano 800G AI智能网卡。
其中Salina DPU能为整个机架提供400G网络带宽,并帮助CPU处理网络、数据加解密和存储等数据类负载,既能帮助云服务提供商提升基础架构效率,也能在AI集群的多层级存储系统中加速超长KV Cache数据的存储和读取。
而Vulcano 800G AI智能网卡则是专为GPU互联通信而生的新一代智能网卡。在AMD的架构设计中,每个Instinct MI400系列GPU可搭配3张Vulcano网卡,实现总计2.4Tb/s的Scale-Out互联带宽,让GPU实现高带宽、低延迟的显存互访,继而提升超节点的整体计算效能。
更重要的是,AMD在Vulcano 800G AI智能网卡上使用了全新的PCIe 6.0总线和UALink互联协议。前者能够为800G网卡带来足额的总线支持,而后者则是一套由AMD、OpenAI、Meta、xAI等众多行业巨头共同发起的,专门面向大规模GPU互联的开放网络协议,更支持多种RDMA协议。
有了高效能的DPU、网卡和开放互联协议,不仅AMD可以将CPU、GPU算力整合成为性能更强的Helios超节点系统,用户也能快速搭建自己的AI集群,在不被私有网络协议绑定的前提下,实现网络的高速高效,且让系统规模和配置与现实业务需求相匹配。
05、ROCm:AI驱动,让算力更易用
除继续完善对vLLM、SGLang等流行AI框架的支持,并强化ROCm Core SDK的模块化进程之外,AMD还宣布了全新ROCm.AI——一款由AI驱动的编程辅助工具栈。
ROCm.AI包含三大组件:
ROCm CLI:统一的命令行工具,可用于AI环境的安装、配置、验证、更新和排障,提升企业的CI/CD效率。
ROCm控制台:为用户提供可视化的业务负载效能分析,帮助用户找到计算过程的瓶颈所在,继而为后续调优提供底层支撑。
ROCm Hyperloom:一款面向AMD GPU的专业智能体,可通过性能分析、数据跟踪、代码分析、代码调优等方式实现端到端的AI业务调优。
同时,AMD还将这些基于AI的编程、分析、调优、排障方法打包成为新的AMD Skills,用户可在Codex、Cursor、Claude等辅助编程工具中随时调用。

左手是CPU+GPU+网络的全维硬件进化,右手则是以ROCm为核心的软件堆栈持续完善,以及AI辅助编程能力的革新,软硬兼施之下,AMD正通过多样化的技术手段持续打破算力和TCO的天花板,为AI技术的落地与普惠提供全新路径,而Helios就是这一策略的绝佳证明。
05、技术生态扩展:为场景提供专门优化
在持续推进CPU、GPU等现有技术架构不断演进的同时,AMD也在通过对前瞻性技术公司的收购来实现对各类细分场景的深度优化。
MEXT:提升AI和各类业务系统的内存效率
MEXT的技术方案能帮助用户将业务中相对“冷”的数据从DRAM迁移至Flash介质之上,并且这一过程对于应用而言完全透明。由此,用户便能更轻易地平衡DRAM成本与实际业务需求。在内存价格长期疯涨且供货紧张的当下,MEXT的技术显然极具成本优势和业务价值。
TAALAS:把大模型烧录在硅片上
而TAALAS则能将特定大模型(包括权重、架构、计算图等内容)直接固化在硅片上,实现极高吞吐和极低延迟。以固化了Llama 3.1 8B模型的HC1芯片(6nm工艺)为例,其能在少量SRAM(完全没有HBM)的情况下实现1.7万Token/s的推理速度,是GPU的近10倍。实际应用中,TAALAS产品构建成本仅为传统GPU的1/20,功耗仅为传统GPU的1/10。
06、Helios超节点:用平台化的技术打造极致算力
AMD终于用自有技术推出了超节点产品!Helios在一个标准OCP宽度的机柜中整合了18颗Zen 6架构EPYC处理器、72颗Instinct MI455X GPU以及配套的Pensando交换网络、供电和液冷设备。
用领先的CPU实现高效的任务调度和编排,用强大的GPU带来顶级的Token吞吐量,用高效网络将异构算力整合为一,在通过ROCm让算力转化为AI业务和实际价值;AMD通过多种技术打造的超节点不只是打破了集群的互联效率限制,更让用户在构建算力金字塔的过程中有了更强大、更高效的巨构模块。而由此带来的性能和效率提升也能更直观的反应在每Token成本之上。
表面看是一台性能巨兽,实际却在用更大的力量将每Token成本压缩至极限,难怪系统一经发布,行业巨头的订单便纷至沓来。

丰富且性能强劲的基础硬件,提供巅峰算力的超节点系统,完善的软件堆栈……相辅相成的产品线让AMD赢得了全球AI巨头的青睐。
OpenAI:6吉瓦合作项目进入落地阶段
OpenAI计划于2026下半年开始实际部署Helios超节点系统,而这仅是双方6吉瓦GPU部署计划的第一阶段。同时,来自OpenAI的软件和应用经验也将反馈至AMD,助力未来的MI500系列GPU和ROCm软件堆栈开发,继而形成上游与下游、软硬件与AI业务负载相互促进的正循环。
Meta:提前获得Helios的使用权
目前,Meta已提前获得Helios的使用权,而双方工程师也正在展开基于新系统的联合测试,以便Helios能在硬件、软件和系统层面完全融入Meta的业务框架。同时,Meta也在计划部署基于Instinct MI450的定制GPU产品,而基于Zen 6架构的全新EPYC处理器平台的验证和测试工作也在稳步推进。
多家行业巨头的巨额订单以及众多领域的深入合作证明,AMD不仅在用产品和服务解决AI时代企业用户的实际业务痛点,更在通过产业上下游的紧密合作确保技术和应用的相互匹配。显然,这种务实、开放、广泛的用户合作策略正是AMD能够在硬件市场持续增长的核心原因。而用户合作的广度和深度一旦形成,AMD的长期增长势能便有了保证。
CPU是骨架、GPU是肌肉、网络是神经链接、ROCm是学以致用的丰富经验、各类场景的专用技术是灵巧双手……AMD正在用全维度的技术进化助力企业用户把AI从模型落实为有价值的服务。从训练到大规模推理,从先进的CPU、GPU、网络产品到极致性能的机架平台,从通用技术到专项应用的极致优化;AMD不仅变得更加专注,也变得更加全能。而这种全栈技术领先+场景快速拓展的策略也成为驱动更多用户和伙伴加入AMD生态的底层动力。

这样一个锐意创新的AMD既是对Advancing AI、Advanced Micro Devices的完美诠释,也是能够与用户携手共赴未来的绝佳伙伴。

相关文章


