



2026年9月,一则消息在AI圈炸开了锅。
IDC发布报告:全球活跃智能体(Agent)数量,2025年才2860万个,2026年预计飙到7940万个,2030年将突破22亿。
22亿个AI智能体,比全世界所有打工人加起来还多。
去年大家还在争论"大模型是不是泡沫",今年画风突变——没有人在乎参数数量了。
如果你还以为AI大模型就是"聊天机器人",那这篇文章值得你花10分钟读完。以下是2026年正在发生的6个核爆级变化,每一个都跟你有关。
一、告别"参数竞赛":大模型不再拼大小,拼"会不会干活"
过去两年,AI圈有个潜规则——谁家模型参数多,谁就嗓门大。
这个逻辑在2026年彻底失效了。
大规模参数训练的边际效益趋于平缓,算法架构革新成为新突破点。用行话说:Scaling Law边际收益收窄,竞争重点从"谁能训练更大的模型"转向"谁能让模型更会思考、更会干活"。
2025年中国AI大模型市场规模约495亿元,2026年预计突破700亿元,同比增长49.1%。
但钱不再花在"堆参数"上。摩根大通报告指出,中国AI市场正处于明显拐点,编码和智能体场景需求正在加速增长。
行业共识已经形成——从"参数竞赛"转向"效率革命+Agent落地"。
代表案例:DeepSeek系列坚持极致成本效率路线,2026年中发布的DeepSeek-V4在关键基准上接近GPT-5.5与Claude Opus 4.7水平,训练成本却仅为国际同档模型的几分之一。
二、Agent全面爆发:2026年,AI不再"动嘴",开始"动手"
这是今年最炸裂的变化。
2026年之前,你问AI"帮我写个方案",它给你一段文字。你问AI"帮我订个餐厅",它说"我做不到"。
2026年,AI开始自己干了。
报告这样定义这个转折:2026年是AI从"被动问答工具"转向"自主执行单元"的分水岭。
大模型不再只是"聊天工具",而是在向"能够持续执行任务的数字员工"演进。未来的方向是多智能体协同、实时多模态交互和企业级智能体平台建设。
WAIC 2026(世界人工智能大会)上,这个信号被放大到极致:
- 百度
推出通用智能体"百度搭子",日均提问增长20倍,月访问增速114.72%全球第一 - 腾讯
以WorkBuddy、CodeBuddy、Marvis三线布局办公/代码/电脑控制,混元Hy3接入全系产品 - 蚂蚁集团
"阿福"用户超1亿,日均处理1000万+次健康咨询 - 阶跃星辰
推出国内首款L3级认证智能体手机STEPX Neo
据IDC预测,这意味着很快,你身边会有比人还多的AI"同事"。
三、国产大模型首次领跑全球:中国AI不再"跟随"
如果2026年只记住一件事,记住这个:
全球最大开源模型来自中国——月之暗面Kimi K3,2.8万亿参数,100万token上下文,发布48小时因用户涌入暂停新订阅。独立评测机构Vals AI称其综合性能超越OpenAI旗舰模型GPT-5.6 Sol。
再看实际调用量。2026年2月,全球大模型API调用量排行榜(OpenRouter)上,国产大模型占据前十中的四席:
- MiniMax M2.5
— 4.78万亿Tokens - Kimi K2.5
— 4.1万亿Tokens - GLM-5
(智谱)— 3.45万亿Tokens - DeepSeek V3.2
— 2.76万亿Tokens
到2026年3月,国产日均Token调用量突破140万亿,两年增长超千倍。全球AI大模型总调用量前十中,中国占据六席。
中国AI产业正从"拼规模"转向"拼密度",从"应用优先"走向"产业协同"。DeepSeek的NSA、月之暗面的MoBA等稀疏注意力机制,成为全球AI技术的重要方向。
四、百万Token时代到来:AI能记住你一整年的聊天记录
2022年,大模型上下文窗口只有4k Tokens。2025年,突破1M+ Tokens,增长250倍。
2026年,这个数字被进一步拉升到4M Tokens级别。
意味着AI可以一次性读完《三体》三部曲(约90万字),还能记住每一个细节。
WAIC 2026上,各大厂商在上下文能力上疯狂内卷:
- 月之暗面Kimi K3
— 100万token上下文 - MiniMax M3
— 百万Token上下文,原生多模态 - 智谱GLM-5.2
— 可一次处理88万+token,Code Arena全球可用模型第一
阿里通义千问Qwen系列迭代到Qwen3.5,以多语言、长上下文与Agent化工具调用为主线。
随之而来的是编程能力成为新标尺。编程能力意味着AI具备逻辑拆解、工具改造、系统联动的底层改造能力,是智能体能自主驱动硬件、对接系统的核心基础。
五、行业大模型井喷:AI从"实验室"扎进"生产线"
技术再炫,落不了地都是空中楼阁。
2026年最让人兴奋的变化是——AI正在以前所未有的速度进入千行百业的核心业务。
金融领域的"文心一言·金科版"、医疗领域的"盘古医学大模型V3"、工业领域的"讯飞星火·智造版"已实现API调用量月均超百亿次,模型即服务(MaaS)成为主流交付形态。
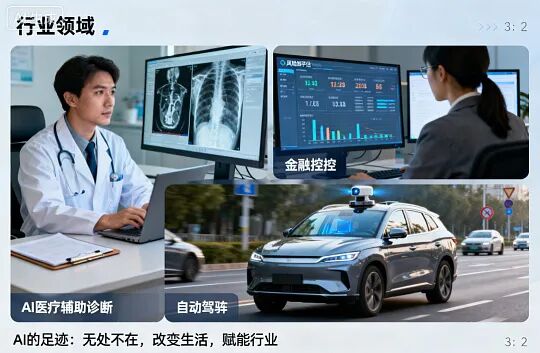
工程行业更是一个缩影:2023年只有3个工程类AI大模型,2024年15个,2025年28个,2026年进入深度应用期。央企国企凭借数据、场景、资金优势占据主导地位。
一个标志性案例:中铁十四局的"深远大模型"——参数规模超2000亿,是国内首个超大规模的盾构领域混合专家模型,已获中国信通院4+级评级。该模型在杭州萧山机场线钱塘江隧道成功试点应用,让风险管控从"被动应对"升级为"主动预控"。
据预测,未来3—5年,大模型专有云服务市场将保持80%以上的高增速。AI推理需求的爆发式增长将持续拉动市场扩容。
六、政策加码:国家出手,擎画大模型新蓝图
大模型爆发的背后,国家政策正在扮演关键的"加速器"角色。从顶层设计到资金扶持,从算力基建到落地场景——一套组合拳正全力护航中国AI大模型产业。
🔧算力基建全面铺开,大模型不再"缺芯少算"
国家"东数西算"工程持续深化,在京津冀、长三角、粤港澳大湾区、成渝、贵州、内蒙古、甘肃、宁夏等地布局全国一体化算力网络国家枢纽节点,推动智能计算中心有序发展。
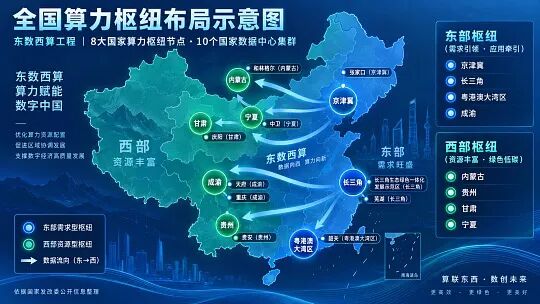
更重磅的是,人工智能算力基础设施项目已被明确纳入政府和社会资本合作(PPP)重点支持领域,算力设备及辅助设备基础设施已列入地方政府专项债券可用作项目资本金的行业范围。
这意味着什么?大模型算力建设有了"长期低成本资金"的强力支撑。社会资本参与热情高涨,算力不再是卡脖子的那根刺。
📜顶层设计明确定位,AI大模型站上"国家战略"风口
《"十四五"数字经济发展规划》明确提出:高效布局人工智能基础设施,重点突破核心算法与框架等关键技术,培育壮大人工智能等数字产业。
国务院在落实《政府工作报告》重点工作中多次强调:加快发展工业互联网,培育壮大集成电路、人工智能等数字产业,提升关键软硬件技术创新和供给能力。
在政务服务领域,国家更明确要求探索应用自然语言大模型等技术,提升政务服务智能化水平。
💰财税金融双管齐下,大模型企业"真金白银"减负
对从事人工智能等领域生产研发的企业,认定为高新技术企业后可享受所得税优惠,在特定区域还实行"报备即批准"的快捷认定机制。
在大模型"底座"——集成电路和软件产业方面,国家出台了力度空前的税收优惠政策:重点集成电路设计企业和软件企业可享受"第一年至第五年免征企业所得税,接续年度减按10%税率"的重磅优惠。
这意味着,大量AI大模型创业公司将获得实实在在的资金活水,轻装上阵。
🚀行业落地场景大开,大模型加速"下凡"
国家明确提出:
支持"人工智能+医疗"应用,优化AI辅助诊断医疗器械审评审批程序 支持"人工智能+消费"场景打造 在文化领域,国务院更直接提出建设文化领域人工智能高质量数据集,支持文化领域大模型建设
从金融"文心一言·金科版"到文化AI大模型,政策正为行业模型铺平从实验室到场景的最后一公里。
⚖️AI伦理治理前瞻布局,为产业发展划好"跑道"
在狂飙突进的同时,国家也在同步构建AI治理的"红绿灯"。
借鉴国际经验,国家支持建立人工智能技术的伦理道德和治理框架,设立人工智能伦理专家咨询机构,制定人工智能伦理规范指南。
"十四五"就业促进规划更前瞻性地提出建立人工智能对就业影响的跟踪研判和协同应对机制,避免就业替代效应短期内集中释放。
写在最后
回看2026年前九个月,AI大模型行业发生了根本性的转变:
大模型不再是一个"聊天工具",AI正在演变为能够持续执行任务的"数字员工"。行业竞争逻辑从"参数量军备竞赛"转向"效率优先",2026年被视为"企业Agent上岗元年"。
而国家政策,正为这场历史性变革注入最强劲的"国家队"动力。从算力基建到财税优惠,从场景开放到伦理治理——中国AI大模型,正在上演一场有组织、有战术、有弹药的全方位突围。
有人说,AI发展太快了,让人焦虑。
但换个角度想——
未来已来,只是分布不均。
而你正在读的这篇文章,就是见证。

相关文章


