



这周 AI 圈最火的东西,是一个不会聊天的模型。
它叫 Jev,9 月 15 日发布,这两周在海外开发者圈刷了屏。它不会写文章、不会做翻译、不会陪你聊天——你问它问题,它不给你一段话,只给你一个带概率的判断:是或否、选哪个、打几分。
就这么个“残缺”的模型,发布 36 小时涌进 14 万开发者,48 小时内在 GitHub 上冒出 6 个开源平替。在浏览器自动化场景里,同样一个任务,接口调用次数从 1092 次掉到 101 次,降了 91%。而它的价格是每百万输入 token 0.042 美元,输出永久免费——一次代码审查的判断成本约 0.00007 美元,同样的判断交给顶级模型要 0.0145 美元,差 200 倍。
今天不吹它多牛。Jev 不对中国大陆开放,我也用不上。但它背后的思路我偷来了——而且我发现,这套思路搬到我的公众号流水线上,比换个新模型管用得多。
老规矩,先上思维导图:
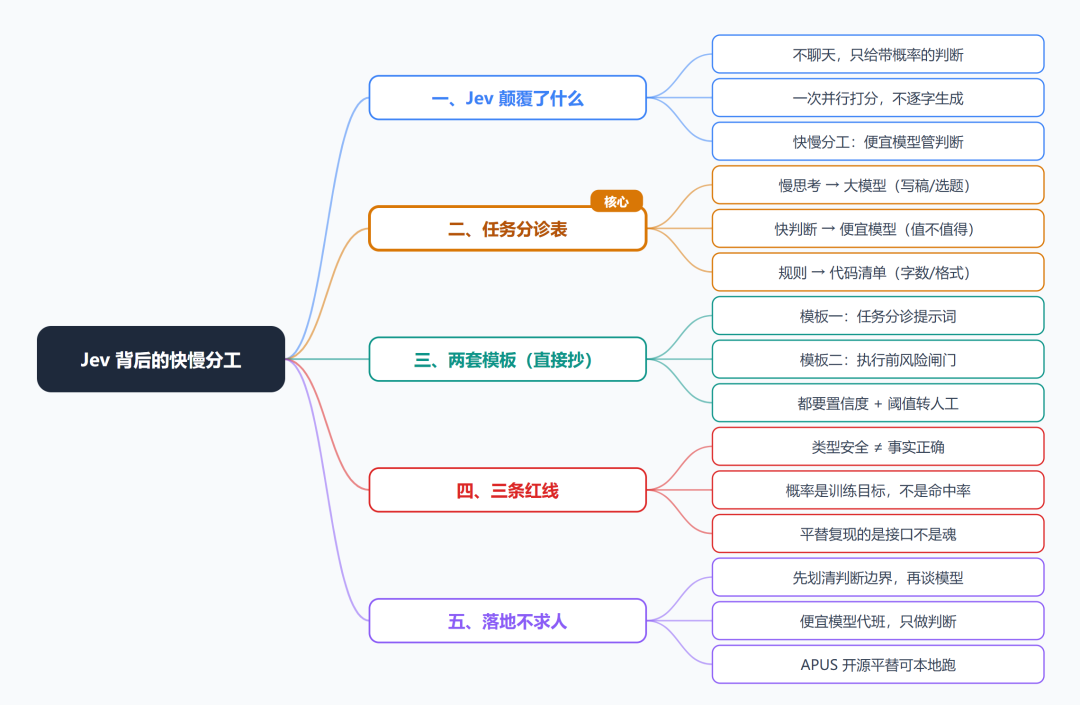
一、Jev 真正颠覆的:把“判断”从“生成”里剥出来
先看两个我们习以为常的场景。
你问大模型:“这个工单该转给哪个组?”它给你写三段分析,最后来一句“建议转给技术组”。你还得从这堆话里把答案刨出来。
你追问它:“你有多确定?”它说“有八成把握”。但这个八成是注水的——为了让长文本不跑偏,模型训练时就被逼着“过度自信”,主动砍掉低概率选项。所以它说的八成,可能是七成,也可能是五成,你没法拿它做决策。
Jev 的做法是反过来的:答案范围事先锁死,一次前向计算并行算出所有选项的分数,直接返回最高分和置信概率。一个字都不生成。
它的创始人 Diogo Almeida 是前 OpenAI 研究员,InstructGPT 和 RLHF 的奠基人之一。当年就是他教模型“怎么说人话能讨好人类”,现在他反过来教模型闭嘴做判断。理由很锋利:RLHF 这套机制从第一天起就是为“辅助人”设计的,不是为“自动化”设计的;而字符串,是世界上最难优化的东西。
这套分工,业界给了个新词——Harness(编排层):贵的大模型负责“慢思考”(规划、生成、复杂推理),高频、原子化的“快判断”交给轻量模型。框架借的是卡尼曼《思考,快与慢》:System 1 和 System 2。
我认为这才是这条新闻真正的价值——AI 应用的分层,从“模型能力”下沉到了“任务分工”。
二、我流水线里的“大炮打蚊子”
看到“快慢分工”这四个字,我立刻回头查了自己的流水线,发现一个荒唐的事实:我把所有活都丢给了最贵的那个模型。
写稿该给大模型,这没问题。但我的流程里还夹着一堆判断,我也顺手全丢给它了:
• 这个选题值不值得写?
• 这条评论要不要回、怎么回?
• 初稿里这句话有没有出处?
• 这张封面图能不能用?
• 这篇文章现在能不能发?
这些活有个共同点:不需要它“写”,只需要它“选”。而“选”,本来是最便宜、最快的活。
拿写稿的模型去干判断的活,就像公司里让总监去核对报销单——不是说不行,是浪费。
三、给你一张“任务分诊表”(直接抄)
我把流水线里的活重新分了一遍,按“慢思考 / 快判断 / 规则”三档:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
中间那一档,是过去被我浪费最狠的。
重新分完档,我流程里的“调用大模型”从十几个点降到三四个点,判断那一层基本不花钱,而且快——因为它不再需要“写一段话再让我读一遍”。
核心就一句:写稿该慢的慢,判断该快的快。
四、两套模板,直接抄走
只讲道理不给模板的分享都是耍流氓。这两套是我现在真在用的,去掉了专有部分,你改一下就能用。
模板一:任务分诊提示词(放在任何流程的最前面)
你先不要执行任务,先做一次判断。 任务描述:{把用户要做的事原样贴进来} 请从下面三个档位中选择一个: A. 慢思考——需要生成新内容/长链推理/创造性 B. 快判断——已有明确选项,只需选择/打分/判真假 C. 规则——有明确的硬标准,不需要理解语义 输出格式: 档位:A/B/C 理由:一句话 置信度:0-1 之间的数字 建议处理方式:{填你系统里真实存在的路径}
关键在最后两行:要它给出置信度,并且给自己留一条“拿不准就走人工”的路。没有置信度的判断,等于没有判断。
模板二:执行前的风险闸门(我最喜欢的一套,风控职业病)
你是执行前的风险审查员。下面的操作即将被执行: 操作内容:{贴进待执行的动作} 操作上下文:{谁发起的、什么环境、影响范围} 请对下面三个问题分别给出判断,每个都带 0-1 的置信度: 1. 这个操作是否可能造成不可逆后果?(是/否) 2. 这个操作是否超出常规范围?(是/否) 3. 继续执行还是转人工?(继续/转人工) 规则:任何一项置信度低于 0.9,一律输出“转人工”。 不要替我决定,只做判断。
我流水线里最后那个“发布”按钮,从来都留在我自己手里——这套东西可以让 AI 干完 99% 的活,但最后那一下必须是人按的。这不是技术限制,是设计选择。
五、三条红线(风控人的私货,但所有人都用得上)
Jev 火了之后,我看到最多的误读是“以后不用大模型了”。先别上头,这条路上有三个坑,第一个我就踩过。
红线一:类型安全 ≠ 事实正确。
Jev 号称“不会幻觉”,准确说法是:它不会生成你给的选项之外的答案,也不会把数字写成文字。但它依然可能选错。输出结构合法,和判断正确,是两件事。
红线二:概率是训练目标,不是你的命中率。
它说 90% 置信,统计上大约九成对——但这是在它的训练分布上。有开发者拿 50 条中文客服消息测,完整准确率只有 64%。还有位老哥把它接进实时交易机器人,按链上数据做买卖判断,一晚上亏了 31,680 美元——仪表盘上是一串 BUY(87%) → SELL(91%) → BUY(85%) 的横跳。快判断能回答“此刻做什么”,回答不了“全局应该怎样”。
红线三:开源平替复现的是接口,不是魂。
48 小时冒出来的那 6 个 clone,大多是“在现成模型上读 logits”来模拟。真 Jev 的杀手锏是 RLCD 校准概率和真正的并行多问题采样——概率可靠度得你在自己的任务上重新校准。别把高置信度直接当事实用。
第一版我翻车在哪?我图省事,把所有判断都丢给一个便宜模型,结果它把一段没有出处的引用判成了“有出处”。原因简单得扎心:它只会顺着你的话说。
后来想明白了:快判断模型的价值不在“聪明”,在“敢说不知道”。给选项、给标准、要概率、设阈值——这四件事做到,便宜模型才配干判断的活。
六、不用 Jev 也能落地
我知道你要问:它不对大陆开放,关我什么事。三条替代路径,从轻到重:
1. 先用提示词划清判断边界——把上面两套模板跑起来,你会发现“哪些活其实是判断”这件事本身就是最大的收益,跟用什么模型无关。
2. 让便宜模型代班——国产模型里挑个便宜快的,按模板只做判断(给选项、要概率),复杂生成仍旧交给主力模型。
3. 开源平替本地跑——中国公司 APUS 在 9 月 19 日开源了 Jev 的跨平台复现(MIT 协议,Mac、Windows、Linux 通吃,没显卡的电脑也能离线跑)。想动手的可以自己折腾,但红线三记得再看一遍。
七、说点真的
这套“快慢分工”,我最大的收获不是省钱,是思路换了。
以前我想的是“哪个模型最强”,现在我想的是“这件事到底需要多少智能”。大部分活根本不需要最强的模型,它们需要的是被清楚地判断一次。
而一旦你开始按“需要多少智能”来分配任务,会得出一个反直觉的结论:AI 时代最贵的从来不是生成,是判断——可判断恰恰是最能低成本批量做的。
Jev 这名字起得妙,取自经济学里的杰文斯悖论:当一种资源的单位成本暴跌,它的消耗总量反而会暴涨。判断变便宜了,你就会在流程里塞进更多判断:路由前问一次,生成后检查一次,执行前再拦一道。
流程里的判断密度,才是这个阶段的真正差距。

相关文章


