



算力产业链全景科普
本文只做产业链科普与知识框架梳理,不涉及二级市场判断,也不做个股推荐。
我们只回答一个问题:AI 时代的“算力”,到底是怎么被造出来、交付出去、最后被消耗掉的?
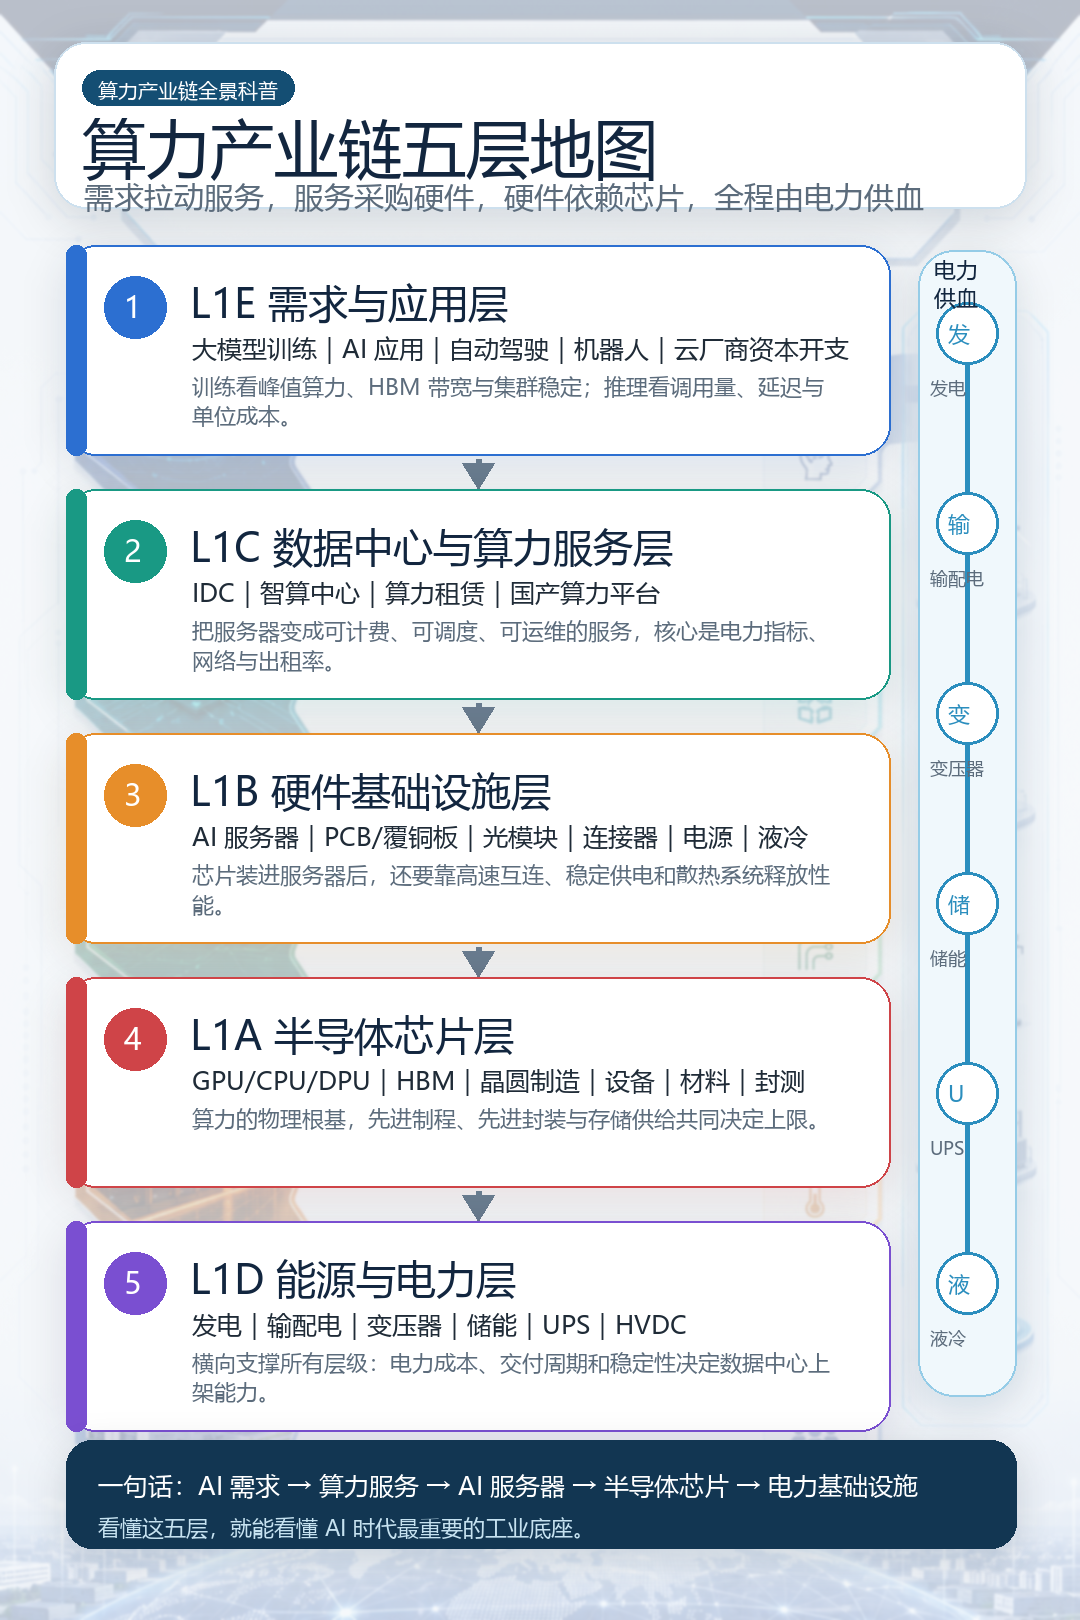
图一 · 算力产业链五层地图
很多人第一次听到“算力产业链”,脑子里浮现的可能是英伟达 GPU,或者是一排排数据中心机柜。
这都对,但都不完整。
真正的算力,不是某一张卡,也不是某一台服务器。它是一条横跨半导体、硬件、数据中心、电力和 AI 应用的长链条。
一次 AI 回答背后,大致要经过这样一条路径:
AI 应用产生需求 → 云厂商采购算力 → 数据中心部署服务器 → 服务器装入芯片、PCB、光模块、电源、液冷 → 芯片又依赖晶圆制造、设备、材料、封测、存储 → 全程消耗大量电力。
所以,理解算力产业链的第一步,是先把“GPU 中心论”放大成“系统工程论”。
算力产业链可以拆成五层:
需求与应用层:大模型、自动驾驶、机器人、行业 AI,决定算力为什么被需要。 数据中心与算力服务层:IDC、算力租赁、智算中心,把算力包装成可售卖的服务。 硬件基础设施层:AI 服务器、PCB、光模块、连接器、电源、液冷,把芯片组装成可运行的机器。 半导体芯片层:芯片设计、晶圆制造、设备、材料、封测、存储,提供算力的物理载体。 能源与电力层:发电、输配电、储能,像血液一样横向支撑全链。
如果只记一句话:
AI 需求拉动算力服务,算力服务采购硬件,硬件依赖芯片,芯片和数据中心都离不开电力。
一、需求层:谁在消耗算力?
算力产业链的源头,不在芯片厂,也不在服务器厂,而在需求端。
为什么 2023 年以后全世界突然加速买 GPU?不是因为 GPU 本身突然好卖,而是因为大模型把“算力”从工程资源变成了 AI 时代的基础设施。
算力需求主要分成两类。
这就是为什么云厂商资本开支是全链条的“总开关”。当微软、谷歌、Meta、亚马逊、阿里这类公司提高 AI 数据中心投入时,需求会沿着链条向上游传导:
大模型和 AI 应用 → 云厂商资本开支 → 数据中心建设 → AI 服务器采购 → GPU、HBM、光模块、PCB、电源、液冷需求 → 半导体设备和材料需求。
这个传导链有一个关键点:需求不是均匀传到每个环节的。越靠近瓶颈,弹性越大。比如 HBM 供给紧张,GPU 可能装不出来;先进封装产能不足,AI 芯片也无法出货;光模块跟不上,集群训练效率就下降;电力不够,服务器就上不了架。
这也是产业研究里最重要的判断:不要只看哪个环节“属于 AI”,更要看它是不是约束了 AI 的扩张速度。
二、服务层:算力怎样从“硬件”变成“服务”?
硬件造出来以后,还不能直接被使用。服务器要进机房,要接入网络,要接上电,要被调度系统管理,还要有商业模式对外收费。
这就是数据中心与算力服务层。
可以把这一层理解成算力的“房地产 + 物业 + 软件运营”。
这类生意的核心矛盾是:投入很重,折旧很快,算力价格会波动。如果能稳定拿到高端 GPU,或者能把国产算力做成可用平台,就有优势;如果设备闲置、租金下行,压力也会很大。
英伟达真正厉害的地方,不只是 GPU 硬件,而是 CUDA 生态。大量深度学习框架、算子库、开发工具、工程经验都围绕 CUDA 积累。国产芯片要真正进入生产系统,必须解决框架适配、编译器、迁移工具和开发者习惯问题。
换句话说,国产算力的“最后一公里”不只是芯片性能,而是软件生态。
三、硬件层:一台 AI 服务器里,谁最重要?
如果说数据中心是算力的房子,那么 AI 服务器就是房子里的发动机。
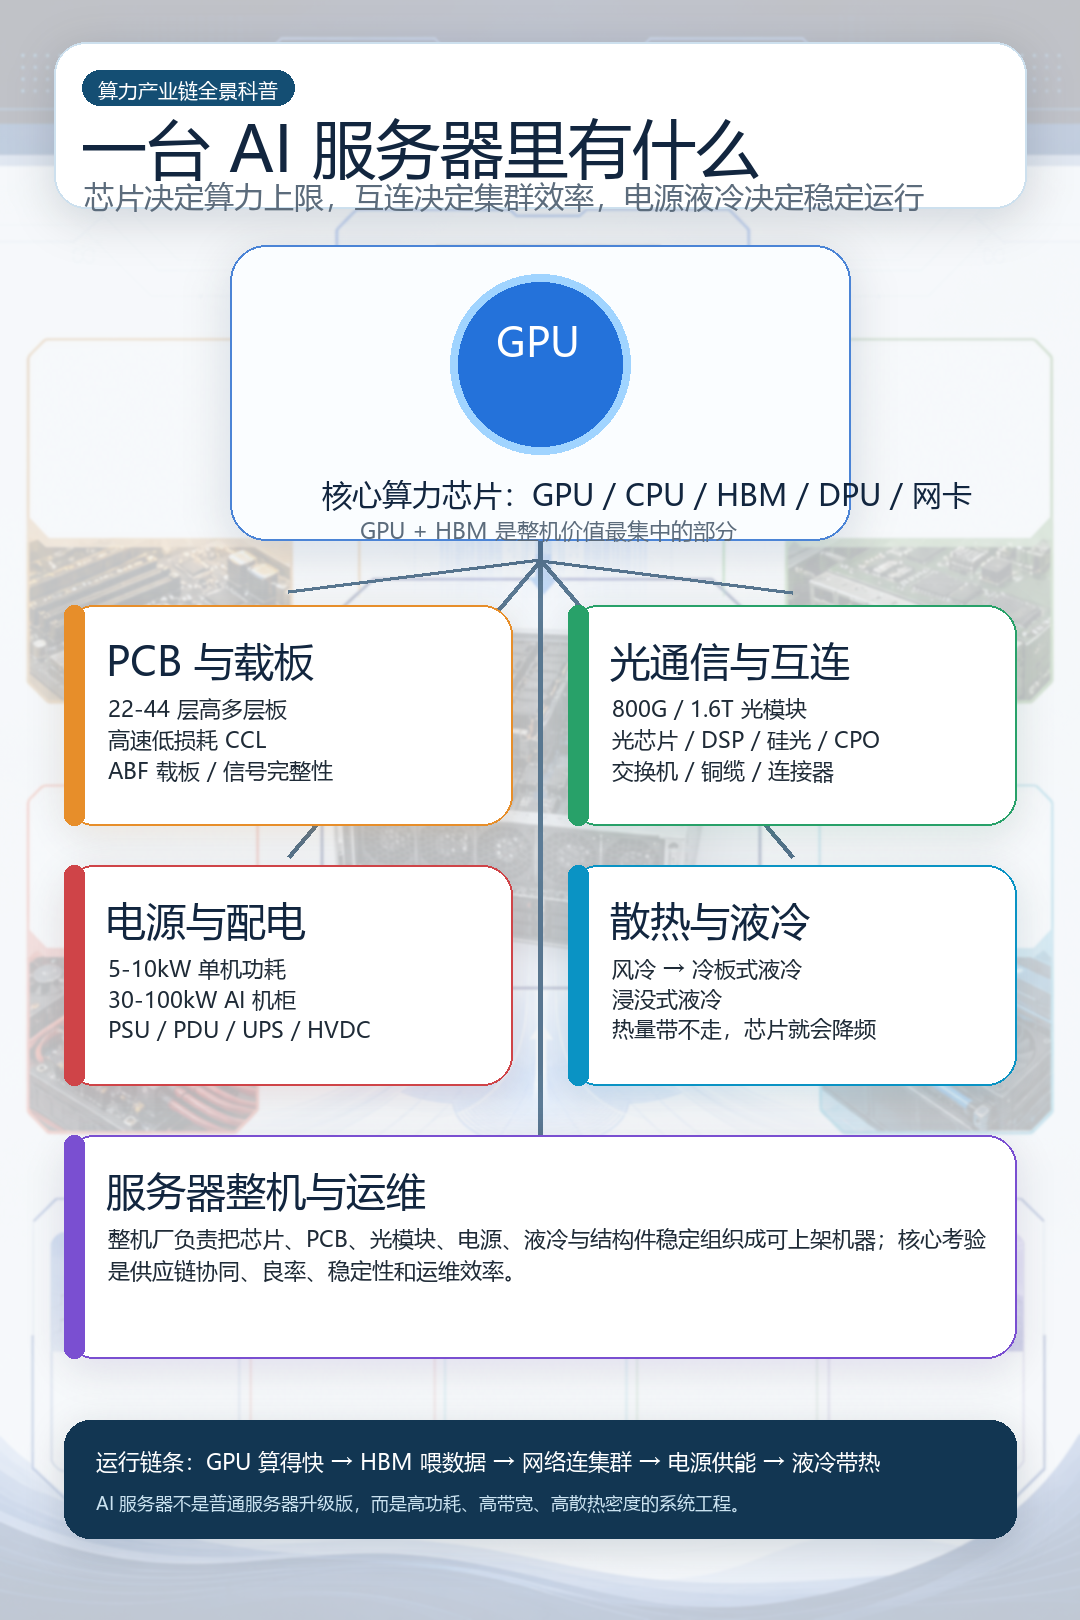
图二 · AI 服务器拆解
一台 AI 服务器不是普通服务器简单升级版,而是一个高功耗、高带宽、高散热密度的系统工程。
根据本地知识图谱里的拆解,一台 8 卡 H100 级 AI 服务器中,GPU 通常占整机价值的大头,HBM、网络、PCB、电源、散热和结构件共同构成剩余价值。整机厂的角色更像集成商:把芯片、PCB、光模块、电源、液冷和结构件稳定地组织到一台机器里。
这里有四个最值得普通读者理解的环节。
1. PCB 与覆铜板:服务器的神经骨架
AI 服务器内部信号密度非常高,PCB 不再只是普通电路板,而是高速信号的物理通道。
传统服务器的 PCB 层数大约 10 到 12 层,而 AI 服务器主板和载板可能达到 22 到 44 层。层数越高,对电子布、树脂、铜箔、硅微粉、覆铜板和加工良率的要求就越高。
所以 AI 服务器带来的不是“多买几块板”,而是把整条 PCB 材料链都往高频、高速、低损耗方向推。
这条链可以这样看:
电子纱 → 电子布 → 覆铜板 CCL → 高端 PCB → AI 服务器。
越往上游,扩产越慢,认证越长,短期供需弹性也越大。
2. 光通信:AI 集群的高速公路
单台服务器再强,也无法独立完成大模型训练。真正的大模型训练,是成千上万张 GPU 一起协作。
这时,网络就从辅助环节变成核心瓶颈。
光模块负责把电信号转换成光信号,让服务器之间高速通信。AI 集群从 400G、800G 往 1.6T 演进,光模块、光芯片、光器件、DSP、硅光、CPO 都被带进同一条升级路径。
简单说:
GPU 决定单卡算力,光通信决定多卡协同效率。
如果网络拖后腿,很多 GPU 就会在等待数据,昂贵算力无法充分释放。
3. 电源与配电:给算力喂电
AI 服务器的功耗是传统服务器的数倍甚至十几倍。H100、B200 这类高端 GPU 的功耗不断上行,一台 8 卡 AI 服务器可以达到 5 到 10kW 级别,一个 AI 机柜可以达到 30 到 100kW。
这会带来一连串变化:服务器电源功率提升,UPS 容量提升,PDU 和母线升级,机房变压器和配电架构也要跟着改。
过去电源是配角,现在电源决定服务器能不能稳定上架。
4. 散热与液冷:不用就跑不满
高功耗带来的另一面是高热量。
风冷大致适合传统服务器和中低功耗机柜,但 AI 机柜功率密度上来以后,冷板式液冷和浸没式液冷开始从可选项变成必选项。
液冷不是概念升级,而是物理必然:热量带不走,芯片就会降频;长期热管理失效,稳定性和寿命都会受影响。
这也是为什么 AI 数据中心的建设,越来越像“电力工程 + 暖通工程 + 网络工程 + 计算工程”的复合项目。
四、芯片层:算力的物理根基
如果继续往上游追,就到了半导体芯片层。
这一层是技术壁垒最高、国产替代难度最大、产业链也最复杂的一层。
理解半导体,先记住一个基础分工:
芯片设计负责画图纸,晶圆制造负责把图纸刻进硅片,封装测试负责把裸片变成可用芯片。
围绕这件事,又长出设备、材料、存储等关键环节。
1. 芯片设计:定义芯片“做什么”
芯片设计公司通常是 Fabless 模式:不建晶圆厂,只做架构、逻辑、电路和验证,然后把设计交给代工厂生产。
在算力链里,最重要的设计品类包括:
GPU 和 AI 加速芯片:承接训练和推理算力需求。 CPU:负责通用计算、任务调度和系统控制。 内存接口芯片:连接 CPU/GPU 与 DDR/HBM。 光芯片:服务光通信链条。 DPU、FPGA、模拟和电源管理芯片:分别服务网络卸载、可编程计算和电源系统。
但设计不是孤岛。它严重依赖 EDA 工具、IP 授权、先进制程、HBM 和先进封装。尤其高端 AI 芯片,本质上是“架构设计 + 先进制造 + 高带宽存储 + 先进封装 + 软件生态”的组合结果。
2. 晶圆制造:把设计图刻进材料
晶圆制造是重资产生意。它不是单纯“代工”,而是一套由上百道工序组成的精密工业系统。
光刻、刻蚀、薄膜沉积、离子注入、清洗、CMP、量测,每一步都可能决定良率。
对国产算力来说,先进制程是最难的问题之一。芯片设计可以快速迭代,但制造能力、良率爬坡、设备材料自主化,都需要多年积累。
所以,高端 AI 芯片的真实瓶颈,往往不在“能不能画出设计图”,而在“能不能稳定制造、封装并量产”。
3. 半导体设备:制造芯片的机床
设备是晶圆厂扩产的先行指标。
一个晶圆厂要扩产,首先要买设备。设备订单领先产能,产能再领先芯片出货。因此设备是观察半导体周期的重要入口。
半导体设备主要包括:
光刻机:图形转移核心,先进制程最强瓶颈。 刻蚀设备:把图形刻进材料,先进制程步骤数上升。 薄膜沉积设备:CVD、PVD、ALD,负责沉积各种功能薄膜。 CMP 设备:负责平坦化。 量测设备:良率守门人。 涂胶显影、清洗、离子注入、炉管、测试设备等。
这里有一个重要区别:设备是一次性资本品,材料是持续消耗品。设备看扩产和订单,材料看晶圆出货和复购。
4. 半导体材料:制造过程的弹药
半导体材料覆盖硅片、光刻胶、电子特气、湿电子化学品、CMP 材料、靶材、前驱体、掩膜版等。
材料的难点不在“有没有基础化工原料”,而在能否达到半导体级纯度、稳定性和客户验证要求。
例如光刻胶不是普通胶水,电子特气不是普通工业气体,前驱体不是普通化学品。它们要进入晶圆厂量产线,通常要经历长周期认证,一旦进入工艺菜单,粘性也会较强。
5. 封装测试:从后道变成新瓶颈
过去封装常被认为是低价值后道环节:把裸片保护起来、引出引脚、做测试。
AI 时代,这个认知要更新。
先进封装开始承担芯片间互连、异构集成、散热和信号完整性等系统级功能。GPU 与 HBM 通过 CoWoS 类 2.5D 封装连接,Chiplet 依赖更复杂的封装与测试体系。
这意味着:当摩尔定律放缓,先进封装正在成为延续性能的第二战场。
6. 存储:HBM 是 AI 的关键物理瓶颈
存储是半导体里一个特殊子链。DRAM、NAND、HBM、存储模组都属于这里。
其中最关键的是 HBM,高带宽存储。
普通内存像一排平房,HBM 更像把多层 DRAM 垂直堆起来,再通过 TSV 和先进封装与 GPU 高速连接。它解决的是 AI 芯片的“喂数据”问题。
GPU 算得再快,如果数据喂不上来,也会等待。
所以 HBM 不是普通存储升级,而是 AI 计算系统的核心瓶颈之一。它同时横跨存储制造、先进封装和 GPU 设计,是理解 AI 芯片供应链的关键交叉点。
五、电力层:算力的尽头,真的是电
当我们把链条从 AI 应用一路追到芯片,再追到服务器和数据中心,就会发现一个朴素事实:
算力越强,耗电越大。
本地知识图谱对 L1D 能源电力层的定位很准确:它不是产业链末端,而是横向支撑全链的“血液”。
电力约束主要体现在三处。
其中一个容易被忽略的环节是变压器。AI 数据中心需要大量干式变压器和电力变压器,全球变压器产能紧张时,数据中心扩张会被电气设备交付周期卡住。
这也是“算电协同”的本质:
算力选址 = 电力成本 + 网络延迟 + 土地指标 + 监管约束的综合平衡。
东部靠近用户和应用,西部有能源和土地优势。“东数西算”并不是一句口号,而是电力传输和数据传输之间的系统优化。
六、把全链串起来:从一粒沙子到一次 AI 回答
我们现在把这条链按一次 AI 回答的旅程串起来。
第一步,AI 应用收到用户请求,产生一次推理需求。
第二步,请求进入云厂商或模型服务商的数据中心,被调度系统分配到某个 GPU 集群。
第三步,GPU 集群开始计算。它依赖 AI 服务器,服务器内部有 GPU、CPU、HBM、网卡、PCB、电源和液冷系统。
第四步,多台服务器之间通过光模块、交换机、连接器和铜缆高速通信,避免 GPU 空等。
第五步,这些服务器部署在 IDC 机房中,消耗稳定电力,并由散热系统持续带走热量。
第六步,服务器中的芯片来自更上游的半导体链条:芯片设计、晶圆制造、半导体设备、半导体材料、封装测试和存储。
第七步,这些芯片、服务器和数据中心背后,又依赖发电、输配电、变压器、储能和电网调度。
所以,一次 AI 回答看似发生在屏幕上,实际上牵动的是:
软件需求、云服务、服务器制造、光通信、PCB、电源液冷、半导体制造、先进封装、HBM、设备材料、电力基础设施。
这就是算力产业链的全景。
七、五个最值得盯住的瓶颈
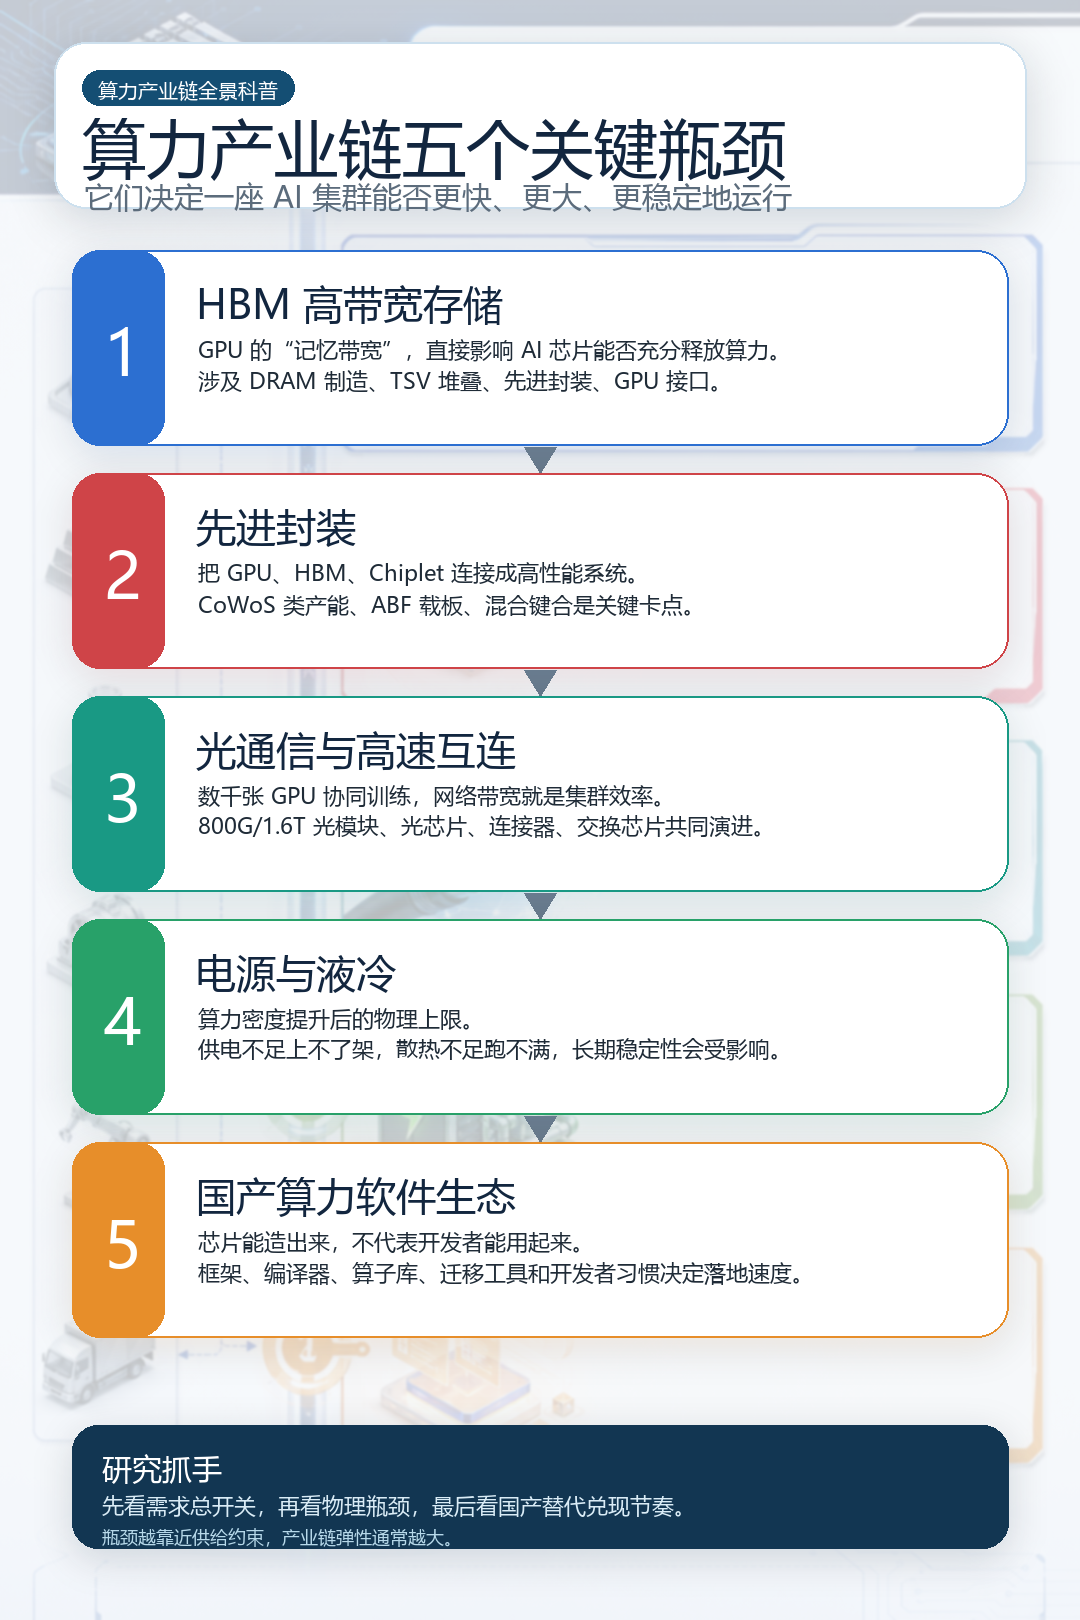
图三 · 算力产业链关键瓶颈
一条产业链很长,但研究时不能平均用力。真正决定产业弹性的,是瓶颈。
1. HBM:GPU 的记忆带宽
HBM 决定 GPU 能否获得足够数据。没有 HBM,GPU 可能有算力但喂不饱。它横跨 DRAM 制造、TSV 堆叠、先进封装和 GPU 设计,是 AI 芯片供应链里最关键的交叉点之一。
2. 先进封装:AI 芯片的系统集成
AI 芯片不再只是单颗大芯片,而是 GPU、HBM、Chiplet、载板、中介层、散热和测试共同构成的系统。先进封装产能不足,会直接影响高端 AI 芯片出货。
3. 光通信与高速互连:集群效率
训练大模型不是一张卡的事,而是集群协作。光模块、光芯片、铜缆、连接器、交换芯片和 CPO 决定集群内部数据流动效率。
4. 电源与液冷:物理上限
算力密度提高后,供电和散热从配角变成硬约束。供电不足,服务器上不了架;散热不足,芯片跑不满。
5. 国产算力软件生态:最后一公里
芯片能造出来,不代表开发者愿意用。CUDA 生态是英伟达最深的护城河。国产算力要落地,必须解决框架、编译器、算子库、迁移工具和开发者习惯。
八、普通读者怎么读这条链?
如果你不是半导体工程师,也不用被几十个专业名词吓住。看算力产业链,可以抓三条主线。
如果把算力产业链想成一座城市:
一座城市的效率,不取决于单点最强,而取决于所有关键系统是否协同。
算力也是如此。
结语:理解算力产业链,就是理解 AI 的工业底座
AI 看起来像软件革命,但它背后是一场硬科技和基础设施革命。
大模型让算力需求爆发,算力服务把需求商业化,AI 服务器把芯片变成机器,半导体链条提供物理根基,电力系统决定上限。
这条链的迷人之处在于,它既有最前沿的模型和软件,也有最传统的电力、铜、玻纤、化工、机柜、冷却液。它把“数字世界”和“物理世界”紧紧拧在了一起。
所以,下一次看到“算力”这个词,不妨把它翻译成一句更完整的话:
算力不是某张 GPU 的性能,而是从需求、服务、硬件、芯片到电力的全系统交付能力。
看懂这张图,就看懂了 AI 时代最重要的产业骨架之一。
文中涉及的功耗、PCB 层数、速率代际、价值量占比等,均用于产业链科普解释,不作为实时市场数据或投资判断依据。
本文仅为算力产业链科普性介绍,基于公开资料和本地研究文档整理,不构成任何投资建议。文中提及的公司或环节仅用于解释产业链位置,不构成推荐或交易指引。股市有风险,投资需谨慎。

相关文章


