



导语:只要提到人工智能,大家下意识就会蹦出"算力""GPU""国产替代"这几个词,但真要问"算力到底是什么",不少人会愣一下,然后说:"就是显卡呗。"今天这篇文章,想把这件事从头到尾捋清楚。
算力,字面意思就是"计算的能力"——单位时间内能算多少。
在人工智能里,它特指训练和推理模型需要的运算能力。模型要处理海量参数和矩阵运算,算力就是驱动这些运算的"马力"。
最管用的一个类比:算力像"电力",不绑定任何发电机。 你说"这栋楼电力足",指的是供电能力,不会特指是火电、水电还是核电;同理,"这家公司算力强",指的是总计算能力,不特指是 GPU、CPU 还是 NPU 提供的。
所以第一个要建立的认知是:算力是个抽象的能力,不是某块硬件。硬件只是把能力"实体化"的载体。 这一点想通了,后面一大半误解就消失了。
二、算力,可不是一个数字那么简单
很多人以为"算力 = 买几张显卡",这是把问题看扁了。完整看算力,至少有四个维度:
第一,训练还是推理? 训练是从数据里"炼"出模型,像学生埋头苦学,最吃硬件;推理是拿现成模型"跑"出结果,像考试答题,省劲得多。所以推理侧国产替代早已跑通,训练侧才是硬骨头。
第二,峰值还是可用? 芯片手册写的"X TFLOPS"是理想上限(峰值),真实能用多少,要看卡与卡之间传数据快不快(互联带宽)、软件实现得好不好(软件栈)、几千张卡能否齐步走(集群调度)。"买 1000 张卡"不等于"有 1000 张卡的算力"——华为用 384 张 910C 组超节点去追英伟达 72 张卡的机柜,就是典型的"用系统补单卡"。
第三,整条技术栈通不通? 回忆"盖楼"的比喻:你写模型的框架(PyTorch、MindSpore)是装修层,把下面的算子库(cuDNN、CANN)、运行时(CUDA、NCCL)、硬件(GPU、NPU)一层层托着。任一层掉链子,顶层算力就上不去。"有卡"和"有用"之间,差着整个软件生态。
第四,在什么精度下? 同一块芯片,单精度、半精度、整数、FP8 下的算力天差地别。谈算力不谈精度,数字没有可比性。
*TFLOPS :是衡量计算机浮点运算能力的单位,表示每秒可执行一万亿次浮点运算,常用于评估 GPU、超级计算机和高性能 AI 芯片的计算性能 主要用于模型训练。
*TOPS:衡量整数运算能力,处理离散整数值(如 0、1、-3),适用于 AI 推理等对精度要求不高的场景
三、硬件拆开看:GPU、NPU,还有那个总被搞混的 SoC
先把"硬件形态"说清,再逐个拆。
SoC(系统级芯片),简单说就是把 CPU、GPU、NPU、图像处理器全塞进一颗芯片,等于把一台电脑主板微缩焊进一颗。GPU 和 NPU 是"功能引擎"(专门干某类活的车间),它们有两种存在形态:一种是独立加速卡(如 H100、昇腾 910,插在主板上,旁边另有 CPU,用在云端);另一种是集成在 SoC 内(如 RK3588 里的 6 TOPS NPU、英伟达 Thor,用在端侧、具身、车载)。
所以记住:云端比的是"单卡峰值 + 集群",端侧比的是"整颗 SoC 的平台能力"(算力、功耗、是否算控一体)。 别把"功能单元(GPU/NPU)"和"集成平台(SoC)"混成一维。
图:SoC 与 GPU/NPU 的关系——集成形态 vs 独立形态

回到具体硬件:
•CPU:通用但非专长,负责控制流、数据预处理、调度,不可或缺。
•NPU / ASIC:国产突围的主战场。华为昇腾(全栈自主,国产第一)、寒武纪思元(推理专精)、海光 DCU(类 CUDA、迁移成本低)、昆仑芯、沐曦、摩尔线程、壁仞;端侧还有地平线、黑芝麻,以及前面说的瑞芯微 RK3588。
•TPU:谷歌自家云端专用芯片,不外售。
•FPGA:可重构,灵活但小众。
•分布式集群:把上面所有东西连起来。单卡有限,大模型要成千上万张卡并联——互联技术和跨节点网络,才是大模型算力的真正瓶颈。
四、具身智能芯片
具身智能,就是机器在真实环境里完成"感知—判断—行动"闭环(不限于人形,车、工业平台都算)。它的芯片长什么样?看这张梯队表:
看具身芯片,要看四件事:算力单位、精度、功耗(风冷通常要 <30W)、是否算控一体。
五、这几个说法,别再被带偏了
•"买多少张卡就有多少算力"——错。峰值不等于可用,系统工程决定到手多少。
•"国产完全替代不了英伟达"——不全对。边缘/端侧替代最成熟,云端推理已规模化,大模型预训练虽有 2–3 年代差,但差距在缩小,"双底座并行"已不可逆。
图:国产 AI 算力替代成熟度梯度(2025–2026)
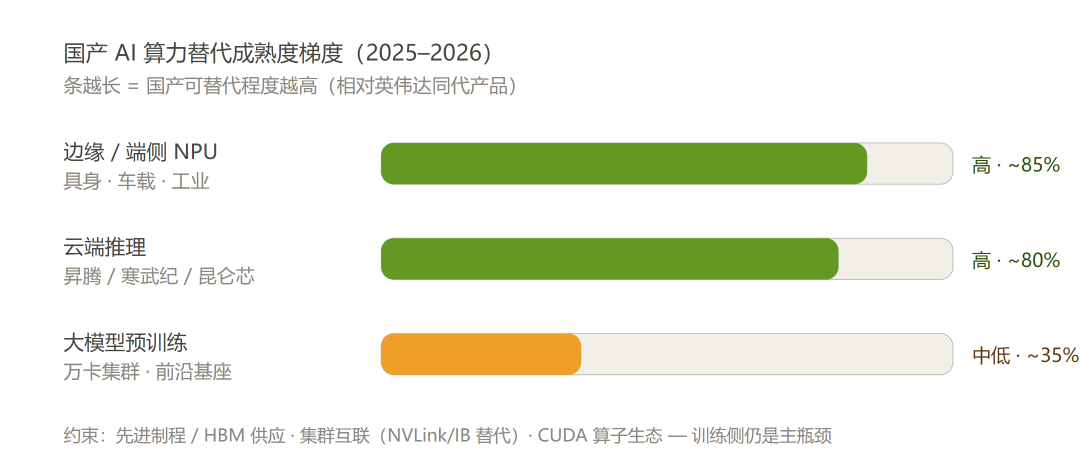
图:CUDA 栈 vs 昇腾 CANN 栈——互操作断点

六、写在最后:给产业研究者的几点提醒
算力之争,本质上是"软硬协同"与"自主可控"两条线的博弈。看懂了这套逻辑,再看任何一份 AI 产业报告,你都能判断它到底在说什么。落到研究动作上,记住五点:
2.国产替代要分层判断,训练、推理、边缘三线进度不同;
3.双栈互操作摩擦是真实痛点,可作"自主可控有代价"的平衡论证;
4.具身、天基这类场景,端侧优先国产 NPU 窗口更好;云端前沿训练若依赖 CUDA,要预算 3–6 个月的迁移适配成本;
5.看芯片别只看峰值,单位、精度、功耗、算控一体,四个维度一起看才靠谱。

相关文章


