



无需密码、不靠指纹,一句话即可轻松完成身份核验
咳咳~~想象一下,清晨,你走进车库,打开车门,对着方向盘轻声道:“导航去公司!” 话音刚落,车子就像被施了魔法,不仅规划出最佳路线,还贴心地把座椅、空调和后视镜都调到了你最舒服的状态。这一切,皆因它能辨识你的声音,而你的声音,便是那独一无二的“通行密钥”!这并非科幻电影桥段,而是声纹识别技术落地的真实场景。
而且,它的能力不止于此。在刑侦破案中,一段模糊的录音经过声纹比对,就能帮助警方锁定嫌疑人,让那些“隐形凶手”无所遁形。这一切的背后都是声纹识别技术的“神奇魔力”。大家可能都很好奇:AI怎么能在嘈杂的环境中只听你的指挥呢?在看不见也摸不着的声音里,它又是怎么识别“你是谁”的呢?接下来,让我们一探究竟。
技术演进:从“语谱图”到“深度神经网络”
声音如何成为身份密码?
声纹的概念,最早可追溯至 1941 年贝尔实验室的研究。
最初,它指的是借助科学仪器分析、显示出来的语音图像——语谱图。如同指纹在刑侦领域的独特地位,声音的这种可视化“纹路”被形象地称为“声纹”。
声音之所以能成为识别身份的可靠依据,源于其四大核心特性:
接下来,我们一起看下声纹识别技术发展进程:
声纹识别技术的发展,是一部浓缩的 AI 进化史
第一阶段(2000年前):基于信号比对的模板匹配。这是最早期的方法,如同比对两幅图片是否完全相同,要求说话内容必须一致,实用性受限。
第二阶段(2000-2009年):基于高斯混合模型(GMM)。进入统计学习时代,模型不再依赖特定文本,实现了“文本无关”的识别,但需要较长的注册语音,且抗噪声能力较弱。
第三阶段(2010年左右):i-Vector/PLDA算法。引入了更先进的信道补偿技术,试图消除不同录音设备、环境带来的干扰,提升了跨场景的鲁棒性。
第四阶段(2011年至今):深度神经网络(DNN/CNN)时代。当前的主流与前沿。通过深度神经网络,直接从海量语音数据中学习并提取高度抽象、区分性极强的说话人特征向量。
这种方法对噪声和信道变化表现出极强的免疫力,识别精度实现了质的飞跃,但也对训练数据的规模与质量提出了极高要求。
目前,行业领先的技术方案,通常采用如 ResNet、RepVGG 等先进的 CNN 网络结构,将输入的语音转化为语谱图,再由网络层层抽象,最终提取出一个具有唯一表征性的固定维度“声纹 ID”向量。
这个向量,便是声音的“数字DNA”,是后续一切比对、检索的基石。
核心解码器:声纹识别系统的双重逻辑架构
声纹识别任务主要分为两大类,对应两种不同的应用逻辑:
声纹 1:1 确认(说话人确认)
这解决的是 “这是你吗?” 的问题。系统将待验证的语音与已注册的单一目标声纹进行比对,计算两者声纹特征的相似度得分。
若得分超过预设阈值,则确认为本人,反之则拒绝。这类似于人脸解锁手机的过程,是一对一的身份验证。
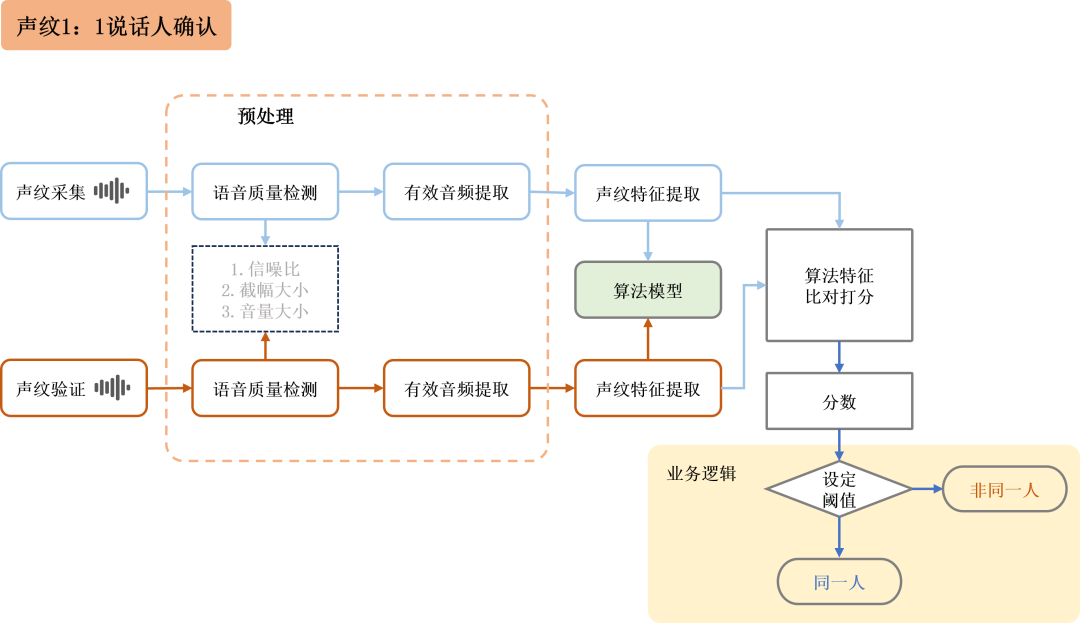
EASEAI声纹1:1比对流程
声纹 1:N 辨认(说话人辨认)
这解决的是 “你是谁?” 的问题。系统需要将一段未知语音,在一个包含 N 个已知身份的声纹底库中进行检索和比对。
通过计算与库中每个声纹的相似度,并按照分数高低排序,最终给出最可能的一个或几个候选身份。这如同在千万级人口数据库中排查一名嫌疑人,是一对多的身份查找。
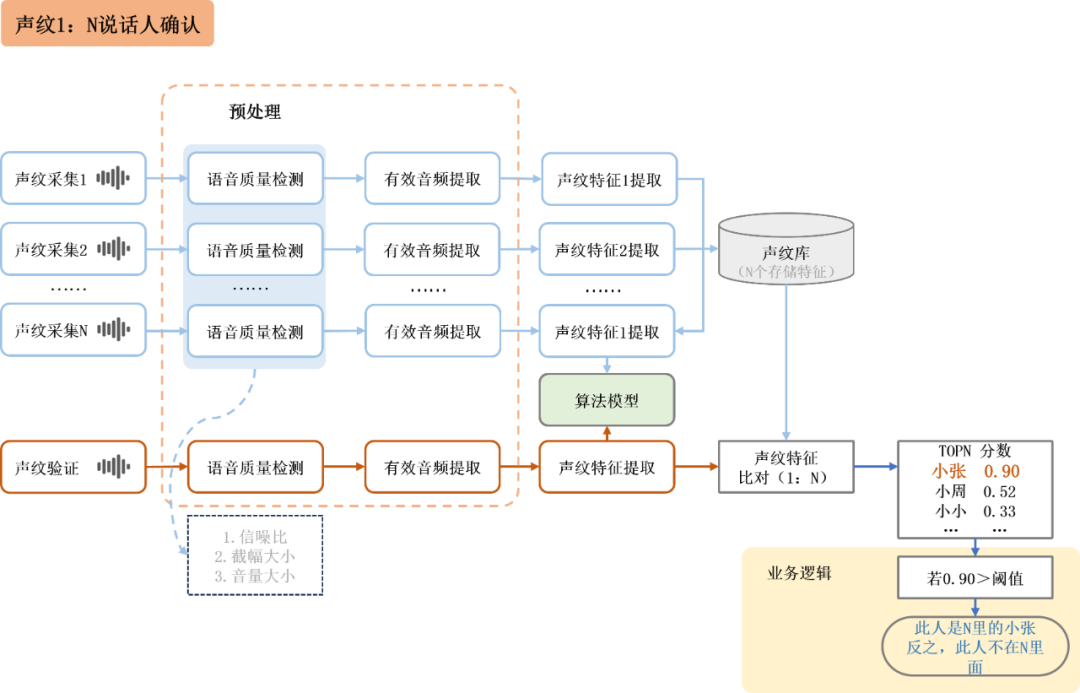
EASEAI声纹1:N检索流程
如何衡量技术的优劣?关键看两个核心指标:
对于 1:1 确认,核心指标是等错误率(EER)
它衡量的是错误接受率(FAR,把冒名顶替者当成你)和错误拒绝率(FRR,把你本人拒之门外)达到平衡时的错误率。EER 越低,系统性能越卓越。行业顶尖水平已在部分场景下将 EER 降至 1% 以下。
对于 1:N 辨认,核心指标是TOP-N 命中率
例如,在百万量级的声纹库中搜索,若正确的说话人出现在相似度排名前10的结果中,则计为一次 TOP10 命中。TOP1、TOP5、TOP10 的命中率越高,说明系统在大规模辨认中的精准度和实用性越强。
攻坚克难:行业如何突破技术瓶颈
实现精准识别?
前沿模型结构创新:持续探索并落地更高效、更强大的网络结构,创新的融合Transformer架构、Conformer架构、U-Net结构等技术,让网络学习到类内高内聚、类间低耦合的声纹特征,从根本上提升模型的判别能力。
海量多源数据与数据增强:声纹模型的“智慧”离不开高质量的数据,语亦思科技通过采集电话、微信、麦克风等多渠道、多场景的海量语音数据,并利用数据增强技术对平行数据进行有效扩充,为高精度模型打下坚实基础。
短语音识别瓶颈:在客服、智能眼镜中移动支付等场景,用户语音往往很短(如“好的”、“确认支付”)。传统模型在短语音上表现会急剧下降。语亦思科技融合多种声学特征进行多维度对齐融合,并对神经网络结构进行针对性改进(如多网络融合),大幅提升短语音的识别效果。
跨信道适配难题:市面上很多算法在同信道比对中效果尚可,但在实际业务场景中,样本语音和待比对语音往往来源于不同信道,如样本语音来源于电话信道,但待比对语音来自于微信道,这在很大程度上影响了业务的实际应用,语亦思科技通过引入预训练和特征空间多维映射技术,让模型学会“忽略”信道差异,专注于说话人本身的特征,从而在跨设备、跨环境比对中依然保持极高的识别精度。
语亦思科技提供全球领先的声纹识别技术,涵盖声纹注册、声纹1:1、声纹1:N及声纹n:N比对等全方位服务,精准提取并验证说话人的声纹特征,以高效确认和辨认说话人身份。同时,我们具备极强的工程化能力,支持亿级声纹数据库系统的建设,在模型算法、引擎封装、接口服务、集群支持、国产化等多维度实现全面领先。
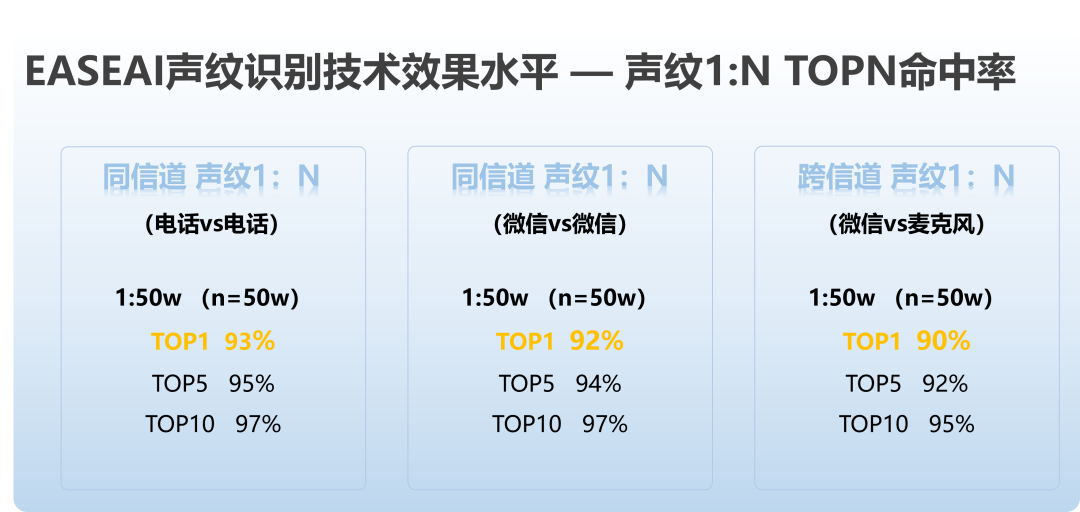
EASEAI声纹识别技术效果——声纹1:N TOPN命中率
落地赋能:从公共安全到智能生活
声纹技术如何改变世界?
声纹技术正在从单点工具进化为基础设施,在三个维度构建新的社会技术生态:
公共安全维度:从被动响应到主动防御的范式升级
在反电信诈骗领域,声纹技术正构建四级防御体系:
黑名单实时拦截:建立涉诈声纹库,实时比对来电语音
灰名单风险预警:对疑似诈骗模式进行标记和人工审核
案件智能串并:通过声纹碰撞分析,将孤立案件关联成团伙作案网络
跨境协同一体化:建立区域声纹共享机制,提升跨区域打击效率
金融安全维度:重新定义远程身份验证标准
金融行业正在经历从“你知道什么”(密码)到“你是什么”(生物特征)的验证革命。声纹识别因其非接触、防篡改、易集成的特性成为首选:
智慧银行场景:声纹登录使认证时间从45秒缩短至3秒,用户流失率降低60%
信贷风控系统:贷前审核中声纹比对可发现30%的团伙欺诈尝试
保险反欺诈:通过理赔录音声纹分析,某保险公司识别出12%的骗保案件
跨境支付:Visa等机构正在测试声纹验证,跨境转账欺诈率有望降低75%
物联网维度:从设备智能到个性化智能的跨越
在智能家居、车载、穿戴设备领域,声纹正在实现真正的“以人为中心”:
多用户情境感知:家庭音箱根据不同成员声纹,提供个性化内容推荐和隐私保护
车载自适应系统:通过声纹识别驾驶员,自动调整座椅、空调、歌单及驾驶模式
工业安全管控:在危险作业区域,通过声纹确保只有授权人员可操作设备
无障碍交互:为视障用户提供声纹锁定的个性化语音助手,防止误操作
EASEAI声纹识别技术创新之旅——探索声纹技术的无限可能
未来,当生活娱乐融入我们的声纹识别技术,会碰撞出怎样的火花呢?让我们一同放飞想象,大胆猜想那些令人兴奋的新场景吧!

相关文章


