



大模型时代,我们对信息的搜集和处理需求被极大地释放了。无论是以AI录音卡为代表的语音记录硬件,还是以AI陪伴、AI助手为代表的自然语音交互,大家正以不同的方式,在人与人、人与AI之间进行着海量的信息置换和传递。
无论你是一个普通用户还是一个创业者,当你躬身入局,亲自深度使用或者下场做一款AI产品的时候就会发现:“不当家不知道柴米油盐贵”。无论是AI陪伴还是会议记录工具,AI服务的长期成本,如果没有一个完美的商业模式来支撑,真的是用的越多,亏得越多!
当市场需求在快速增加,但底层成本还居高不下的时候,往往意味着变革的开始,必然会有新入局者搅动这个市场。
一个小时的AI会议记录,成本到底有多少?
首先,我们看一下AI录音卡(Plaud)的会员机制:
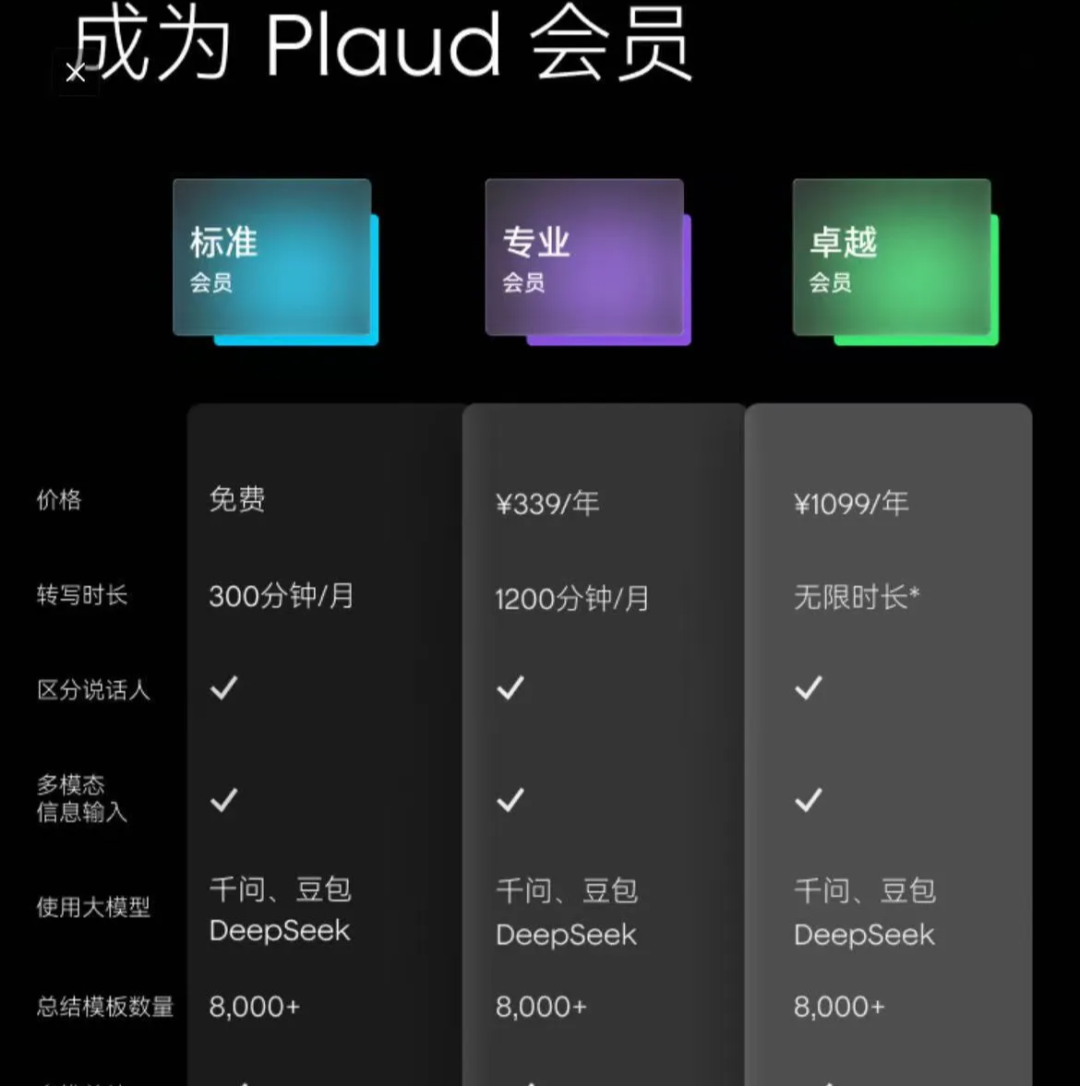
Plaud的会员收费
它的专业会员一个月订阅费是28元,包含20小时额度,折算下来单价是 1.4元/小时。
那么,用AI处理一个小时的会议,真实的云端服务成本到底是多少呢?我们硬核地来算一笔账。
一般一个小时的会议,粗略按照40分钟有效讲话时长计算(去除停顿和静音)。正常人的语速差不多是1秒钟5个字,40分钟差不多是 40 * 60 * 5 = 1.2万字。
我们按照一个汉字1.5个Token来计算,一个小时的会议差不多可以产生1.8万的输入Token,再加上System Prompt(系统提示词),我们宽裕点按2万Token来算。(其实我自己实际使用下来,一个小时的会议根本用不了2万Token。)
输出Token的消耗,则和你定制的总结提示词以及想要提取的信息量有关。但一般也就是一两千字,太长了也没有阅读意义。假如按2000字算,输出Token差不多就是0.3万。
我们按照 Deepseek V4 Flash 版本的API价格来计算,每百万Token输入是1块钱,输出是2块钱。
总结一下,一场一个小时的会议下来,调用AI大模型的费用如下:
输入Token 大约2W,成本 0.02元; 输出Token 大约0.3W,成本 0.006元; 总成本仅为:0.026元!
你看,大模型的处理费用才不到3分钱! 那么剩下高昂的成本去哪儿了?
没错,全在语音识别(ASR)上!
我们看一下国内两个头部云厂商的语音识别API价格:
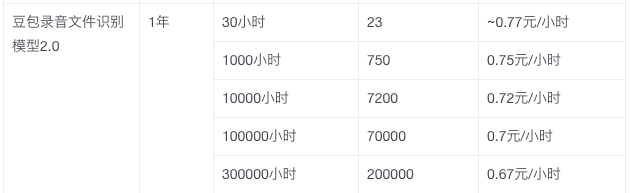
豆包的录音文件识别API价格
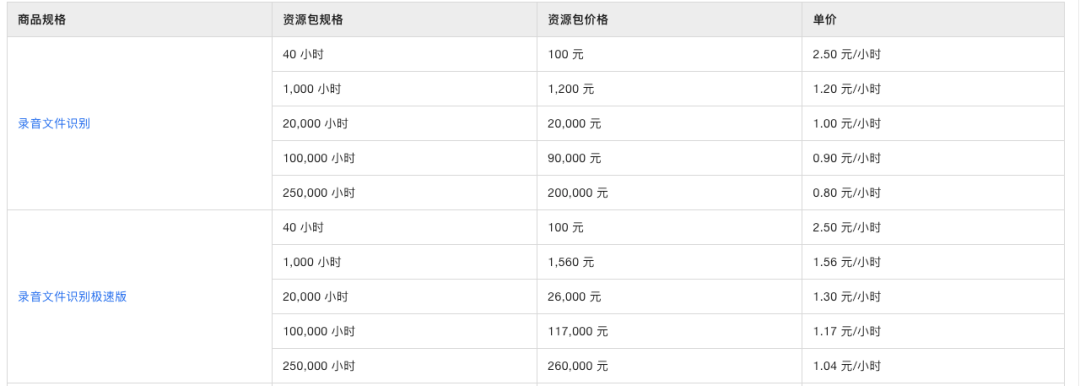
阿里云的录音文件识别API价格
最便宜、最优惠的单价也要 0.67元/小时。而且别忘了,这里还没有算云服务的并发费用。当API使用量大了之后,并发费用绝对是一个不能忽略的庞大数字。
一目了然,一次AI会议转录最核心的成本,根本不在大模型,而是在前置的语音识别服务上。
传统的API定价,明显落后于时代了
互联网上的公开数据已经越来越不值钱了,它们早就被压缩、吸收进了各大模型中。而每个人每天真实听到、看到的事情,才是最稀缺、最重要的。
这必然也是将来AI发展的一个核心方向——个性化AI(Personal AI)。
为什么抖音、小红书逐渐抢占了百度等传统搜索引擎的时间?不就是这个道理吗。当一个应用通过算法把用户留住,用户画像越来越精准,体验也就越个性化。相比之下,那种只有等用户有需求时才去主动搜索的平台,自然就没落了。
作为强大的生产力工具,大模型把信息处理的效率提高了几个量级,极大地解放了人们提取知识的效率。这就意味着,我们需要把更多真实的“原材料”投喂给模型。这也就是为什么近两年AI录音卡、便携记录硬件(比如Looki)能够应运而生——大家抢占的都是大模型的上游,即最核心的个性化私有数据。
我们单看语音这一个维度。假如一个人一天录制8个小时的语音,按照上面的云端API价格计算,一个小时六毛钱,一天将近5块钱。那么一年的语音识别云服务费就要1800块钱,接近2000元!
别说普通用户了,就是高频重度办公用户,也未必愿意每年为此持续掏2000块钱。短期来看,对于高需求用户,API调用的确过于昂贵;而在新的商业模式还没跑通之前,云厂商也不太可能大幅降价。
面临这种行业困局,我们该怎么解决呢?
充分利用端侧闲时算力和开源力量
这是目前实现降本增效最好的方式。
什么是我们端侧的闲时算力?就是我们每天都在用的智能手机和个人PC。
我个人认为,目前的个人端侧算力是严重过剩的。
比如对于一台办公用的Mac来说,平时我们主要用它处理一些基础的工作事务,它内部强大的芯片算力实际上长期处于闲置状态。如果能够充分将这些闲置算力利用起来,就能极大地降低AI服务的边际成本。
另一方面,越来越多的用户开始习惯“Always On(全局常开)”的记录方式,因为这样没有主动开关机的心理负担。但随之而来的,是极其敏感的数据隐私安全问题。这时候,我们更加需要让数据在端侧(本地)进行闭环处理。
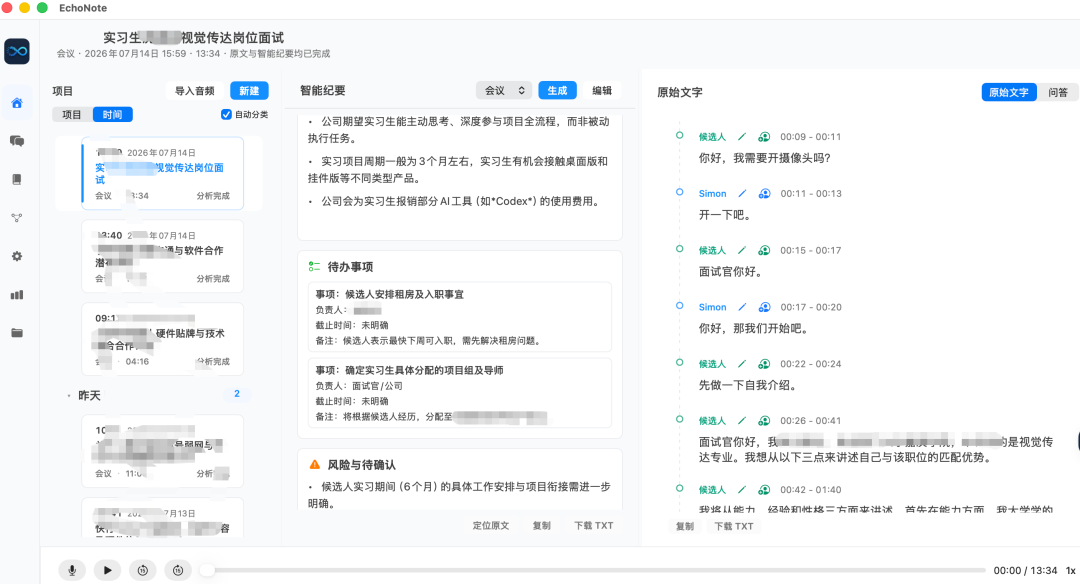
以我个人的痛点为例:我每天有大量的会议需要参加——面试、日会、周会、对接客户等等。很多时候客户说“我们今天的需求主要有三个”,等他说完第三个的时候,前两个我已经忘了。 所以高质量的语音记录和AI总结绝对是刚需。
但市面上录音卡的持续订阅费对我来说确实太贵了。因此,我们团队自己动手开发了一款桌面端产品。
我们将热词引擎、声纹识别、语音识别(ASR)全部集成在端侧,实现本地部署运行,在Mac上跑起来毫无压力。
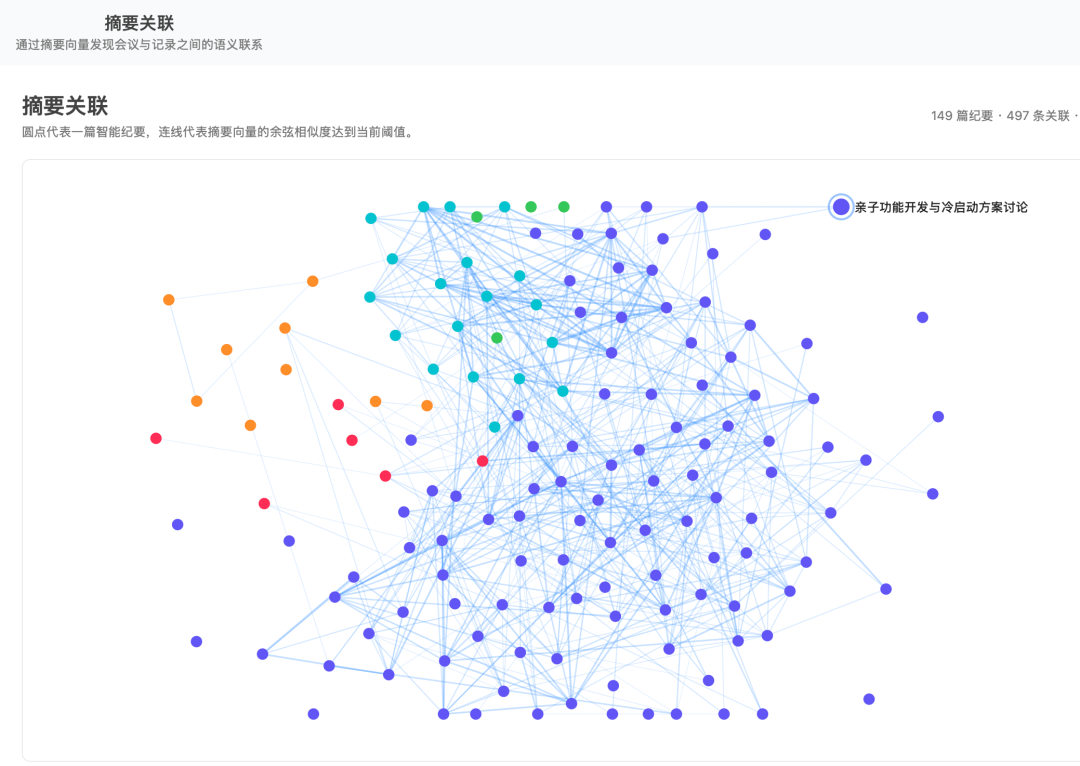
每天的会议纪要及其关联性,一目了然,完全本地化,安全又高效。
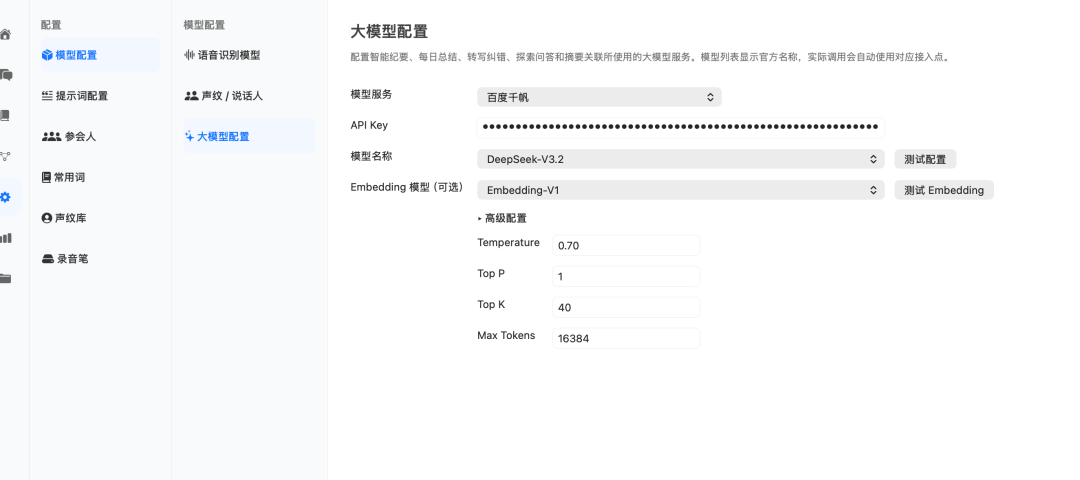
大模型部分则按需充值,总结提示词(Prompt)模板可以根据自己的工作流随意定制。每天、每周、每月消耗了多少Token,账单都清清楚楚、明明白白。
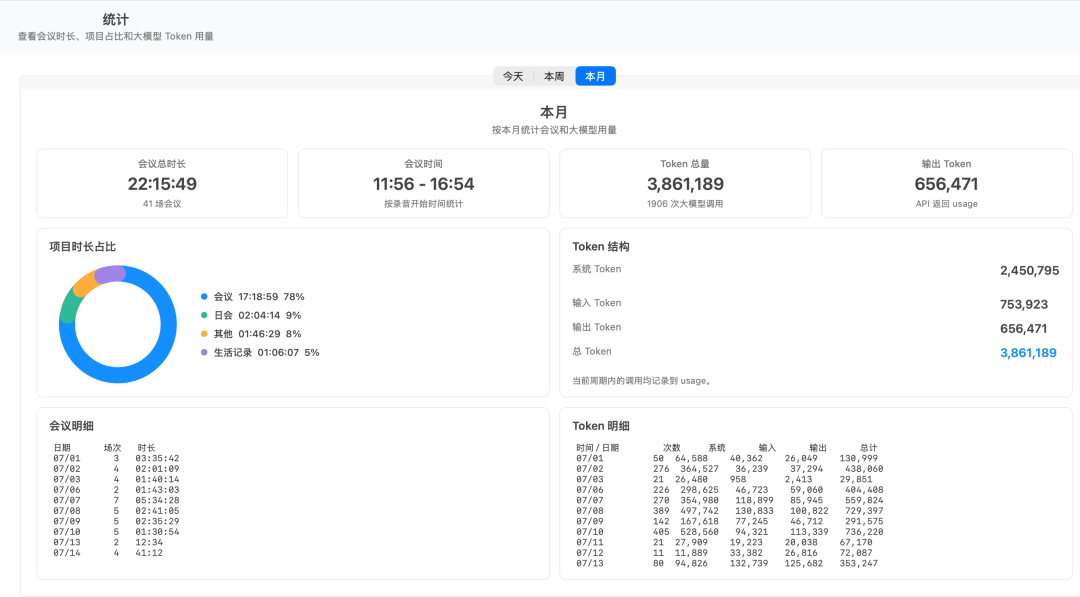
客观地说,端侧本地跑的模型在极限精度上和云端巨头可能差一些,但是用于会议记录和总结,由于上下文足够长,加上我们做的大量工程优化(特别是热词、关键词唤醒技术),效果已经完全够用,甚至在某些特定场景下更好用。
你相信“端侧AI”会爆发吗?
以前我不相信,但是随着技术的演进和成本的倒逼,现在我慢慢相信了。
为什么呢?如果你认同“AI Agent(智能体)将来能成为一种全新的操作系统(OS)”,那么你就有充分的必要条件去相信端侧AI的爆发。

相关文章


