



文章摘要
本文主要介绍了图的基本概念及通用存储方式,即邻接矩阵和邻接表,并对比了两种存储方式的优劣势;同时介绍了图的搜索算法——广度优先搜索BFS和深度优先搜索DFS的原理、实现和复杂度;最后以微博好友关系存储为例介绍了图在实际环境中的应用,帮助读者由浅入深循序渐进地理解图的核心原理和使用方法。
图
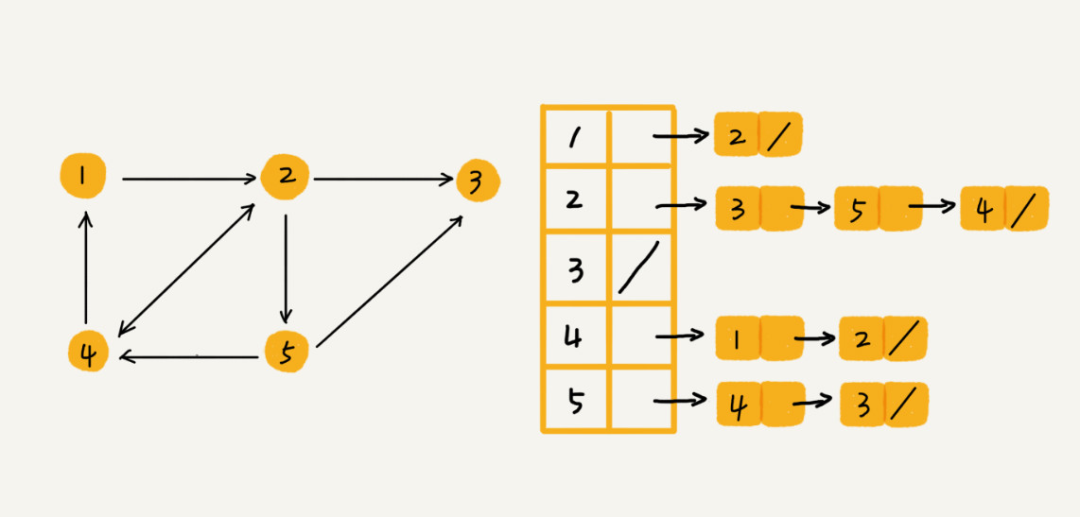
顶点(vertex):图中的元素;
边(edge):图中元素之间的关联关系;
度(degree):图中的元素连接的边的条数;
入度(In-degree):有向图中指向某个顶点的边的条数;
出度(Out-degree):有向图中某个顶点出发指向其他顶点的边的条数。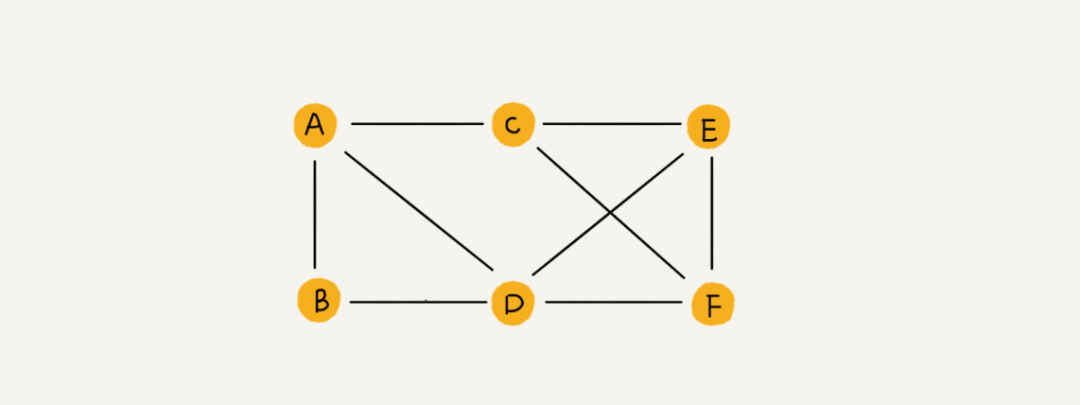
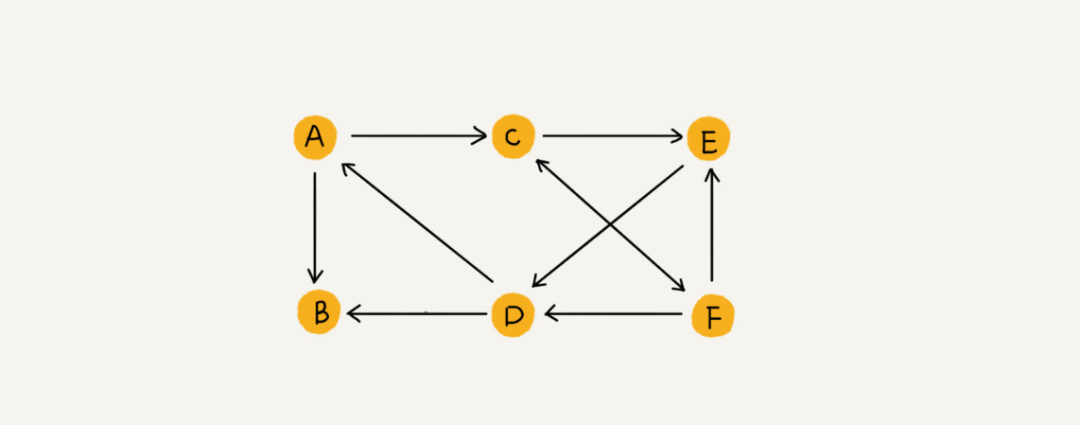
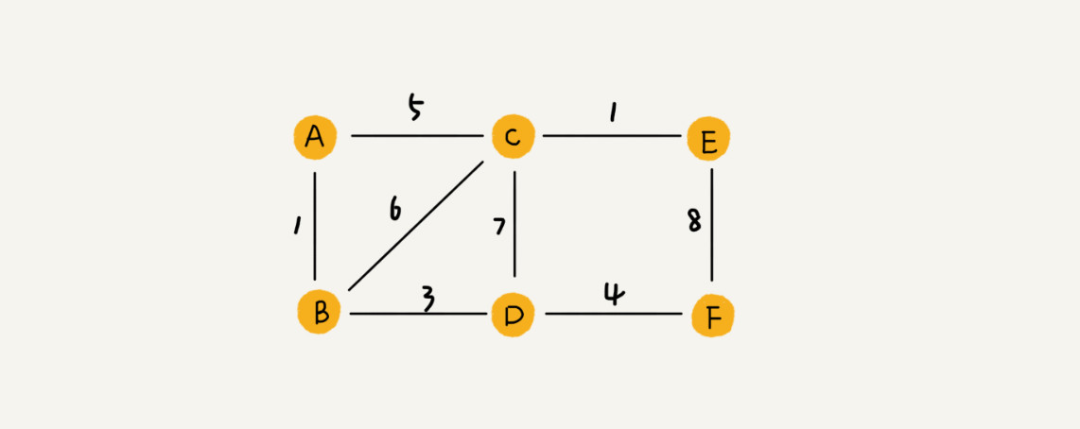
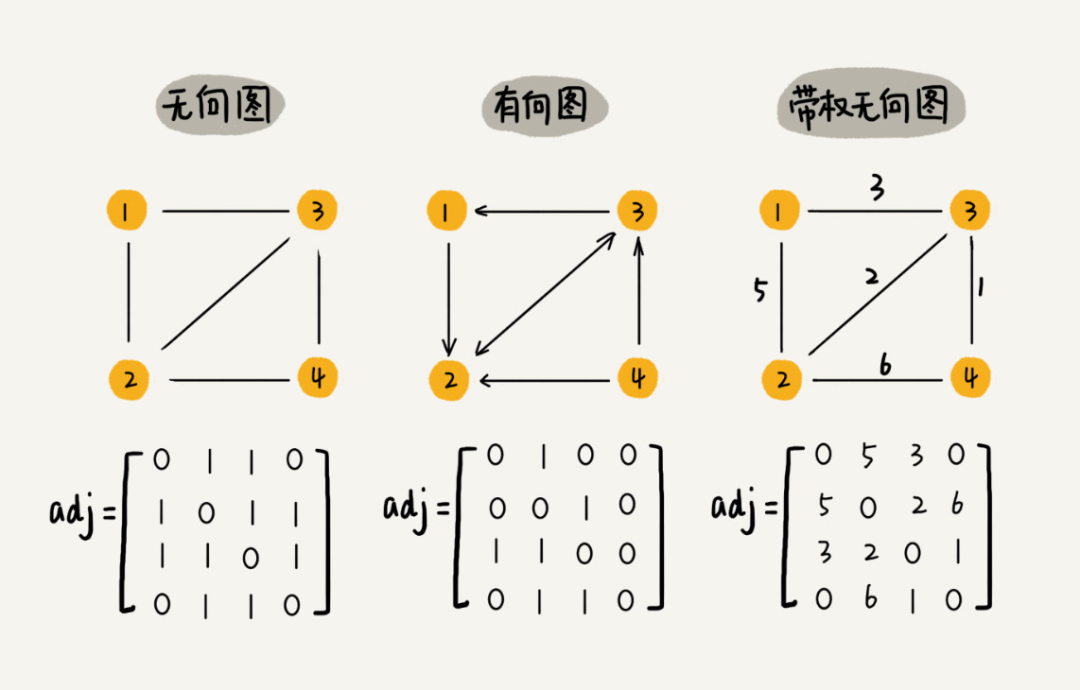
对于无向图:如果顶点 i 与顶点 j 之间有边,我们就将 A[i][j]和 A[j][i]标记为 1;对于有向图:如果顶点 i 到顶点 j 之间,有一条箭头从顶点 i 指向顶点 j 的边,那我们就将 A[i][j]标记为 1。同理,如果有一条箭头从顶点 j 指向顶点 i 的边,我们就将 A[j][i]标记为 1;
对于带权图:在有向图存储的基础上,数组中存储相应的权重。
-
可以非常高效的获取两个顶点之间的关系;
-
图之间的计算可以转换为矩阵之间的计算,同时借助CPU缓存等,实现高效的计算。
-
对于无向图,A[i][j] 和 A[j][i] 都要存储1,只要二者其一存储即可,浪费了一半的存储空间;
-
对于稀疏图,顶点很多,但每个顶点的边不多的图,邻接矩阵的存储会浪费更多的存储空间。
图搜索
public class Graph { // 无向图private int v; // 顶点的个数private LinkedList<Integer> adj[]; // 邻接表public Graph(int v) {this.v = v;adj = new LinkedList[v];for (int i=0; i<v; ++i) {adj[i] = new LinkedList<>();}}public void addEdge(int s, int t) { // 无向图一条边存两次adj[s].add(t);adj[t].add(s);}}
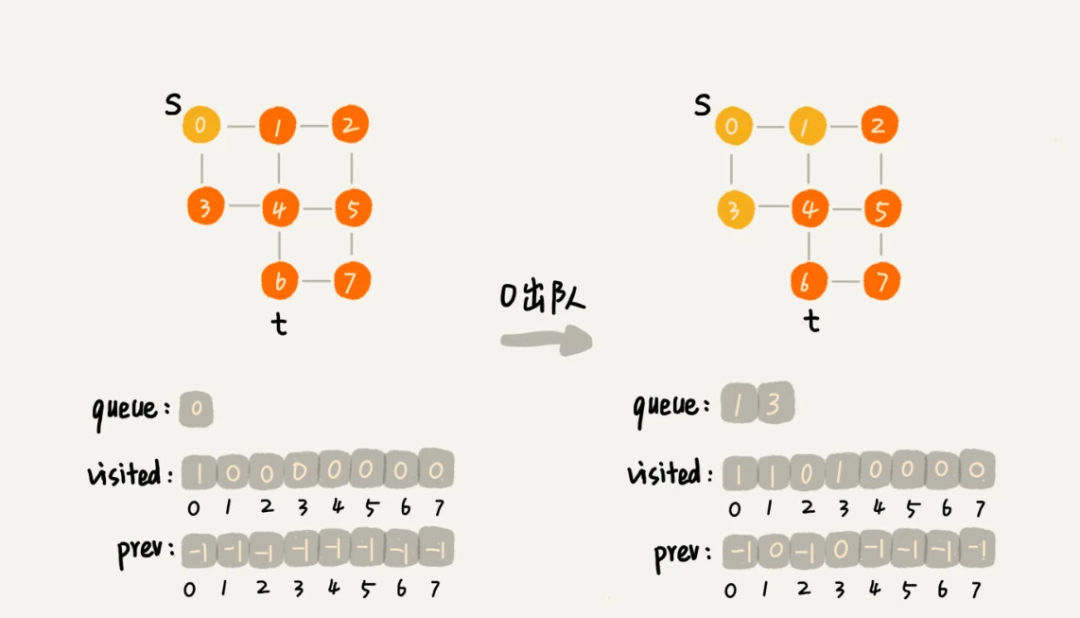
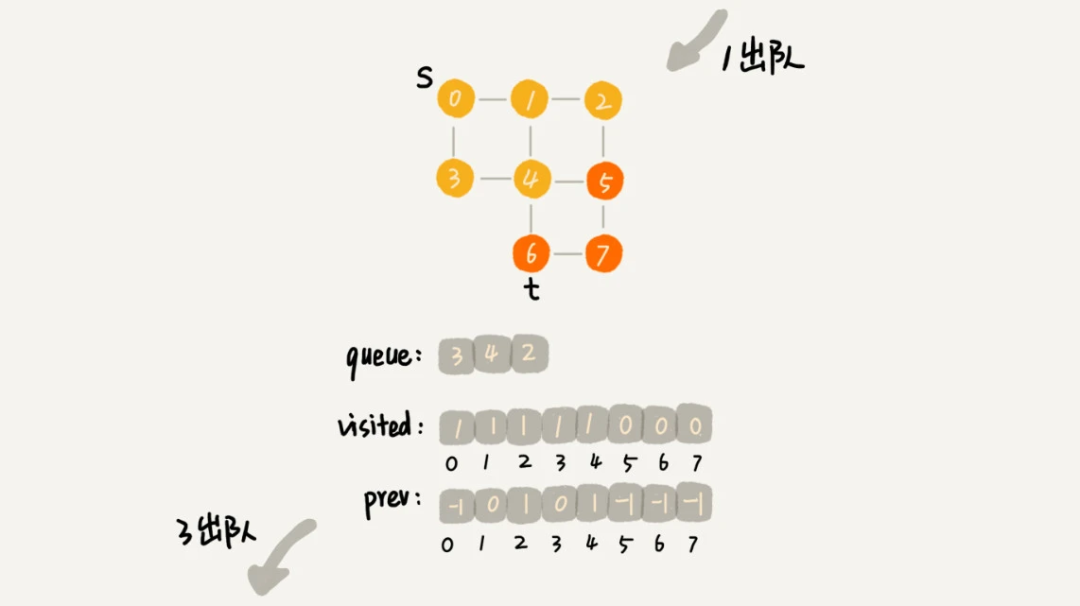
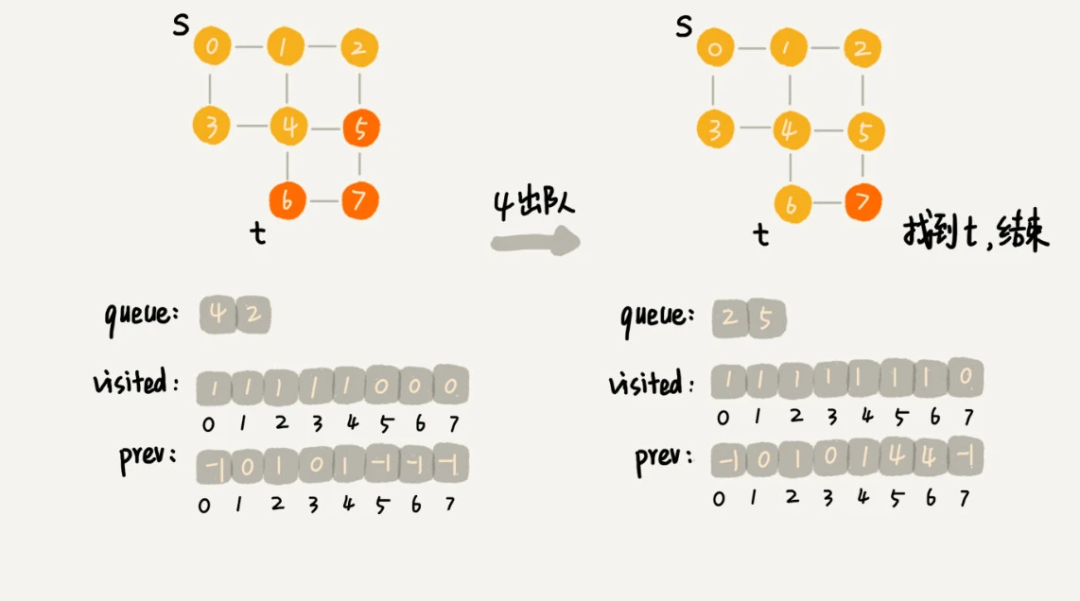
public void bfs(int s, int t) {if (s == t) return;// 用来记录已经被访问的顶点,用来避免顶点被重复访问。如果顶点 q 被访问,那相应的 visited[q]会被设置为 trueboolean[] visited = new boolean[v];visited[s]=true;// 用来存储已经被访问、但相连的顶点还没有被访问的顶点Queue<Integer> queue = new LinkedList<>();queue.add(s);// 用来记录搜索路径。当我们从顶点 s 开始,广度优先搜索到顶点 t 后,prev 数组中存储的就是搜索的路径// 这个路径是反向存储的,prev[w]存储的是顶点 w 是从哪个前驱顶点遍历过来的,为了正向打印出路径,我们需要递归地来打印,可以看下 print() 函数的实现方式。int[] prev = new int[v];for (int i = 0; i < v; ++i) {prev[i] = -1;}while (queue.size() != 0) {int w = queue.poll();for (int i = 0; i < adj[w].size(); ++i) {int q = adj[w].get(i);if (!visited[q]) {prev[q] = w;if (q == t) {print(prev, s, t);return;}visited[q] = true;queue.add(q);}}}}private void print(int[] prev, int s, int t) { // 递归打印s->t的路径if (prev[t] != -1 && t != s) {print(prev, s, prev[t]);}System.out.print(t + " ");}
boolean found = false; // 全局变量或者类成员变量public void dfs(int s, int t) {found = false;boolean[] visited = new boolean[v];int[] prev = new int[v];for (int i = 0; i < v; ++i) {prev[i] = -1;}recurDfs(s, t, visited, prev);print(prev, s, t);}private void recurDfs(int w, int t, boolean[] visited, int[] prev) {if (found == true) return;visited[w] = true;if (w == t) {found = true;return;}for (int i = 0; i < adj[w].size(); ++i) {int q = adj[w].get(i);if (!visited[q]) {prev[q] = w;recurDfs(q, t, visited, prev);}}}
图的应用
-
判断用户 A 是否关注了用户 B; -
判断用户 A 是否被用户 B关注; -
用户 A 关注用户 B; -
用户 A 取消关注用户 B; -
根据用户名称的首字母排序,分页获取用户的粉丝列表; -
根据用户名称的首字母排序,分页获取用户的关注列表。
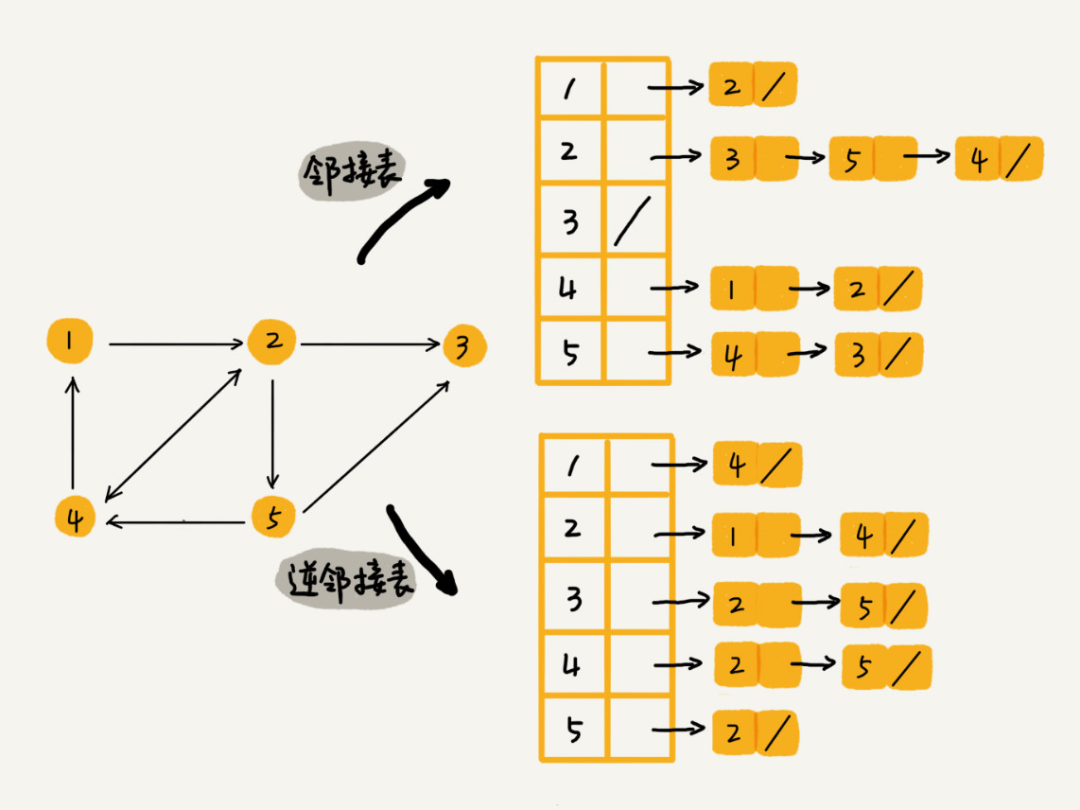
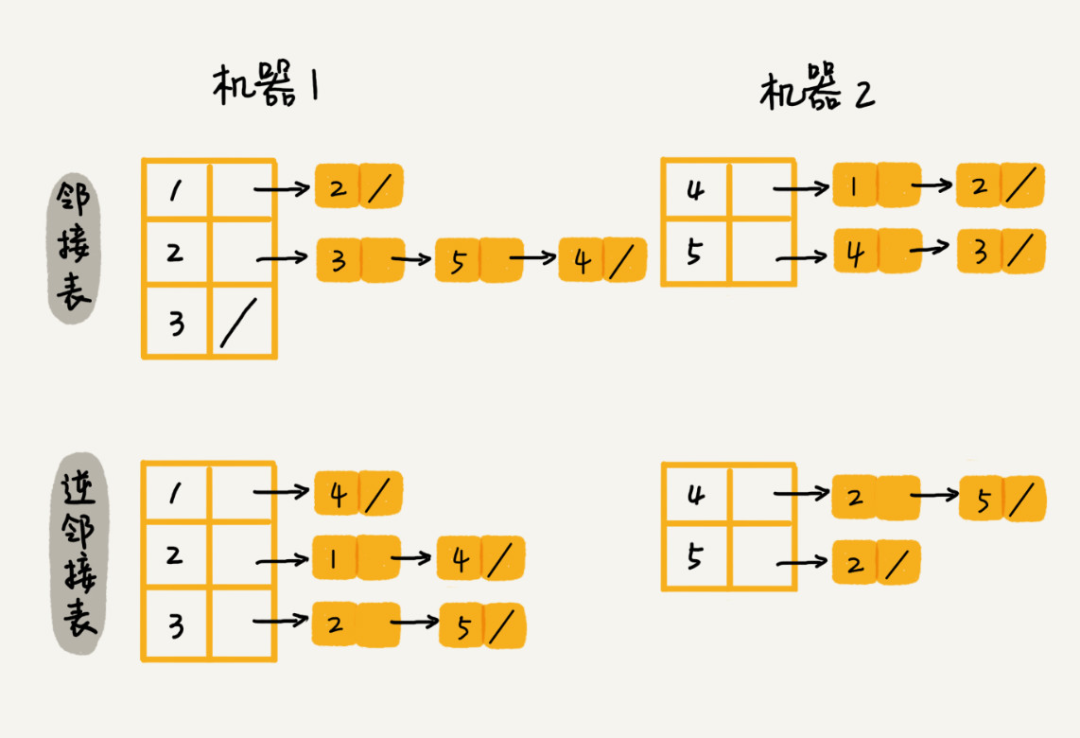
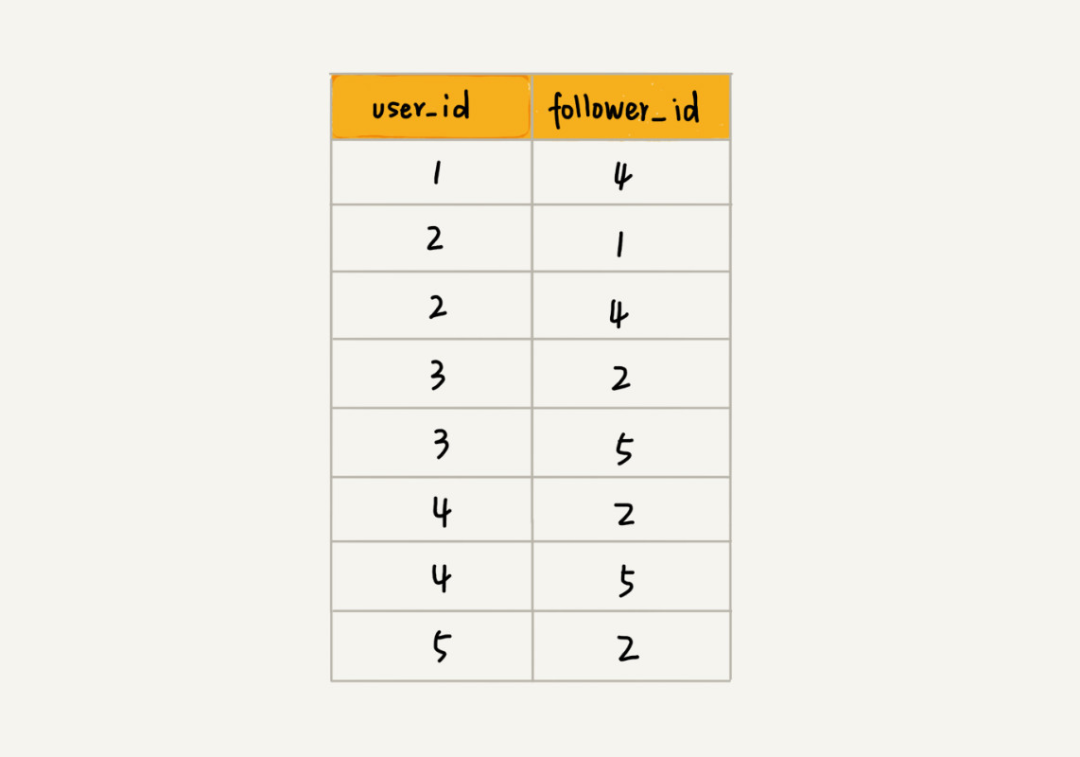
-
内存中使用邻接表;
-
持久化存储就用数据库;
-
超大图并且涉及大量图计算,使用专业的图数据库。

© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...


职场人导航(www.zcrdh.com)是为上班族与打工人打造的一站式工具导航网站,精选办公工具、AI工具、效率软件、摸鱼网站与生活实用资源,覆盖日常办公、工作提效、学习成长与下班生活等多种场景,帮助你快速找到真正好用的网站与软件,提升工作效率与生活体验。
