



📦 5 Parts + Conclusion
01它和别的模型差在哪·猜结果,还是推过程
02中间那几步的去向·留着用,还能被改
03我的判断落空·会算,不等于懂
///写在最后·佩服的是想出这条路的人
标题里有两个词我一开始都没看懂:因果思维链,世界模型。
让我读下去的是那个问题:它凭什么比现有的模型更厉害。
说实话,近期刷模型相关的新闻已经比较频繁。
往前倒一两年、两三年,模型的更新至少半年,或者七八个月一次。
现在这边唱罢那边登场,基本上一两个月就有一代。
频繁度上来,新闻阅读就疲了。这一篇让我停下来了。
先说世界模型是什么。 给它一张现在的画面,让它说出接下来会发生什么,这就是世界模型在做的事。 做机器人的需要它。机器每次伸手之前,得先知道这一下会产生什么后果。真去试,代价高,东西会摔坏,机器会撞坏。 以前要算这个,靠人搭物理仿真器,把物体的形状、重量、摩擦一条条写进去。建模费时,而且真机比模型里复杂,仿真里跑通了,真机上未必。 世界模型想绕开这条路,不靠人写规则,直接看视频学。 这次发的这个模型,做的是机器人场景里的这一档事。 绝大多数模型都在猜,猜得像,也会猜错 接触过的模型,不管是文生文、文生图还是图生视频,底层逻辑是一样的:都在预测。 预测下一个字,下一张图,下一个动作。 预测的依据是它见过的东西。见过的结果足够多,下一次就挑一个最像的出来。这就是猜。 猜得出很像的样子,也会猜错。模型更大、数据更多,猜得更像,但性质没变。 它先算一遍中间怎么动、怎么变,再出画面 文章说,这个模型不这么做。它在出画面之前,先把中间发生了什么算一遍:画面里的东西往哪动、动了多少,离相机有多远,在三维空间里的关系怎么变。 这几样东西可以从视频里自动算出来,不需要人一样样标。 它们也比一帧画面简单:一帧画面是密密麻麻无数个点的颜色,运动、距离、位置是把它压小之后的说法。 算完这几样,再照着它们生成画面。这是它和前面那几个模型真正的差别。 以前是照着结果的样子出结果,现在是先把中间的道理推一遍,再出结果 算出来的这几步不会扔,要当下一步的条件 这里要交代一句模型干活的方式。 给它一些信息,让它接着往下算,这些信息就是它的输入。 常见做法是,中间那几步算完就先放在一边,最后只用画面来对答案。算出来的运动、距离、位置,不参与后面的生成。 这个模型不一样。 它算完运动,把运动放回输入;下一步算三维关系的时候,能看见刚才算出的运动;算完三维关系,再放回输入,这才开始出画面。 这一串有先后。上一步推出的动,决定了下一步算出的空间关系;算出的空间关系,再决定画面长什么样。前一步偏了,后一步跟着偏。 画面是一次性的结果,规律是可以反复用的原因 这套做法,文章里叫因果思维链。 这几步还能被改,改一个条件,未来就跟着变 还有一层我原来没想到。 模型在练的过程中,一直收这类视觉条件,久了它自己学会一件事:只要一个条件能被表示成画面里的信息,就可以塞进去,参与生成。 举个例子。研究人员在仿真器里排好一条机械臂的动作轨迹,机器手该往哪走、什么时候抓,都定好。 然后把这些轨迹画成画面,塞进模型。 模型生成的未来,就跟着这条轨迹走。 这件事的意义在于,普通的预测是“照现在的样子,接下来大概会发生什么”。 塞进轨迹,等于主动改掉一个条件,再看未来怎么变。从“看会发生什么”,挪到了“如果我这样做,会怎么样”。 原本只用来解释未来怎么发生的那几步 变成了可以拧的旋钮 那个榜考的是三个视角说的是不是同一个世界 它登顶的那个榜叫 TriWorldBench,专门考世界模型在机器人任务上的预测。 机器人身上有三个相机,头顶一个看全局,左右手腕各一个看抓取。这个榜要求:同一次操作,模型要同时生成三个视角的画面,三个画面必须描述同一个物理世界。机器什么时候动、东西有没有被正确抓住、三个视角里的状态能不能对上,都要对得上。 只看一个画面像不像,拿不到分。一个画面可以糊弄,三个画面要自洽就糊不住了。这正好是猜不出来的部分,猜出来的画面各自像,很难像是同一个世界。 也要说清楚边界。它算出来的还是画面上的运动和三维位置,不是物理定律。离“知道一个杯子被推会怎么滑”,还差得远。 文章自己也写了,它距离严格意义上的反事实推理还有一段距离。 我原以为,能算出这些中间步骤,说明模型开始理解物理世界的规则了。看下来并没有。 那套做法说到底是让它把机制和逻辑描述了一遍,运动怎么发生、空间怎么变,一条条写出来。它是不是真的理解了,我们不知道。 它做的是把机制和逻辑翻译成自己认得的信息。翻译过来了,不等于懂了。
世界模型做的,是让机器动手前先在脑子里演一遍WORLD MODEL · 它是什么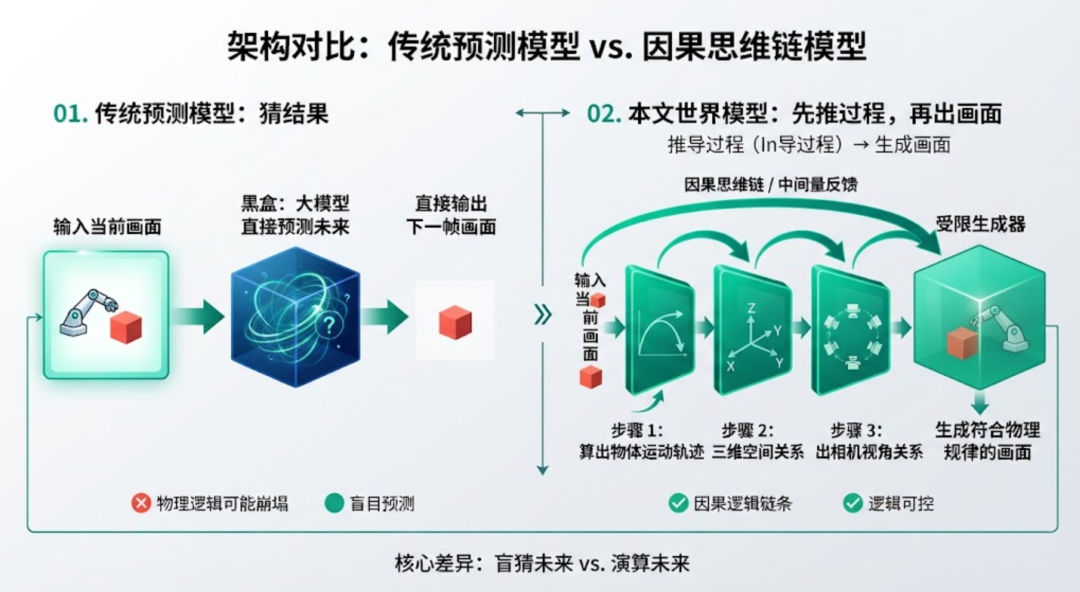
绝大多数模型都在猜,它却先算一遍中间再出画面HOW IT DIFFERS · 差在哪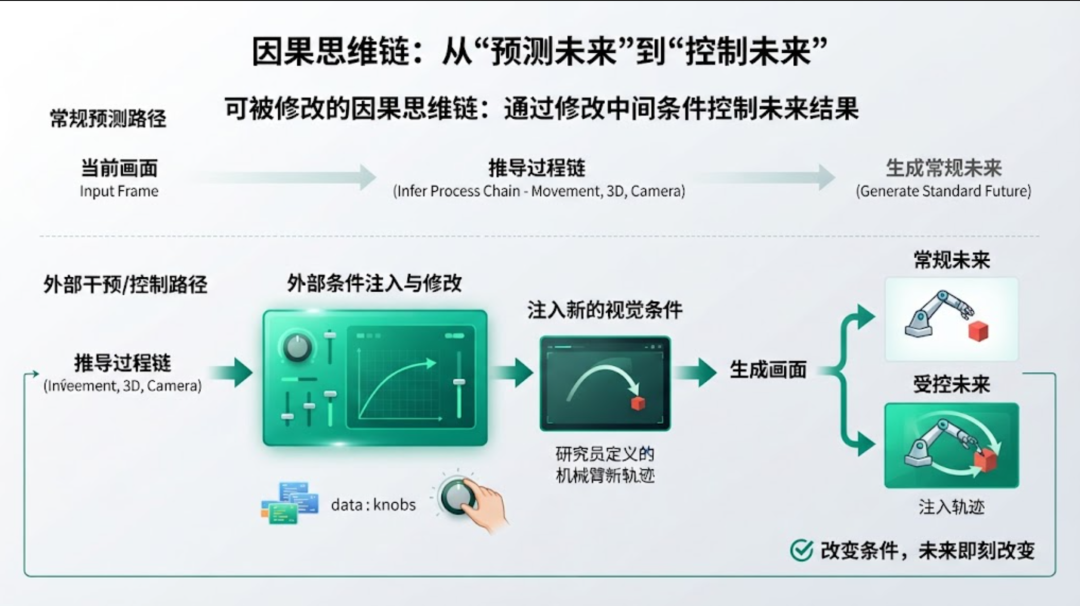
算出来的这几步不扔,还能被从外面改CAUSAL CHAIN · 中间量的去向
它登顶靠的是三个视角说同一个世界,但算的只是近似THE BENCHMARK · 榜与边界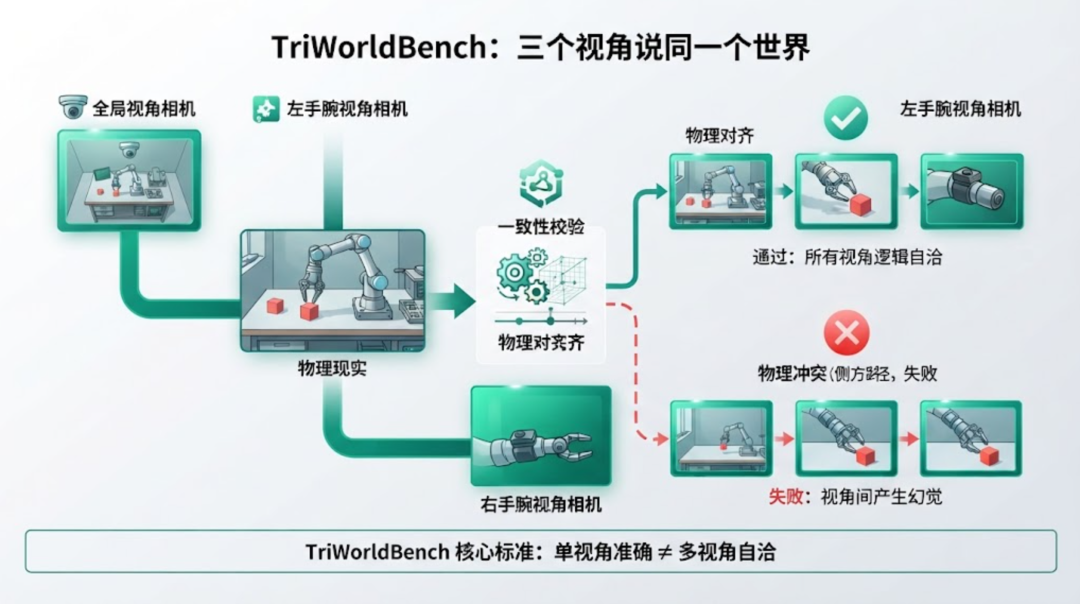
我原以为它理解了,看下来并没有MY TAKE · 判断落空

相关文章


