



从 MicroVM 到热温冷分层,拆开 Agent 沙箱的性能、内存与安全账。
📖 阅读时间:约 7 分钟
本文目录:
1.为什么 Agent 代码不能直接跑在宿主机
2.容器、虚拟机与 MicroVM 的三角权衡
3.真正昂贵的是沙箱的生命周期
4.热、温、冷三层如何节省资源
5.安全与可靠性为什么不能后补
6.一套可执行的沙箱评测方法
与主文的关系:
前一篇已经回答“为什么 CPU 在 Agent 时代重新重要”——因为 Agent 把模型调用扩展成由 CPU 编排的状态与工具链。这一篇不再重复结论,继续往下追问:当 Agent 真正开始执行代码时,CPU、内存与存储究竟要怎样为它建一间安全、快速、可回滚的工作室?
让 Agent 帮你分析一个陌生代码仓库,它可能会执行 npm install、运行测试、启动脚本,甚至根据错误改写代码再试一次。对用户来说,这是“AI 在干活”;对平台来说,这是一段来源不确定、行为不可完全预测、还需要访问文件和网络的代码。
把它直接放在宿主机上运行,相当于把陌生施工队带进机房,还把总电闸和所有钥匙留在墙上。沙箱就是那间独立的“安全房”:工作可以发生,影响范围必须被锁住;做错了能回滚,需要时还能复制出多个分身并行探索。
所以这篇作为 CPU 主文的次条,不再重复“CPU 为什么重要”,只回答一个更具体的问题:Agent 的安全执行环境为何成为 CPU、内存和存储共同参与的新基础设施。主文给出因果框架,次文沿其中“安全沙箱”这一条支线拆机制、算资源账、给评测方法。
1. 为什么 Agent 代码不能直接跑在宿主机
1.1 不可信不等于恶意
Agent 生成的代码即便没有攻击意图,也可能删除错误目录、耗尽内存、开启失控进程或访问不该访问的凭据。风险来自不确定性,而不只是恶意。
开头的代码分析 Agent 需要读取仓库、安装依赖并运行测试。平台必须限定它能看哪些文件、能访问哪些网络、能用多少 CPU/内存、最长运行多久。隔离边界越模糊,自动化能力越强,事故半径越大。
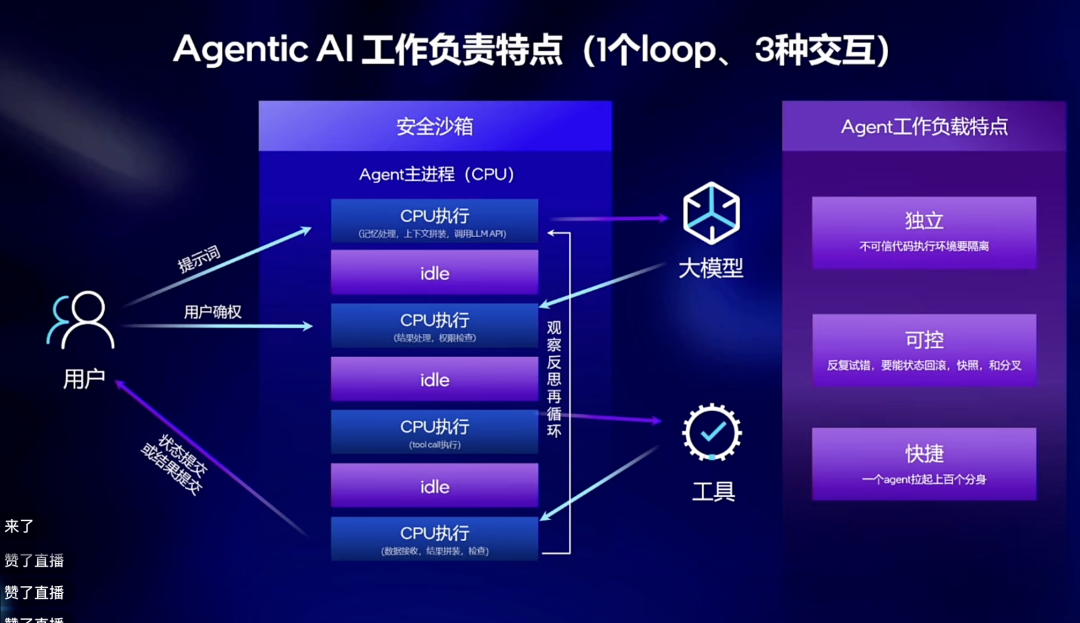
一个 Loop 与工具、模型、用户之间的交互
现场材料:Agent 主进程在 CPU 上组织记忆、权限、工具与结果;不可信执行需要独立、可回滚的环境。
1.2 回滚与分叉是 Agent 的正常动作
测试失败后,Agent 可能回到安装依赖前的状态,换一种方案重试;也可能从同一个快照分叉出三条路径并行探索。传统应用把快照当灾备,Agent 则可能把快照当常规控制流。
这意味着沙箱不仅要隔离,还要足够快。如果创建环境要几十秒,Agent 每次试错都会把用户拖进漫长等待。
2. 容器、虚拟机与 MicroVM 的三角权衡
2.1 容器快,但共享内核
容器启动快、密度高,适合可信服务。但它与宿主机共享内核,隔离强度依赖内核和配置。面对任意生成代码,平台往往不愿只押一层容器边界。
2.2 传统虚拟机隔离强,但太重
独立内核提供清晰边界,却带来启动时间、内存和设备模拟开销。若每条 Agent 任务都从零启动完整 VM,固定成本可能超过有效工作。
2.3 MicroVM 折中,但并非免费
MicroVM 保留独立内核,削减不必要的虚拟设备,以更小体积换取更快启动。白话说,它把“整套公寓”压缩成只保留承重墙与门锁的工作间。
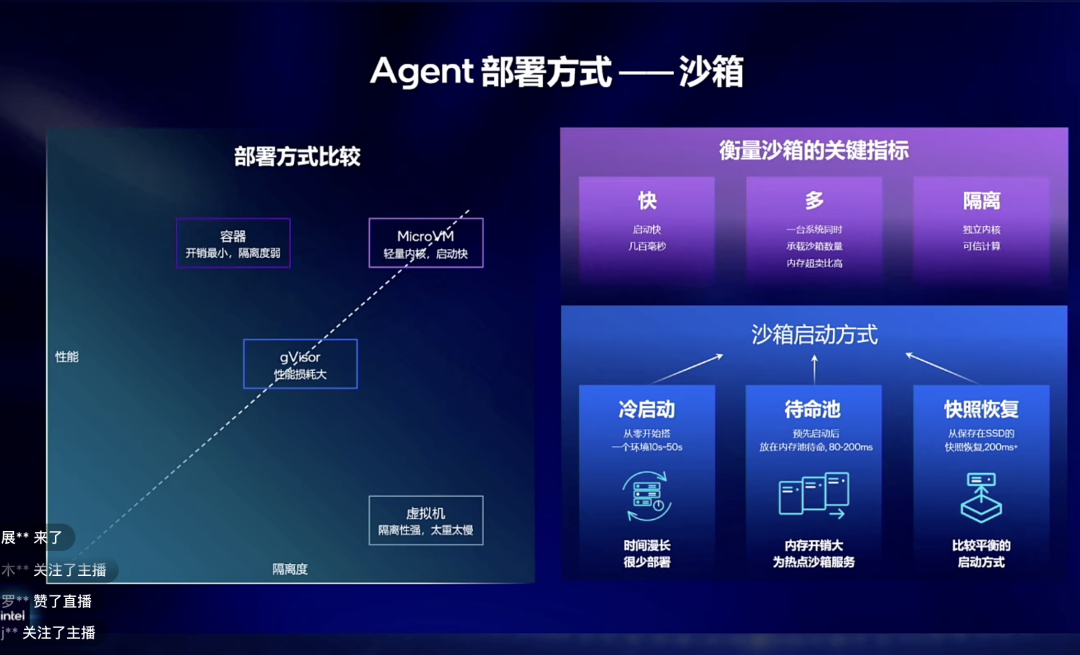
容器、MicroVM 与虚拟机的部署权衡
现场材料:启动、承载密度与隔离度构成沙箱的三角权衡。
MicroVM 仍需要内存、页表、快照、镜像和调度。选择它不是结束,而是沙箱生命周期优化的开始。
3. 真正昂贵的是沙箱的生命周期
3.1 冷启动决定第一步等待
开头的 Agent 第一次运行测试前,需要加载镜像、创建内核、恢复文件系统和配置网络。如果这些动作串行发生,模型早已给出计划,用户却仍在等环境。
预热池能把部分环境提前放进内存,以空间换时间;快照恢复则从已经初始化的状态启动。两者都把冷启动搬到别处,并没有消灭成本。
3.2 空闲沙箱仍在吃内存
Agent 等待用户确认或外部 API 时可能几分钟不做计算,但它的运行环境、上下文和页缓存仍驻留内存。数百个沙箱叠加后,内存往往比 CPU 核更早成为容量上限。
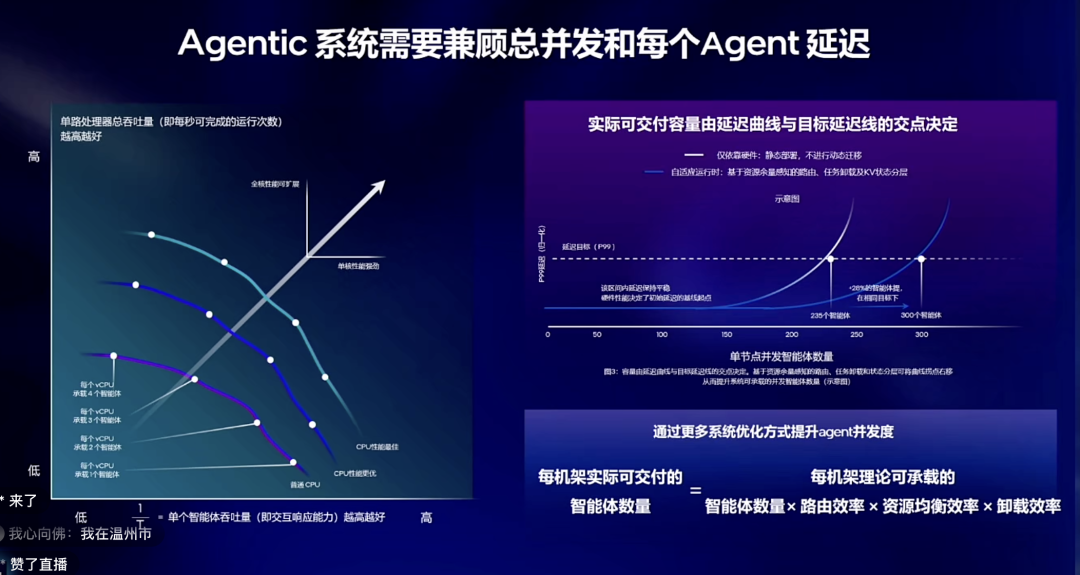
Agent 并发容量由延迟曲线与目标线共同决定
现场材料:容量不是“理论能启动多少”,而是在 P99 目标内可交付多少。图中 28% 为演讲现场示意口径,正式引用需复核实验条件。
3.3 快照把内存压力转成存储压力
冷沙箱写入 SSD 后节省 DRAM,却增加压缩、I/O 和恢复时间。如果快照很大、写入频繁,SSD 带宽和寿命会成为新瓶颈。优化不能只看内存下降,还要看恢复延迟与写放大。
4. 热、温、冷三层如何节省资源
4.1 热沙箱:共享相同页面
大量沙箱来自同一 OS 与基础镜像,内存中存在重复页。KSM 可以合并相同物理页面,并在写入时 Copy-on-Write。问题是扫描与校验也消耗 CPU;若去重成本高于节省,就会伤害前台任务。
DSA 一类数据搬运加速器可以卸载部分比较、校验与复制,但收益取决于页重复率、扫描频率和硬件拓扑。
4.2 温沙箱:压缩非活跃页面
等待中的沙箱有个性化状态,不能直接去重,却可以把冷页压缩进 Zswap 等内存池。IAA 一类压缩引擎让压缩/解压少占 CPU 核,从而用计算旁路换容量。
4.3 冷沙箱:快照落盘
长时间不活跃的沙箱写入 SSD,只保留恢复所需元数据。下一次请求到来时再读回。它适合低频任务,不适合几十毫秒内必须恢复的交互。
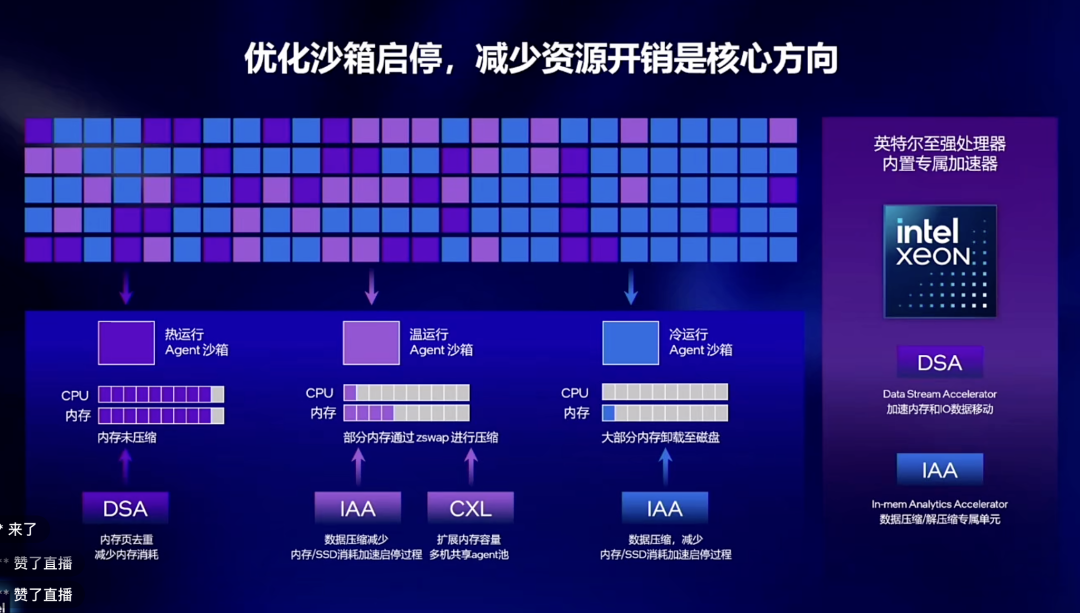
热、温、冷沙箱的资源分层
现场材料:热层做页去重,温层做内存压缩,冷层做快照卸载;每次下沉都用恢复时间换容量。
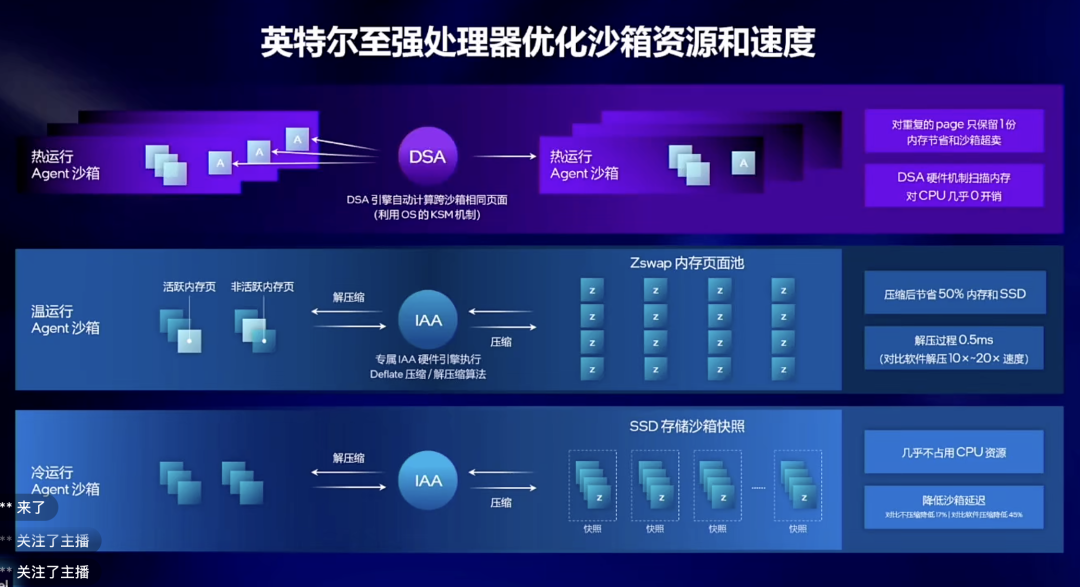
页面去重、压缩与快照的数据路径
现场材料:现场给出了内存与延迟改善数字,本文保留机制,具体数值在正式发布前应按硬件、内核与 workload 复核。
5. 安全与可靠性为什么不能后补
5.1 独立内核不等于数据绝对安全
平台管理员、宿主机漏洞、DMA 设备与侧信道仍可能突破传统边界。TDX 等可信执行技术通过内存加密与硬件隔离缩小信任域;IOMMU、链路保护与密钥管理同样属于完整方案。
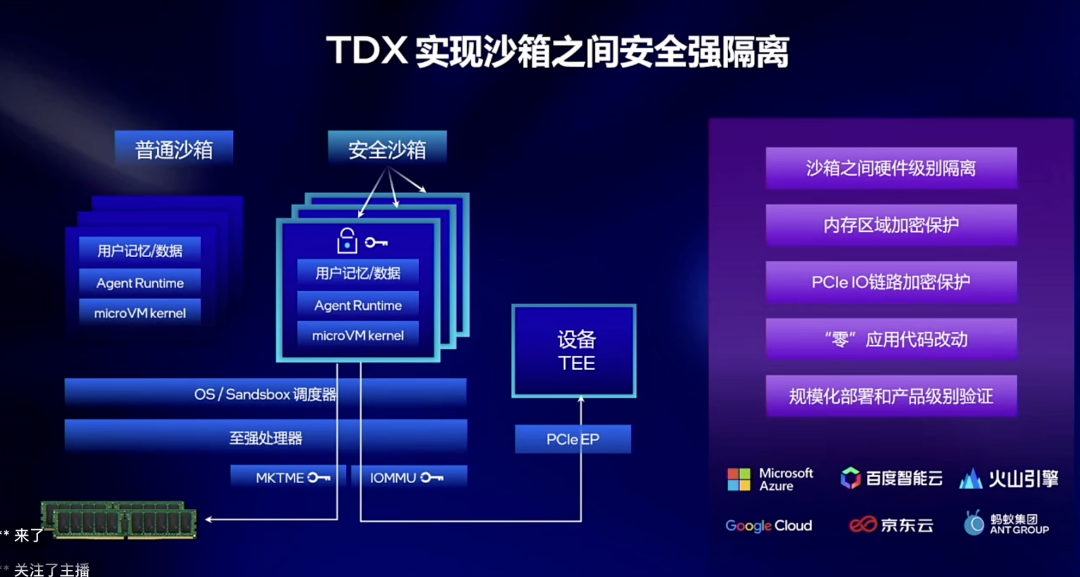
硬件级沙箱隔离
现场材料:硬件可信执行保护用户记忆、Runtime 与设备数据路径。
5.2 密度越高,故障爆炸半径越大
当一颗 CPU 承载数百个沙箱,一个内存或 I/O 故障不再影响一项服务,而可能同时中断大量 Agent。RAS 的检测、隔离、恢复能力决定平台能否把局部错误限制在局部。
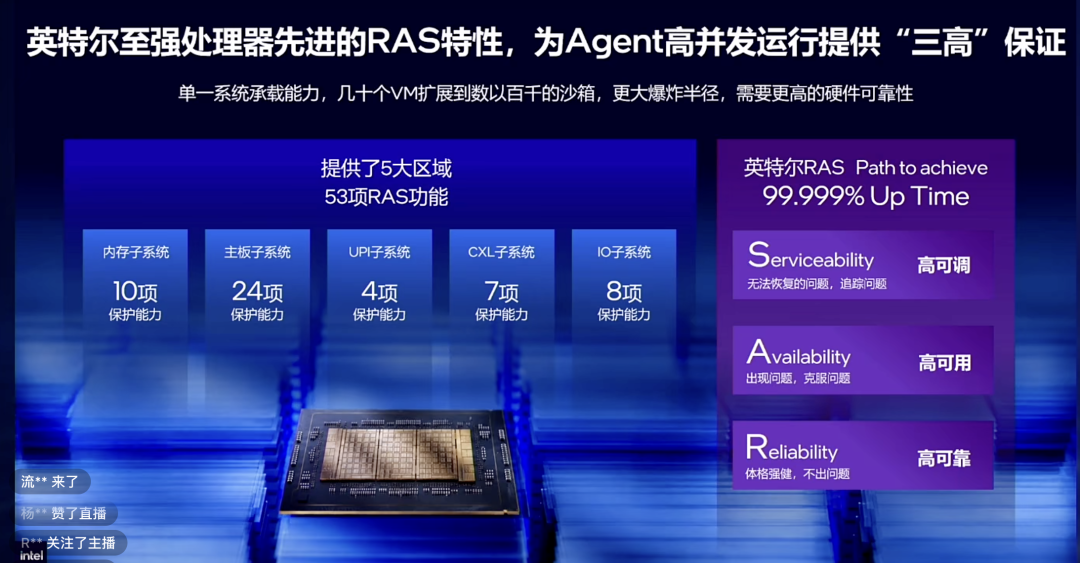
高密 Agent 对 RAS 的要求
现场材料:随着单节点承载量上升,内存、I/O、互联与主板的可靠性共同决定可用性。
安全沙箱是一份“爆炸半径预算”:隔离不是追求零风险,而是确保一次不可预测执行只能损坏被授权的最小空间。
6. 一套可执行的沙箱评测方法
不要只测“启动成功”。为同一份代码任务构造三种状态:首次冷启动、等待 60 秒后的温恢复、长时间休眠后的快照恢复。每种运行至少记录:
•P50/P95/P99 启动与恢复延迟;
•单沙箱 RSS、压缩池与快照体积;
•100/300/500 并发下的成功率与宿主机 CPU 消耗;
•文件、网络、凭据和设备的逃逸测试;
•宿主机或设备故障时的影响范围与恢复时间。
如果压缩让内存减少一半,却把 P99 恢复延迟推过交互目标,就应该只对更冷的层级使用;如果预热池足够快但常年占满内存,就要按到达率动态调节池大小。

相关文章


