



01 先回答一个问题:到底什么是 AI Agent?
AI Agent(人工智能智能体)可以理解为:一个以"大语言模型"为大脑、能够自主完成任务的系统。
它和普通聊天机器人最大的区别是:聊天机器人只负责"说",Agent 负责"做"。
比如你问聊天机器人"帮我订一张周五去上海的机票",它只能告诉你"你可以去某某 App 订";而一个 Agent 会自己去调用订票工具、查询航班、比价、下单,把一件完整的事办完。
用一句话概括 Agent 的公式,业界普遍认可的是:
Agent = LLM(大脑)+ Planning(规划)+ Memory(记忆)+ Tools(工具)
下面所有名词,都是在给这个公式的各个部分"添砖加瓦"。
02 先看全貌:Agent 名词全景图
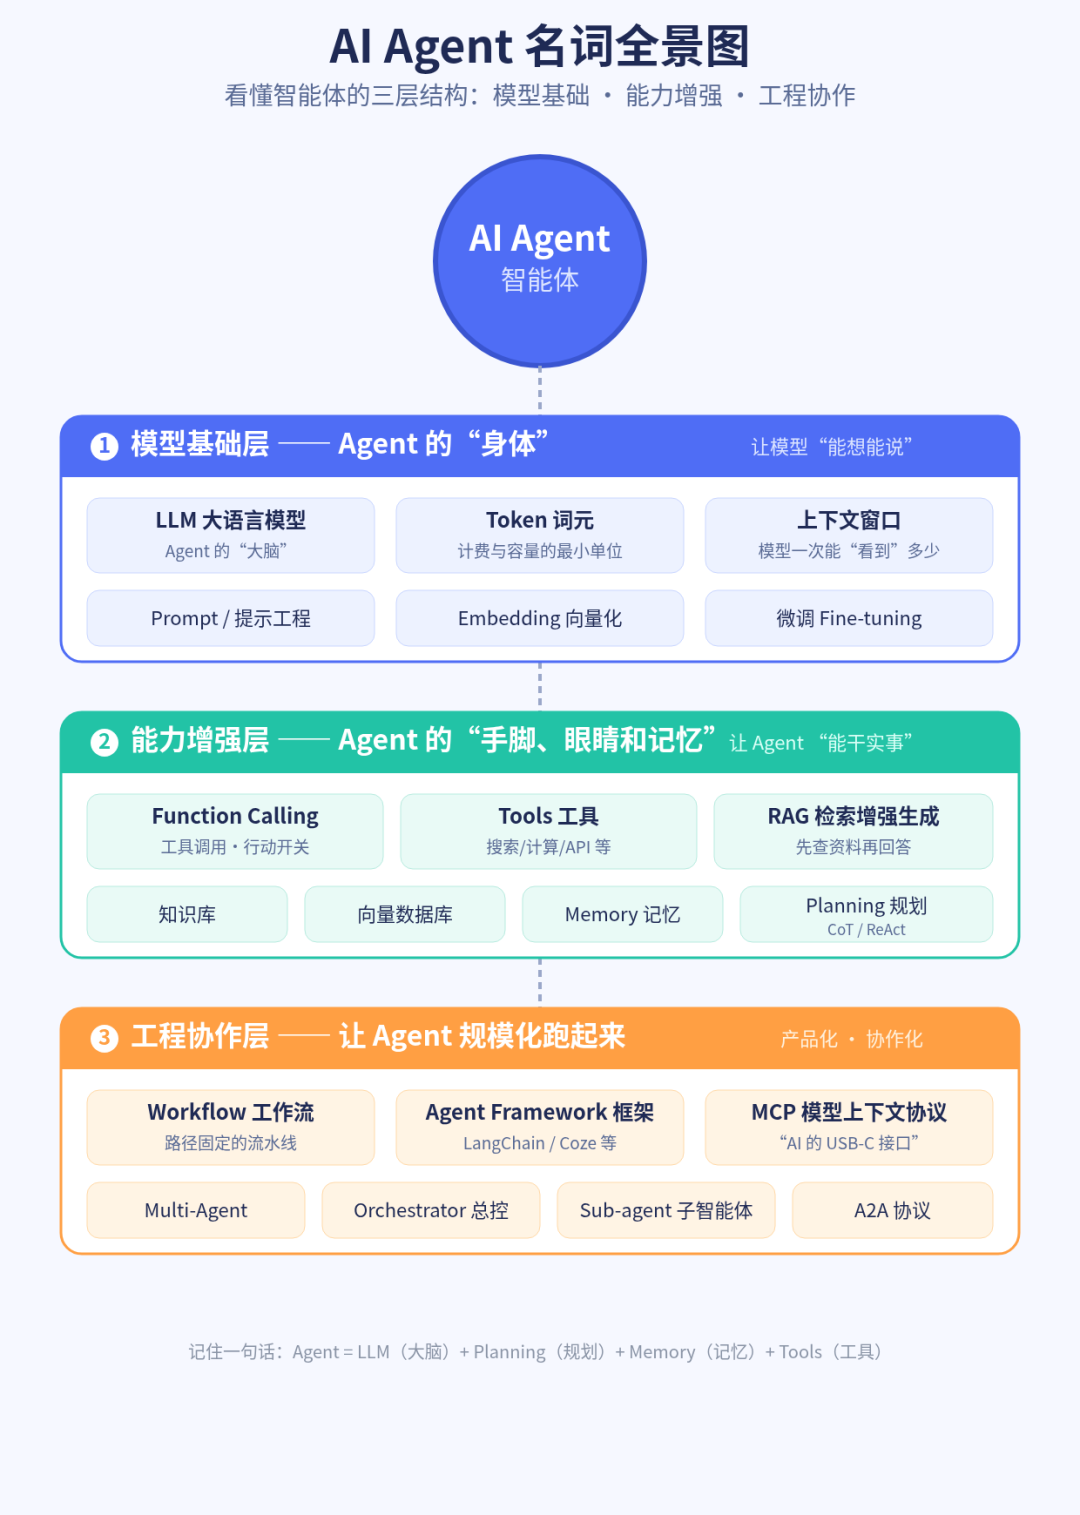
整个 Agent 生态可以分成三层:模型基础层(Agent 的"身体")、能力增强层(Agent 的"手脚和记忆")、工程协作层(让 Agent 真正跑起来的"系统")。
03 第一层:模型基础层——Agent 的"身体"
这一层的名词解决的是"模型本身是什么、怎么描述输入输出"的问题。
LLM(大语言模型) 全称 Large Language Model,基于 Transformer 架构、用海量文本训练出来的语言模型。它负责理解你的问题并生成回答,是 Agent 的"大脑"。我们常说的 GPT、Claude、豆包、DeepSeek,指的都是这类模型。
Token(词元) 模型处理文本的最小单位。英文一个单词常被切成 1~2 个 Token,中文一个字大约对应 1~2 个 Token。Token 既是模型计费的"字数单位",也是上下文窗口的"容量单位"。
上下文窗口(Context Window) 模型单次能"同时看到"的 Token 上限。窗口越大,能一次性塞进去的对话、文档就越多。现在的旗舰模型普遍支持 128K 甚至 1M Token 的上下文。
Prompt(提示词) 你发给模型的指令文本。写提示词有一定方法论,叫 Prompt Engineering(提示工程)——好的提示词能让模型表现提升一个档次。注意:提示词只是"输入",不会改变模型的权重。
Embedding(向量化/嵌入) 把一段文字(或图片、声音)映射成一串高维数字(向量),让"意思相近的内容"在向量空间里距离也近。它是后面 RAG、记忆、知识库的基础技术。
微调(Fine-tuning) 用特定领域的数据对模型继续训练,让它在某些任务上表现更好。和 RAG 不同,微调改变的是模型本身的"知识储备"。
04 第二层:能力增强层——Agent 的"手脚、眼睛和记忆"
只有大脑的 Agent 什么都做不了,这一层的名词让 Agent 真正"能干活"。
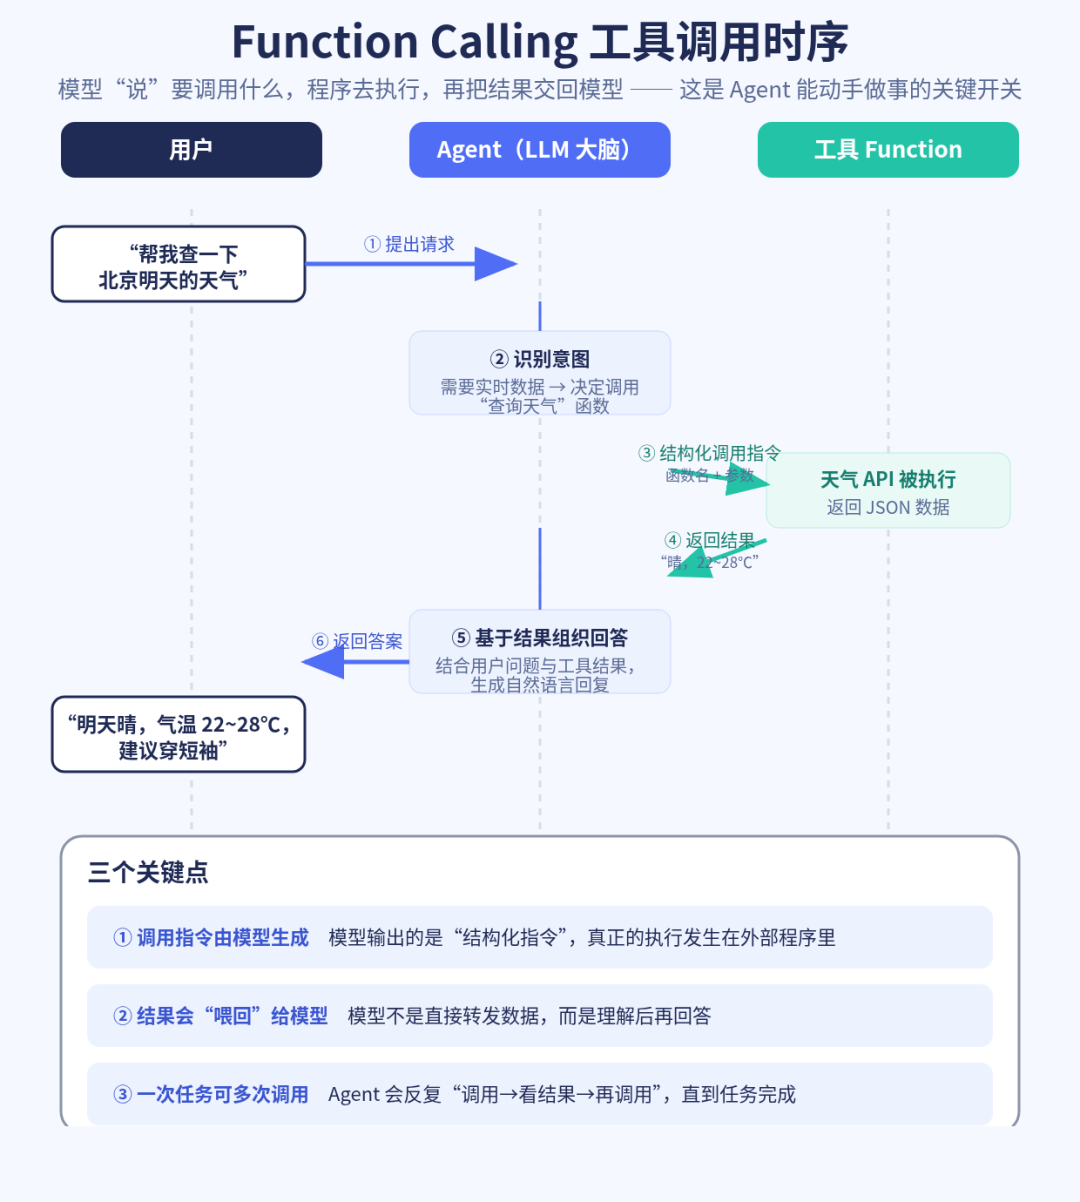
Function Calling(函数调用 / 工具调用) 让模型在回答过程中"调用外部程序"的机制:模型输出一段结构化指令(比如"调用搜索函数,关键词=XXX"),程序执行后把结果塞回给模型,模型再基于结果继续回答。这是 Agent 能"动手做事"的关键开关。
Tools(工具) Agent 可以调用的外部能力集合:搜索引擎、计算器、代码执行器、数据库、API 接口、甚至其他软件。工具是 Agent 的"手和脚"。
RAG(检索增强生成) 全称 Retrieval-Augmented Generation。核心思路:模型回答前,先从外部知识库"查资料",再把查到的资料连同问题一起交给模型生成回答。作用是引入最新/私有知识、显著减少幻觉(一本正经地胡说八道)。
知识库(Knowledge Base) 存放外部资料的集合,比如公司文档、产品手册、论文。知识库里的文档通常会被切分成小块、向量化后存入向量数据库。
向量数据库(Vector Database) 专门存"向量"并支持快速相似检索的数据库,代表作有 FAISS、Milvus、Chroma、Pinecone。RAG 的"查资料"环节就是在这里完成的。
Memory(记忆) Agent 的记忆分两类:短期记忆(当前对话的上下文,存在上下文窗口里)和长期记忆(把重要信息写入数据库,下次会话还能想起)。记忆让 Agent 从"一问一答"进化为"越用越懂你"。
Planning(规划) 把一个大任务拆成多个小步骤并安排顺序的能力。常见方法包括:
- CoT(思维链)
:让模型一步一步推理,而不是直接给答案;
- ReAct(推理+行动)
:Thought(思考)→ Action(行动)→ Observation(观察结果),循环往复,是目前 Agent 最主流的工作范式;
- Plan-and-Execute
:先定完整计划,再按计划逐步执行。
05 第三层:工程协作层——让 Agent 真正跑起来
单个 Agent 能干活之后,接下来就是"怎么把它做成产品、怎么让多个 Agent 协作"。
Workflow(工作流) 提前把步骤写死的自动化流程:节点固定、顺序固定、每个节点做什么都是人预先设计好的。适合流程稳定的场景(如"每天 9 点抓取数据→生成日报→发送邮件")。
Agent Framework(智能体框架) 帮你开发 Agent 的工具集/平台,比如 LangChain、LlamaIndex、AutoGen、CrewAI,以及国内的可口可乐式的低代码平台 Coze(扣子)、百炼等。框架把"调模型、接工具、管记忆、跑循环"这些繁琐事封装好,让你专注业务逻辑。
MCP(模型上下文协议) 全称 Model Context Protocol,由 Anthropic 于 2024 年底开源。它定义了一套"模型如何统一地连接外部工具和数据"的标准协议,可以类比为 "AI 世界的 USB-C 接口":以前每个工具都要单独对接(协议各异),现在只要工具实现一个 MCP 接口,所有支持 MCP 的 Agent 都能即插即用。
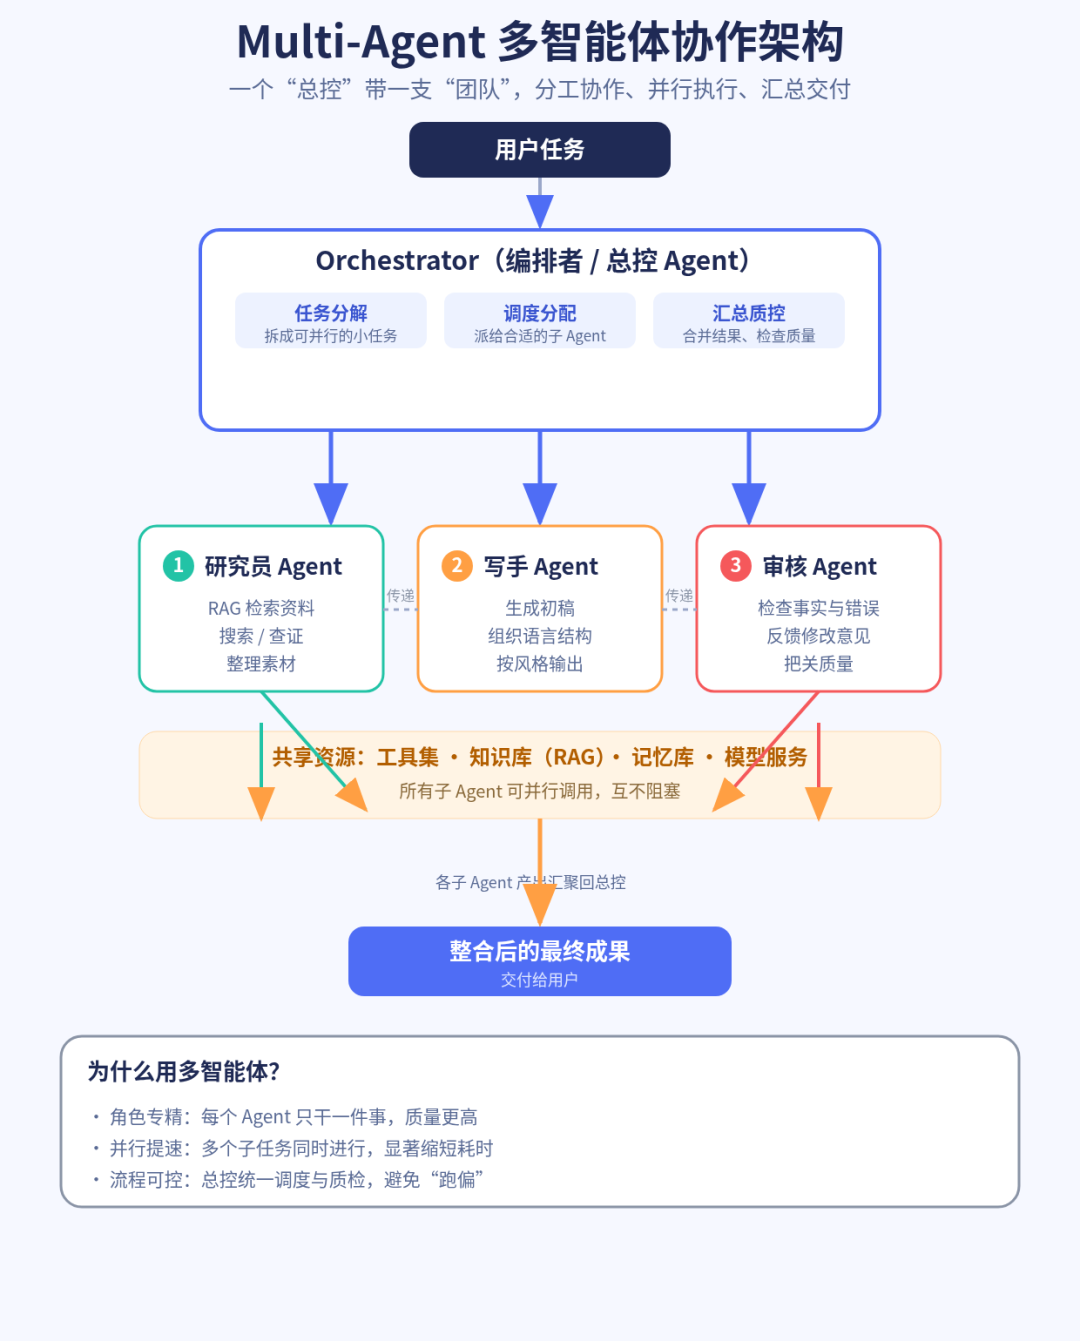
Multi-Agent(多智能体系统) 让多个各司其职的 Agent 分工协作:一个负责拆任务,一个负责查资料,一个负责写初稿,一个负责审核……像一支小型团队。
Orchestrator(编排者/总控) 多智能体系统里的"项目经理":负责理解总目标、把任务拆解分配给各个子 Agent、汇总结果、把控质量。我们日常使用的一些产品背后,就是"总控 Agent + 多个子 Agent"的架构。
Sub-agent(子智能体) 被 Orchestrator 调度、负责执行具体子任务的 Agent。多个子 Agent 可以并行干活,显著提速。
A2A(Agent 到 Agent 协议) Google 于 2025 年发布的 Agent 间通信协议,解决"不同厂商的 Agent 之间怎么对话协作"的问题,与 MCP 互补:MCP 管"Agent 连工具",A2A 管"Agent 连 Agent"。
06 原理一:一个 Agent 是怎么工作的?
把上面名词串起来,一个典型 Agent 的工作循环是这样的:
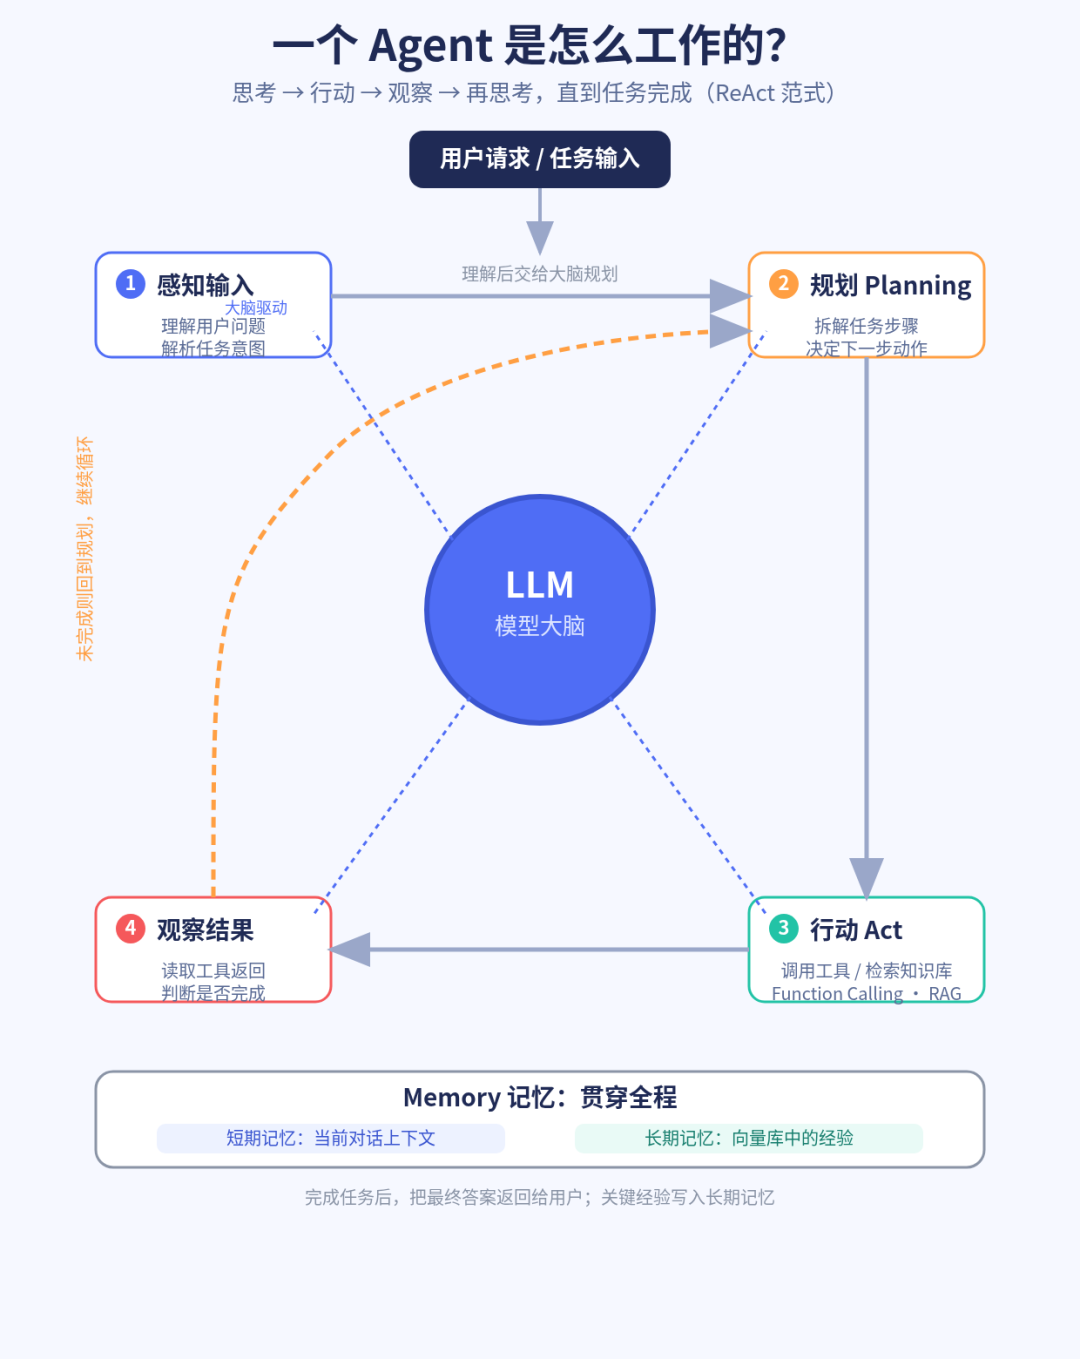
具体来说分四步:
- 感知
:接收用户请求(问题、指令);
- 规划
:LLM 基于提示词和记忆,把任务拆解成步骤(如用 ReAct 模式);
- 行动
:需要外部信息时,通过 Function Calling 调用工具;需要私有知识时,走 RAG 从知识库检索;
- 观察与迭代
:拿到工具/检索结果,LLM 继续推理,直到任务完成,最后把答案返回给用户。
整个过程是一个"思考→行动→观察→再思考"的循环,而不是一次问答就结束。
07 原理二:关键机制是怎么运作的?
RAG 的运作流程:
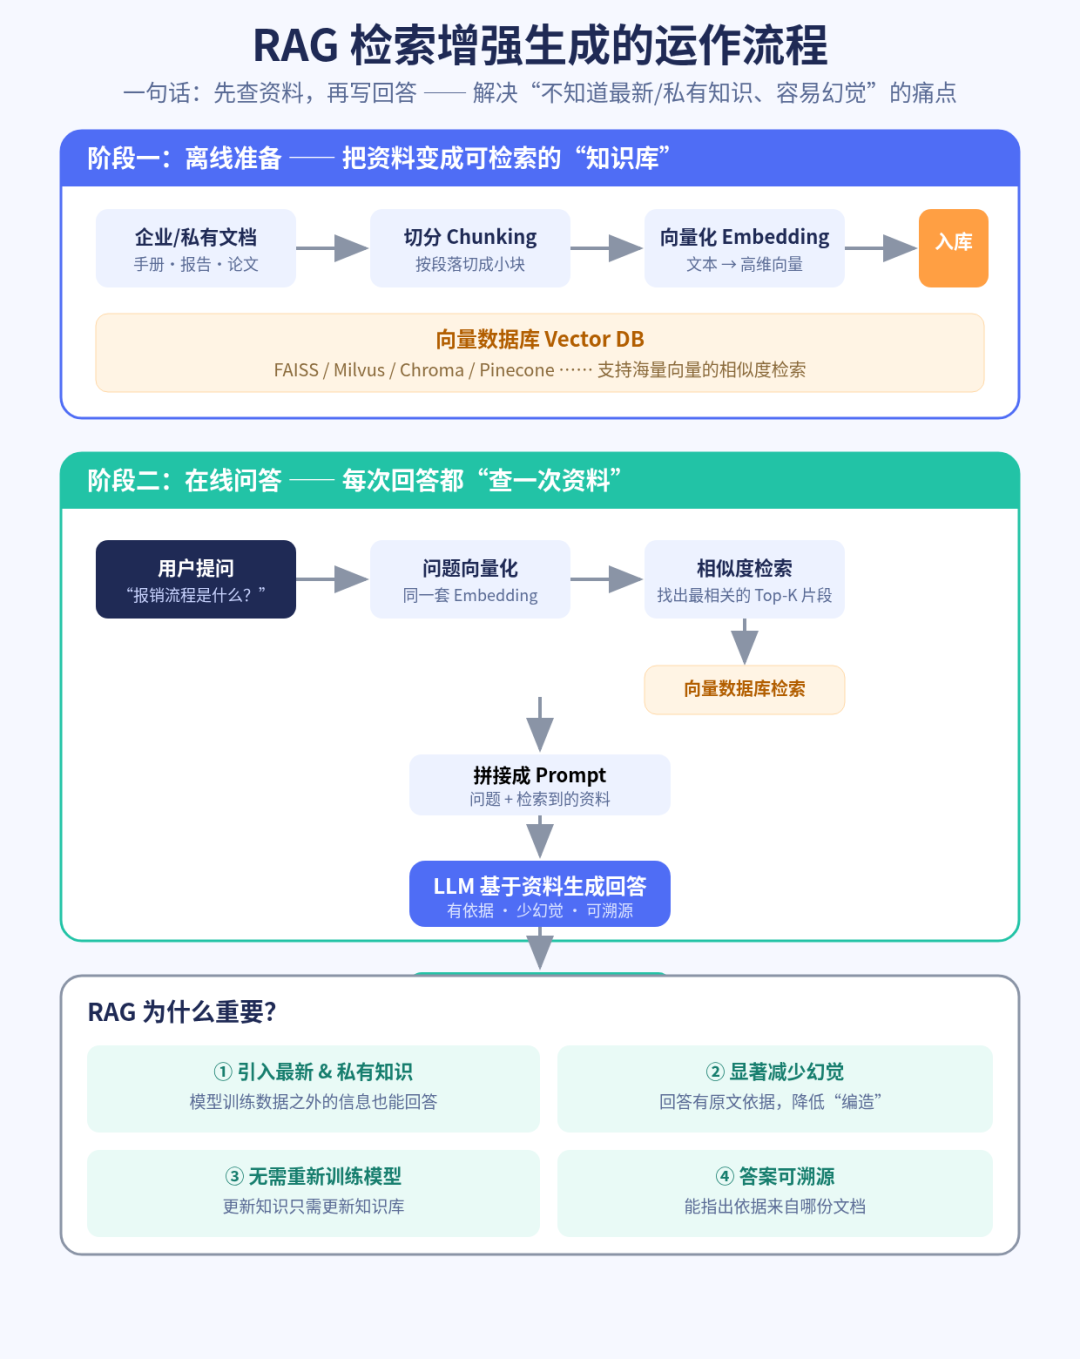
一句话总结 RAG:先查资料、再写回答。它解决了 LLM"只懂训练时学过的知识、不知道最新消息和你的私有资料"的痛点。
Function Calling 的时序:
MCP 的架构:
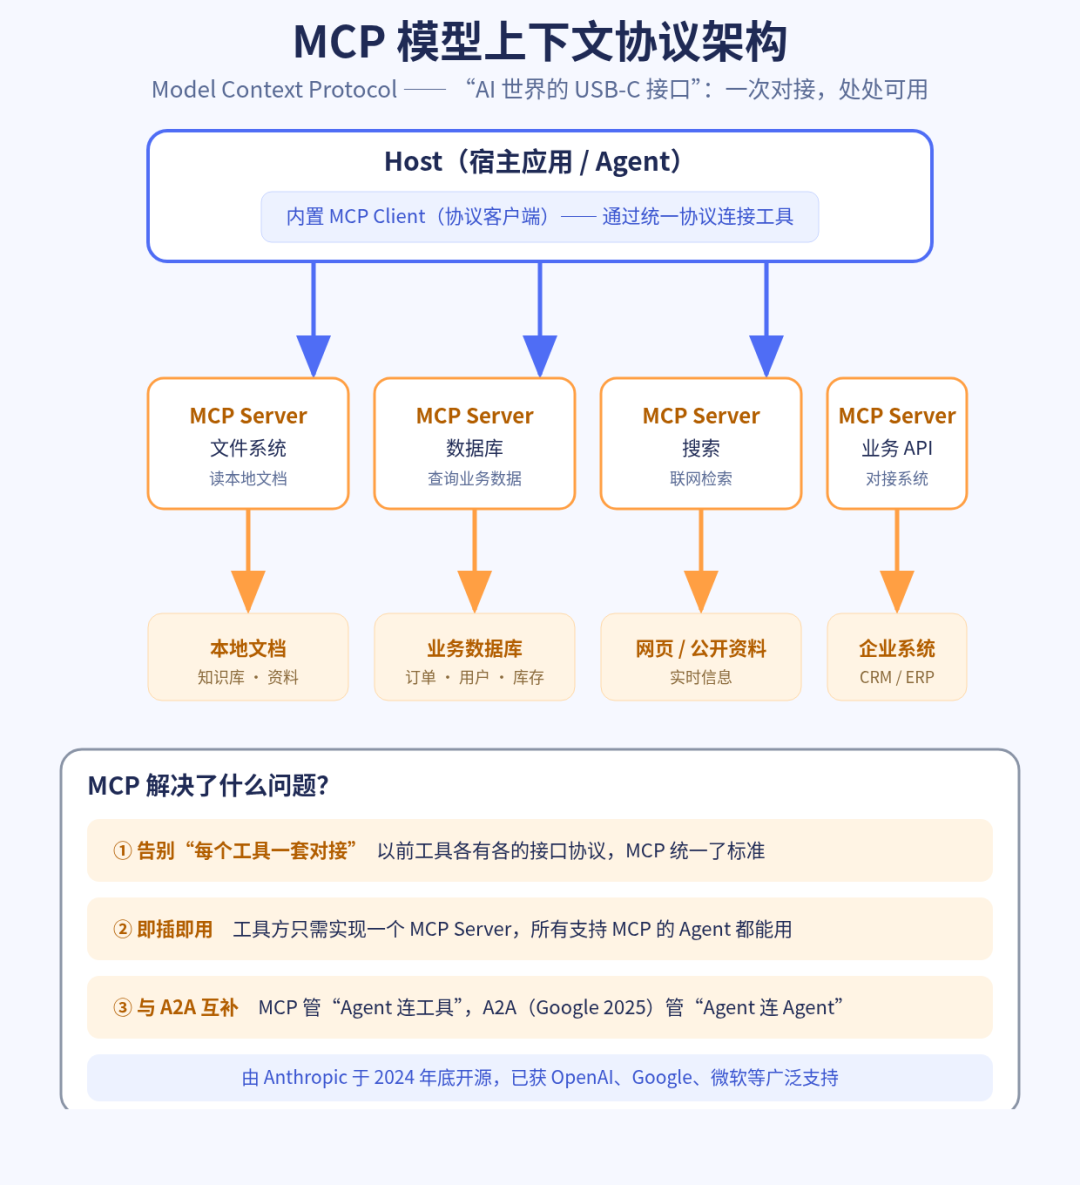
在 MCP 架构里:Host(如你的 Agent 应用)通过 MCP Client 连接 MCP Server,每个 Server 背后挂一个或多个外部数据源/工具。换工具时只需换 Server,Agent 本体不用改。
多智能体协作:
08 一张表看懂:LLM / Workflow / Agent / Multi-Agent 的区别
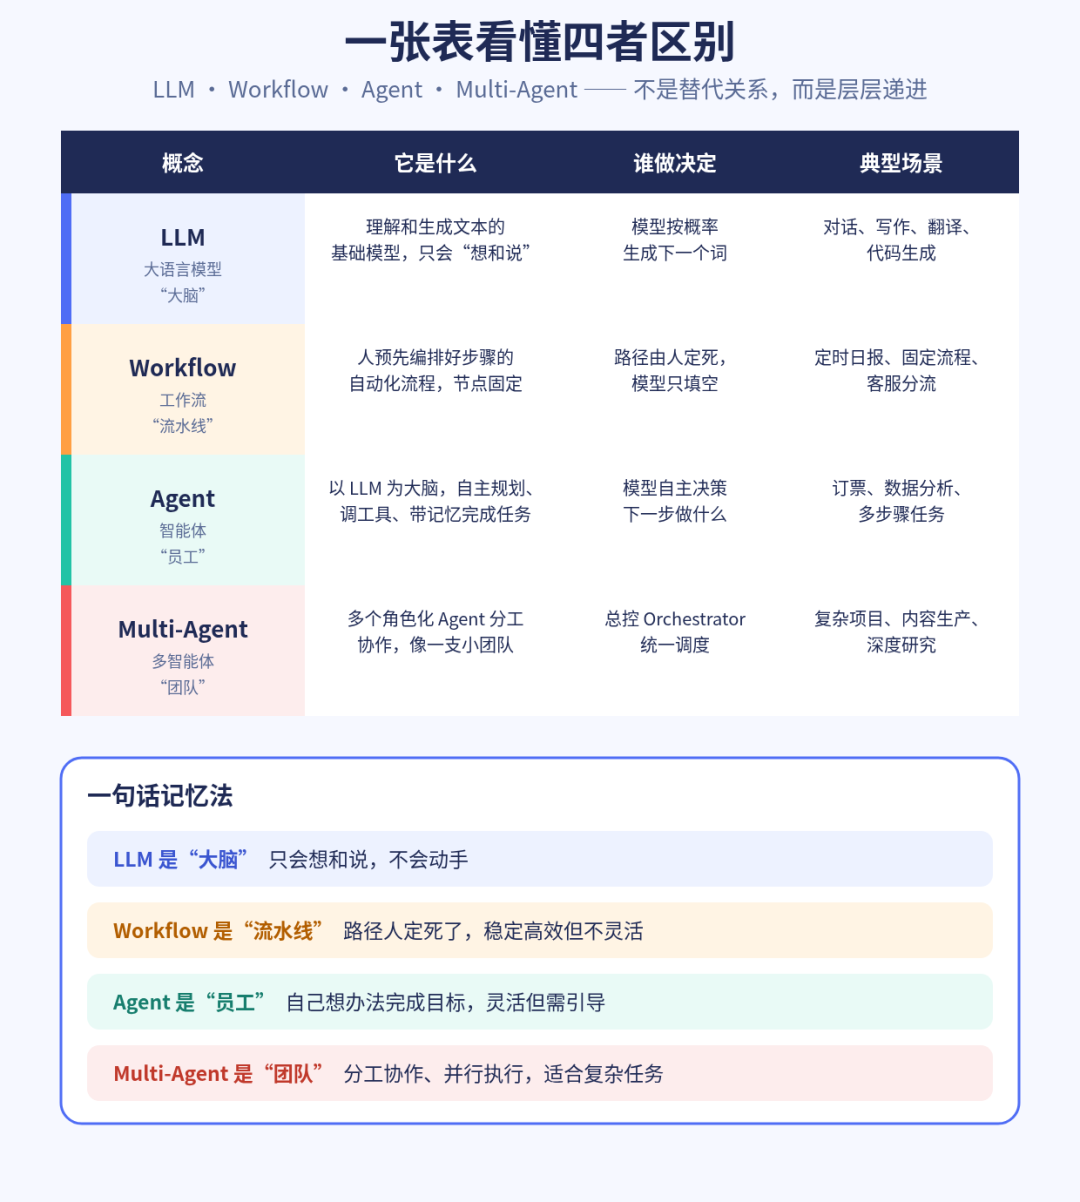
用一句话记忆:
- LLM
是"大脑",只会想和说;
- Workflow
是"流水线",路径人定死了;
- Agent
是"员工",自己想办法完成任务;
- Multi-Agent
是"团队",多个人分工协作。
写在最后
Agent 的生态还在快速进化,今天的热词明天可能就被新协议、新框架取代。但底层的逻辑是稳定的:让模型更强(模型层)、让模型能干更多事(能力层)、让模型能规模化协作(协作层)。
记住这个三层框架,以后再遇到任何新名词,你都能快速找到它在整个图景里的位置。
内容说明:本文为 AI 智能体技术科普,所涉术语与概念依据公开技术资料整理(包括 Anthropic MCP 官方文档、Google A2A 文档、LangChain 等框架公开资料);MCP 与 A2A 等协议细节可能随版本更新,请以官方文档为准。

相关文章


