



导读:让 AI 帮忙核对周末出游计划,发现博物馆周一闭馆,它没有傻傻报错,而是自己找了民俗馆当备选,还顺手测算了下车后的步行路况。
很多人看到这一幕忍不住惊呼:“AI 现在这么神了吗?它是一秒钟就把所有突发意外都算准了?”
但如果你真把它当成神机妙算的诸葛亮,很快就会被现实打脸:有时它像着了魔一样,同一个问题换着花样搜了 30 遍,在死胡同里原地打转,把额度和时间全耗光……
剥开玄乎的宣传,Agent 在后台究竟是怎么一步步做事的?它真能“未卜先知”吗?
痛点现场:现实世界充满意外,哪有什么“神机妙算”?
智能体(Agent)和只会动嘴的普通问答 AI 最大的不同,在于它长了手脚,能自己去碰壁、自己把事情往前推。
在那个出游案例中,当 AI 发现 A 博物馆周一闭馆时,它既没有两手一摊向你报错,也没有装聋作哑硬把闭馆的景点塞进行程,而是自主把目的地换成了民俗馆,并测算好下车步行只要 200 米。
这很容易给人一种错觉:这个 AI 太神了,它是不是在开局的一瞬间,脑子里就有一张算无遗漏的神奇蓝图,把所有可能出现的意外全部预判到了?
回想一下你自己的日常生活,就会发现这种想法有多不现实。
不管是带全家出游,还是在公司推进一个项目,现实世界永远充满了突发状况:
提前排好的路线,到了现场发现正在封路施工; 网上查着营业的餐厅,走过去才看到门口贴着“今日盘点暂停营业”; 约好的开会时间,临出门前客户突然通知要改期。
如果按照一套死板的既定程序去跑,它必须严格按照剧本走:“第一步去 A,第二步去 B”。一旦 A 馆闭馆,程序在剧本里找不到下一步,当场就会崩溃报错;或者像个睁眼瞎一样,硬生生把你带到紧闭的大铁门前。
现实中没有任何人、也没有任何 AI 能够提前预知所有意外。
Agent 之所以能把事情磕磕绊绊却实实在在地做完,靠的绝不是什么未卜先知,而是我们每个人都在用的最朴素的生存策略 —— “摸着石头过河”:
伸出一只脚踩在石头上,踩稳了,就顺势往前迈一步;
踩到一块石头是晃的、甚至踩空了,立刻把脚缩回来,在水里换个方向摸索另一块石头踩;
如此反复,直到安安全全走上对岸。
概念拆解:驱动 Agent 跑起来的“三步踏板”
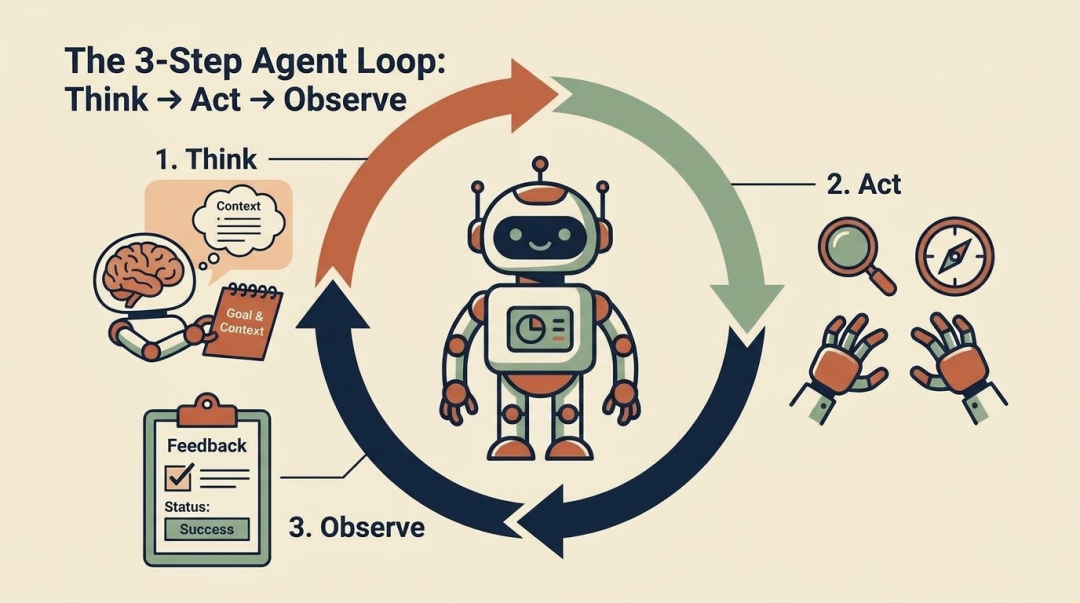
如果把 Agent 推进任务的过程放慢,你会发现它的内部其实跑在一个非常精巧的“三步转盘”上。
就像骑自行车踩踏板一样,它每踩完一圈,事情就往前走一步:
第 ① 步:看一眼(现状缺什么?)
Agent 会先审视手头的大目标(比如第 2 篇讲的 Prompt 约束:带老人、少走路、不自驾),以及当前眼前摊开的草稿纸(第 3 篇讲的 Context 上下文)。
它的大脑会问自己一个问题:“为了把这个目标往前推,我现在手里最缺什么关键信息?下一步最该干什么?”
第 ② 步:伸一下手(调用工具)
想清楚缺什么之后,它不会凭空瞎猜,而是从自己的工具箱里挑出一把合适的工具(比如打开网页搜索、打开地图算路线),正式发起一次真实的动作。
*(注:模型在聊天框里打字说“我去查查”不叫伸手,真正向外部系统发出执行代码才叫伸手。)*
第 ③ 步:拿回反馈(现实告诉我什么?)
外部工具执行完毕后,会把客观、真实的运行结果拿回来,直接拍在大模型的眼前。这个结果可能是惊喜(比如查到了平整步道),也可能是当头一棒(比如查到了闭馆公告)。
最关键的质变,就发生在第 3 步之后!
一旦拿回了这个客观反馈,大模型就会立刻带着这个最新发生的事实,回到第 1 步重新“看一眼”,并据此调整下一轮的动作!
在人工智能技术领域,普林斯顿大学和谷歌团队曾经在一篇里程碑式的论文里,把这套机制总结为 ReAct 范式(也就是 Reasoning 思考推理 + Acting 工具行动 的组合)。
不过,我们普通人根本不需要去背这些生僻的英文词。你只需要记住这个生动的画面:
Agent 的智能,不是一口气憋出来的神机妙算,而是一圈一圈踩着外部现实的反馈,不断自我修正推出来的。
渐进演练:放慢动作,看出游任务背后的 4 个回合
为了让你彻底看清这台自行车是怎么踩完一段复杂任务的,我们继续把上一篇带老人出游的案例拿出来,放慢 10 倍速,看看它的后台到底经历了哪 4 个回合:
你下达的任务依然是那句清晰的指令:
“请帮我核对周末两天的出游行程。原则:带老人、不自驾、尽量少走路。去查景点是否开放、交通是否合适。遇到冲突自己找备选,直到拿出一份能落地的方案。本次严禁替我订票付款。”
回合一:初探虚实(出师不利,迎头撞墙)
- 【看一眼】
:“要核实整个出游计划,第一站是周六早上的 A 博物馆。我得先搞清楚它那天到底开不开门。” - 【伸下手】
:从工具箱里挑出搜索工具,去抓取 A 博物馆官网的最新开放公告。 - 【拿反馈】
:官网公告冷冰冰地弹出一行字:“每周一例行闭馆进行设备检修。”
回合二:面对阻碍,自主掉头(撞了墙,换块石头踩)
- 【看一眼】
:闭馆的新事实摆在眼前。它的大脑立刻调整判断:“原计划周一去 A 馆彻底不可行了!但任务大原则是‘带老人、少走路’,我不能停下,必须在同区域寻找一个周一正常开门的同类型文化场馆。” - 【伸下手】
:再次调用搜索工具,检索该区域周一开放的备选场馆。 - 【拿反馈】
:搜索工具拿回了新情报:“同区域的民俗博览馆周一全天正常开馆。”
回合三:防范隐患,多方求证(光开门还不够,核实细节)
- 【看一眼】
:民俗馆确实开门了,但它没有直接草率地交差。它重新对照最初的红线约束:“老人走得动吗?光知道开门不算数,必须查清下了车还要走多远。” - 【伸下手】
:这一次它换了一把工具,调用地图测距工具,查询最近公交站到民俗馆大门的路况。 - 【拿反馈】
:地图工具反馈了确切数据:“出站后仅需步行 200 米,且沿途均为平整无障碍步道。”
回合四:达标收工,交付结果(所有条件闭环,刹车停步)
- 【看一眼】
:新备选开放中、公交直达、步行仅 200 米。重新比对最初的全部要求,没有新的冲突和未知数了。大脑判断:任务已经完成,不需要再调用任何工具了。 - 【交付】
:停止转动踏板,组织文字,向你端出一份带着核查依据的完整修订行程。
你看,在这个全过程中,AI 从来没有在开头就“猜中”A 馆会闭馆。它之所以能把事情做漂亮,是因为它在第二回合撞到“闭馆”这堵墙时,没有傻傻地撞死在墙上,而是把墙当成了新的路标,拐了个弯继续往前走。
终极对比:传统固定流程 vs 智能体反馈循环
很多人可能会好奇:以前我们用的自动化软件(比如某些一键处理表格的自动化脚本),不也是电脑自己在点鼠标、自己在调数据吗?它和 Agent 的循环到底差在哪?
看这张对比表就全明白了:
| 做事方式 | 严格按死剧本走 | 摸着石头过河 |
| 通俗比喻 | ||
| 遇到突发意外 | ||
| 核心依赖 | ||
| 适用场景 |
清醒认知:警惕 Agent 的“原地鬼打墙”(两根安全绳)
了解了它“走一步看一步”的运行逻辑,你不仅能学会怎么用好它,更能在关键时刻看出它的破绽。
既然 Agent 是根据反馈来决定下一步,那么请思考一个非常现实的隐患:如果外部现实一直不给它满意的反馈,会发生什么?
1. 翻车现场:死循环陷阱(走火入魔原地打转)
假设你让 Agent 去查一个非常偏僻的乡村农家乐的预订电话。
它查了一遍,没搜到; 大脑判断:“没搜到,那我换个关键词再搜一次;” 还是没搜到,大脑又判断:“那我换一个平台再去翻翻;” 依然没有,大脑继续判断:“那我搜搜隔壁村的农家乐试试……”
如果缺乏限制,它可能会像着了魔一样,在死胡同里原地狂转 30 圈甚至 100 圈!不仅任务没做成,还会把你的 Token 额度和漫长的等待时间全白白烧光。
因此,在任何一个靠谱的 Agent 系统背后,工程师都必须给它套上两根“安全绳”:
安全绳 ①:最大步数限制(强制刹车)
系统必须严格规定:这个踏板你最多只能踩 5 圈(或 10 圈)。如果试了 5 次依然没有突破,必须强制停下来,老老实实向人类求助:“我尝试了多种搜索方式仍未查到该电话,请您人工确认。” 不允许无限期原地打转。安全绳 ②:高风险动作严禁自主闭环(人工最终把关)
根据反馈自主调工具,仅限于查资料、算数据、理草稿等安全操作;一旦涉及到掏钱包付款、给重要客户发邮件、删除数据库等不可逆的动作,到了这一步必须强制弹出确认框,交由人类最终点击确认(行业里称之为 Human-in-the-loop)。
总结与下篇预告
如果用一句话来概括 Agent 的运行精髓:
普通程序靠“按死剧本演戏”,而 Agent 靠“撞了墙知道自己拐弯”。
它不是拥有超能力的神仙,它的所有聪明才智,全都建立在“尊重外部事实的反馈”之上。

相关文章


