



故事是这样的。
上周有个测试朋友把 AI 生成的「完整 Pytest 脚本」丢给我看。我打开一看,一个 test 函数,里面直接 requests.post,base_url 写死,断言只有 status_code == 200。他问我,这玩意能进回归吗。
我当时就愣住了。不是因为写得差,是因为这恰恰是现在最常见的用法。你随口问一句帮我写个下单接口自动化,它就给你一段能跑的代码。你觉得赚了。过两周接口路径改了,token 换了,异常场景补了,那段代码就变成团队里没人敢动的遗产。
坦率的讲,测试人缺的不是再多一段脚本,而是一套能反复用的工具箱。
课件里有三套动手教程,Pytest 脚本生成、JMeter 脚本生成、SQL 检测脚本生成。旁边还有一节综合实战,直接把三套入口焊成一个自动化测试 Skill 工具箱。我自己也还在摸索,但我觉得这套东西对日常测试工作,比再收藏十个 Prompt 有用得多。

测试人真正要的,不是脚本,是工具箱系统
你不是程序员,不需要天天从零搭框架。你也不是架构师,不需要把测试平台做成微服务。你就是一个要在迭代里把接口回归、性能摸底、数据对账同时扛住的测试。
我非常理解这种感觉。时间永远不够,领导要的是这周接口测完、压测给结论、对账别出事。
所以工具箱的目标很明确。不是临时生成几段代码,而是可重复使用、可评估质量、可持续扩展。
课件里写得很狠。有清晰入口,按任务类型选 Skill。有统一规范,安全和质量底线全入口共用。有标准交付,每次输出都带依赖、运行方式、风险提醒、人工确认点。有质量评分,生成结果可验收,不靠感觉可用。
普通提问和专业输出的差距就在这儿。你问帮我写个压测脚本,AI 可能只给你一个线程组加一个 HTTP 请求。专业 Skill 会逼它交出 CSV 参数化、Token 处理、业务断言、P95、错误率、Ramp-Up、风险提示。
回到这块。三套 Skill 的目录几乎长一个样。
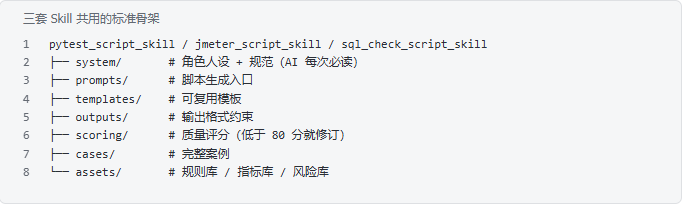
我一直觉得,测试人第一次用 Skill 最容易踩的坑,就是把一句 Prompt 当成全部。目录建好之后,AI 每次必读 system,按 templates 填,按 outputs 交,按 scoring 打分。这才叫系统。

综合实战那一节还把总目录做成 Automation_Test_Skill_Toolbox,下面挂 system、prompts、workflows、outputs、scoring、templates、cases、assets。三套入口共享同一套人工复核清单。环境是不是测试预发,有没有无 where 的 update,压测目标有没有业务方确认,鉴权场景能不能回滚,关键断言有没有覆盖业务状态。
这块需要注意一下。你往自己项目里嵌的时候,先别追求一次写满。课件自己都说了,第一版 Pytest Skill 不要求一次写满,先保证 system 加 1 个 prompt 加创建订单完整案例跑通闭环。
顺着上面的再聊聊。其实这三格对应的就是测试人手里最熟的三条线。接口测试那套,参数化、断言、Mock、日志追踪,平移到 Pytest Skill。性能测试那套,并发模型、P95、瓶颈定位,平移到 JMeter Skill。数据库校验和安全刹车,平移到 SQL 巡检。方法不用推倒重来,只是把「什么算过关」写进目录,让 AI 按同一套标准反复交卷。
Pytest 这一格,把接口回归做成工程
Pytest Skill 解决的,是 AI 给你一个 test 函数,和给你一套可维护工程,之间的鸿沟。
角色文件里写了五条必须遵守。输出完整工程结构,禁止只给单个 test 函数。请求必须封装到 api 目录。测试数据必须 YAML 参数化。断言必须包含 HTTP 状态码、业务 code、关键字段。必须覆盖正常流加异常流。
禁止行为也很刺耳。不得只断言 status_code == 200。不得把 base_url 和 token 写死。不得省略 fixture 与 conftest.py。
你想想看,这不就是你每次 code review 时想骂又懒得骂的那几条吗。
核心工作流是八步。接口文档,请求封装,数据参数化,断言分层,异常用例,fixture,环境配置,执行报告。
HTTP Client 建议单独封一层,接口路径变更时只改一处。

fixture 放 session 级 config、api_client,再放业务 API 和 token。token 那一行课件里写得很诚实,替换为你们项目的登录获取逻辑。我说理论上,是因为我自己还没在每个项目里完全跑通,但结构对了,后面就是填业务。conftest 建议放项目根或 tests 目录,别藏到子包里找不到。
怎么接到你自己的项目里。把创建订单换成你们最稳定的那条主链路接口。登录、下单、支付,选一条。先把 api、tests、data、config 四件套立住。异常场景至少覆盖缺必填、非法金额、重复提交。执行命令写进 outputs,报告用 pytest-html 或你们现有的就行。
评分维度里,配置和 fixture 是否合理就占 20 分。请求代码到处复制,直接扣。fixture 找不到,多半是 conftest.py 位置不对。
JMeter 这一格,压测不是点一下运行
很多测试人一提到 JMeter,就会想到线程组、HTTP 请求、监听器、点击运行。但真正的性能测试,不是把接口丢进工具里跑一下。
压测目标是什么。并发模型怎么设计。参数怎么变化。断言怎么判断。性能指标怎么看。瓶颈怎么定位。
AI 随便生成的脚本,最常见的坑课件都列了。只给线程数不说明 Ramp-Up。没有 CSV,所有线程用同一组数据。没有业务断言,只看 HTTP 200。正式压测还开查看结果树。没有定义 TPS、P95、错误率。没有数据污染风险。没有人工确认点。
订单创建的需求清单,我建议你直接抄到项目里。接口 POST /api/order/create。目标并发 500。持续 10 分钟。Ramp-Up 2 分钟。P95 < 800ms。错误率 < 1%。鉴权 Bearer Token。CSV 字段用户 Token、sku_id、address_id、coupon_id。
并发数别拍脑袋。课件用了一句很老派但好用的估算,并发数约等于 TPS 乘以平均响应时间(秒)。目标 TPS 300,平均 RT 0.5 秒,并发大约 150,再结合 Ramp-Up 和思考时间校准。
通过标准也要写死。TPS ≥ 300。P95 < 800ms。错误率 < 1%。应用 CPU < 80%。数据库连接数无持续打满。MQ 无持续堆积。
正式压测用非 GUI,调试阶段才开查看结果树。
jmeter -n -t order_create.jmx -l result.jtl -e -o ./report
这块需要注意一下。500 个线程若共用同一组 user_id / sku_id,结果会假得你自己都信。数据行数建议大于等于并发数,或者独立压测库。课堂演示的节奏我很喜欢,先 5 线程加查看结果树调试断言,再关结果树做 50 线程短压,别一上来 500 把测试环境打挂。
禁止对生产加压。这不是客气话。
评分满分 100。线程组、CSV、断言、指标、风险,各 20。没有断言扣 20,没有 CSV 扣 20。触犯就扣,别跟自己讲情面。
SQL 巡检这一格,数据对不上才是真事故
企业项目里,很多 Bug 不在单表,而在多表状态不一致。支付流水成功了,订单还是未支付。你临时写一条 SELECT,查完就忘。下周同样的坑再来一次。
SQL 检测 Skill 不是 SQL 片段集合,而是一套数据库风险检查系统。七步。明确检查需求。慢查询识别。索引检查。危险 SQL 识别。结果一致性校验。数据质量检测。自动巡检报告。
危险 SQL 规则库建议你直接搬进项目。update 或 delete 无 where,P0。select * 大表,P1。深分页大偏移,P1。like 前后模糊,P1。无条件批量 update,P0。
检测脚本可以「发现」风险,不得在生产自动执行任何 update 或 delete。生产环境仅只读 SELECT。
支付订单一致性是核心案例。检测目标是识别支付流水成功但订单未同步的数据。风险等级 P0。影响模块是支付、订单、财务对账。处理建议去查支付回调、订单状态更新、MQ 消费、事务提交。人工复核点是是否真实扣款、是否影响用户订单。

巡检报告字段要固定。检测时间、环境、目标、执行 SQL、异常数量、异常样例(最多 5 条脱敏)、风险等级、影响模块、处理建议、人工复核点。有了这些,SQL 检测才从个人临时查询,变成团队可追踪资产。
怎么嵌进项目。把你们最怕的三个一致性场景写进 cases。支付订单、优惠券核销、库存扣减,选你们真实在炸的。发版 checklist 加一条,预发环境跑一遍 P0 一致性脚本。无真实库时,用 DDL 样例加假设异常条数做表格推演也行,结构先立住。质量评分发布前自检,一致性规则覆盖、风险等级、处理建议、人工复核点,缺一项就打回去。低于 80 分不要进巡检任务。
一周就能嵌进你正在测的项目
综合实战给的联动顺序,我建议你就按这个来,别把四类任务塞进一个 Prompt,输出会乱成一锅粥。
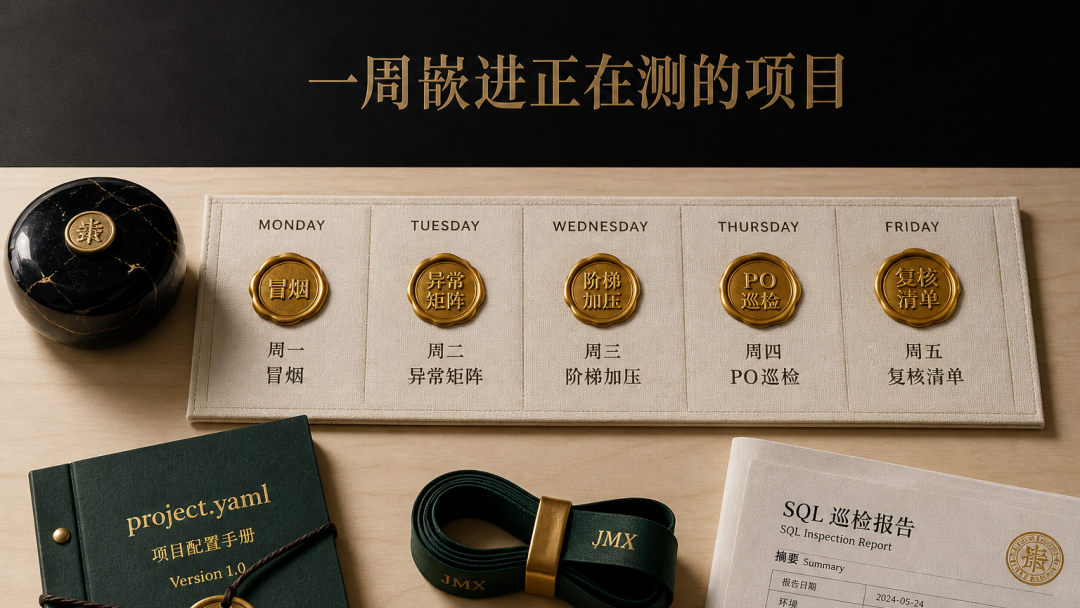
周一,把接口文档、环境配置、脱敏账号字典丢进工具箱的 assets。用 Pytest 入口生成主链路自动化工程,先跑冒烟。
周二,补异常矩阵。缺必填、非法金额、重复提交、鉴权失败。评分低于 80 就改 prompts 或规则库,不要改一次生成结果就完事。
周三,用 JMeter 入口出压测方案。先 5 再 50,指标和风险写进方案,再谈目标并发。
周四,用 SQL 入口出 P0 一致性巡检。报告字段对齐你们现有的缺陷单。
周五,把人工复核清单过一遍。环境、高风险 SQL、压测确认、越权回滚、业务断言。能过的才进回归包。
一开始可能会有点笨拙,花的时间比手动写还长。这正常。你是在把个人经验焊进目录,不是在炫技。
资料自取,骨架加核心代码直接套

资料这块,课件附录写得很实在。接口文档、用例清单、环境模板、压测目标说明、核心表 DDL、历史慢查询、危险 SQL 事故记录。你手头有什么就往对应目录扔,越贴近真实项目,Skill 越不像玩具。
需要完整目录树、角色文件、Prompt、评分表和案例模板的,文末走资料自取。我把三套 Skill 的骨架和核心代码整理成一份可直接套用的包。你改表名、改接口路径、改并发数,就能开始用。
可能有些想法还不成熟。但我始终坚信一件事。测试人的核心价值,从来不是手速写脚本,而是把「什么算过关」写清楚,再让机器按这个标准反复执行。

相关文章


