



同一张显卡为何会有多个"算力"数字?理清单位、精度与稀疏三个概念,就能看穿厂商的参数游戏。
一张显卡的"多重身份"
在统计GPU算力时,很多人都会遇到同一个困惑:同一张显卡,为什么能报出好几个完全不同的数字?
比如RTX 5090,有人说是1.6 PFLOPS,有人说是3300 TOPS,还有人说是6.6 PFLOPS。再比如H100,官方写的是1979 TFLOPS,而评测文章写的却是989 TFLOPS。这些数字哪个是对的?其实都对,但它们描述的是这块芯片在不同工作模式下的性能。这背后藏着三个容易混淆的概念:单位、计算精度和是否开启稀疏计算。搞懂这三层逻辑,你就能看懂任何一张AI芯片的规格表。
算力的两套基本单位
AI芯片的算力主要通过两套单位来描述,它们针对的是不同类型的数据运算。
FLOPS 是"每秒浮点运算次数"(Floating Point Operations Per Second)的缩写,用于衡量芯片处理浮点数(带小数点的数字)的能力。它涵盖了多种精度,比如FP64(双精度)、FP32(单精度)、TF32(NVIDIA的截断精度)、FP16/BF16(半精度)、FP8(8位浮点)以及Blackwell架构新增的FP4(4位浮点)。其单位换算遵循十进制:1 PFLOPS等于1000 TFLOPS,1 EFLOPS等于1000 PFLOPS。
TOPS 是"每秒万亿次整数运算"(Tera Operations Per Second)的缩写,用于描述芯片处理整数(不带小数点的数字)的能力,常见于INT8、INT4等精度。手机SoC和边缘AI芯片的宣传中常出现这个单位,因为推理阶段对精度要求较低,使用整数运算能大幅提高吞吐量并降低功耗。
一张显卡为何能报出"六七个"算力数字
以RTX 5090为例,其在不同精度下的理论峰值如下:
FP32:104 TFLOPS
FP16 / BF16(Tensor Core):1614 TFLOPS(≈1.61 PFLOPS)
FP8(Tensor Core):≈3.3 PFLOPS
FP4(Tensor Core):≈6.6 PFLOPS
INT8:≈3300 TOPS
INT4:≈6600 TOPS
很多人看到这张表的第一反应,是试图把这些数字加起来,得出一个"总算力"。这种做法是错误的。原因很简单:这些数字描述的是同一套Tensor Core硬件在不同工作模式下切换出来的峰值性能,并非几种独立算力的叠加。这就像同一台发动机的"最高时速"和"百公里加速时间",它们衡量的是不同维度的能力,不能相加。
精度越低,算力数字为何越高?
核心原因在于数据位宽。精度越低,每个数字占用的位数就越少。硬件电路的数据总线宽度相对固定,当位宽减半时,一个周期内能塞进去处理的数据量理论上就能翻倍。这就是为什么AI芯片厂商在"精度"上越卷越低——从FP32到FP16,再到FP8和FP4,同样的晶体管数量,精度每降一级,账面算力就能显著提升,这是让发布会PPT"好看"的最直接路径。
当然,这种"降精度换算力"并非没有代价。位宽越小,能表示的数值范围和精度就越粗糙。因此,工业界普遍采用分层策略:训练阶段对精度要求高,多用BF16/FP8;推理阶段对吞吐和功耗要求高,常用FP8/INT8甚至FP4/INT4。
被忽略的第三个变量:稀疏算力
除了单位和精度,规格表里还藏着第三个变量——是否开启结构化稀疏。这个变量足以让数字再次翻倍。
以NVIDIA H100 SXM5为例,对于FP16 Tensor Core,其稠密算力是989.5 TFLOPS,而开启结构化稀疏后,算力跃升至1979 TFLOPS。其他精度下也是同样的翻倍关系。这是因为从Ampere架构开始,NVIDIA的Tensor Core支持"2:4结构化稀疏"加速技术,即人为地将权重矩阵中每4个数字清零2个,硬件专门针对这种规律进行加速,从而使理论吞吐翻倍。
关键点在于:这个"2倍"是理想情况下的理论峰值,前提是模型权重必须经过对应的稀疏化处理。许多厂商默认展示的就是这个稀疏峰值(因为数字更好看),但绝大多数生产环境中的模型并未严格按此规则优化。因此,你在实际使用中很难摸到这个理论值。这就是为什么同一款GPU,不同文章会报出差一倍的算力数字——一个写稠密算力,一个写稀疏算力,两者都对,但描述的并非同一件事。
主流AI芯片算力横评
把上述逻辑套用到当前几款主流芯片上,可以看得更清楚(数值为官方或行业公认的稠密Tensor Core峰值):
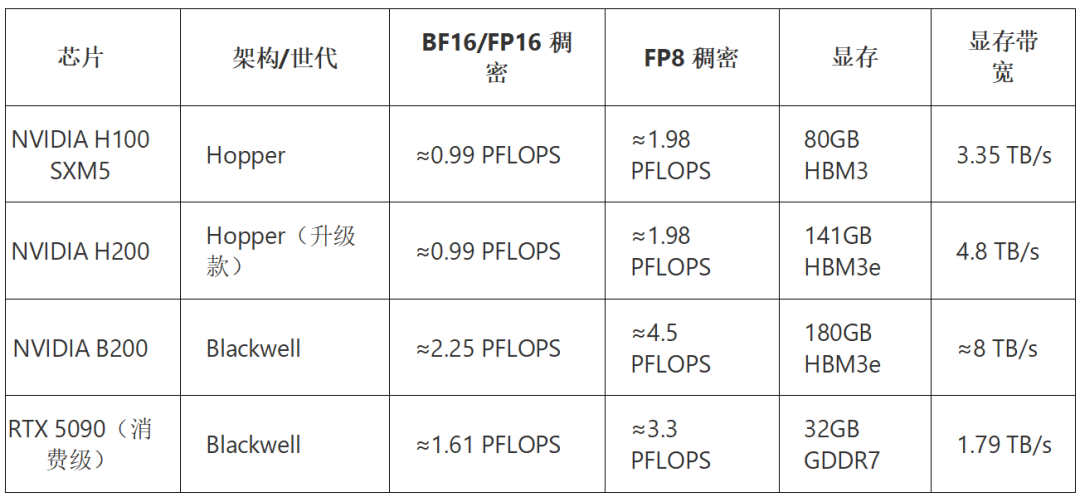
从这张表能看出几个规律:每一代架构升级,都在"同样面积内塞入更多低精度算力";消费级显卡在低精度算力账面数字上可能超越上一代数据中心卡,但显存容量和带宽仍是数据中心卡的护城河;比较不同代际芯片时,必须对齐同一精度,不能只看PFLOPS数字简单判断性能。
算力背后的隐形瓶颈:显存带宽
理论峰值算力往往发挥不出来,瓶颈常出在"喂数据"的速度上。业内有个经典分析框架叫Roofline Model(屋顶线模型),它揭示了一个任务是"算力受限"还是"带宽受限",取决于其运算强度(总浮点运算次数÷ 需搬运的数据字节数)。运算强度高(如大矩阵乘法),GPU大部分时间在计算,能接近理论峰值;运算强度低(如大模型逐token推理),GPU大部分时间在等待数据从显存搬运过来,实际吞吐远低于理论值。
大语言模型的"逐token自回归生成",恰恰是典型的带宽受限场景。因此,衡量推理性能时,显存带宽(GB/s或TB/s) 这个指标的重要性不亚于PFLOPS。H200相比H100,算力峰值接近,但显存带宽提升约45%,在实际大模型推理任务中的吞吐提升往往比账面算力涨幅更明显。
理论峰值与真实性能:MFU
厂商公布的PFLOPS都是理论峰值,是硬件在完全理想状态下的上限。真实任务几乎不可能达到。业内用MFU(Model FLOPs Utilization,模型算力利用率) 来衡量实际利用了多少理论算力,即实际有效浮点运算次数除以理论峰值。
头部实验室在训练超大模型时,MFU能做到40%-55%已属优秀;很多团队的实际项目可能只有20%-30%。导致MFU打折的因素包括:显存带宽不足、多卡通信开销、算子优化不到位、超参数不匹配、数据加载跟不上等。因此,看到"用10万张H100训练模型"的报道时,不能简单用"卡数×单卡峰值算力"去估算算力产出,中间还要打一个MFU的折扣,这个折扣往往是工程实力的真实体现。
为什么FP8和INT8数值相近,但不能换算
FP8大约是3.3 PFLOPS,INT8大约是3300 TOPS。两者数字接近,常让人误以为本质一样。其实不然。两者吞吐量接近,是因为都是8bit位宽,Tensor Core每个时钟周期能处理的数据"份数"相近。但FP8算的是浮点运算,INT8算的是整数运算,这是两套完全不同的数制和硬件电路,单位不同,不能互相换算,更不能相加。
为何算力统计常用BF16口径
各类算力普查、政府算力中心备案、GPU集群规格表,几乎统一要求填写PFLOPS(默认BF16/FP16口径)。原因很简单:目前绝大多数大模型的训练以及相当一部分推理,仍以BF16/FP16作为主力精度。虽然FP8在推理侧日益普及,但BF16是业界最具共识、最不容易因"精度选择"而产生数字争议的统计标准。
实战排查:如何判断GPU是否被"喂饱"
理论讲完,回到实操。最常用的GPU监控命令是nvidia-smi。但这里有个常见误区:GPU-Util显示97%,并不代表算力用到了97%。这个指标只表示在采样周期内,GPU上至少有一个内核在执行的时间占比,它不关心Tensor Core是否用满、运算强度高低或实际吞吐量。一个带宽受限的推理任务,GPU-Util同样可能显示99%,但MFU可能只有10%-20%。
更细粒度的排查可以使用nvidia-smi dmon -s pucvmet -d 1命令。其中sm列是计算利用率,mem列是显存控制器利用率。如果sm高、mem低,说明任务偏计算受限,比较健康;如果sm低、mem高,通常说明遇到了带宽瓶颈。此外,检查clocks.current.sm是否等于clocks.max.sm,可以判断GPU是否因温度或功耗墙而被降频。
一个重要事实:nvidia-smi从不直接报告当前实际跑了多少TFLOPS。要精确测量算力利用率,需要使用NVIDIA Nsight Systems、DCGM或PyTorch Profiler等专业工具,手动计算MFU。
避坑速查表
看到一个算力数字时,先问自己这五个问题:
这是FLOPS(浮点)还是OPS/TOPS(整数)?单位不同,不能混比。
这是哪个精度下的数字?精度不同,数字差数倍,不对齐精度的比较无意义。
这是稠密还是稀疏峰值?稀疏峰值通常是稠密的2倍,留意规格表里的小字标注。
这是理论峰值还是实测吞吐?理论峰值≠真实性能,中间隔着MFU。
这个场景是算力受限还是带宽受限?大模型推理的瓶颈往往是显存带宽,而非PFLOPS。
总结
FLOPS/PFLOPS表示浮点算力,TOPS表示整数算力。同一块芯片会针对不同精度给出不同峰值,这些数值对应的是同一套硬件在不同工作模式下的性能,不能相加,也不能直接互相换算。同时,要分清稠密与稀疏峰值,并清醒认识到理论峰值与实际可用性能(MFU)之间的巨大差距。真正决定大模型训练和推理体验的,往往不只是那个最显眼的PFLOPS数字,显存容量、显存带宽和多卡互联能力同样关键。
往期回顾

相关文章


