你有没有想过这个问题:
为什么同样是985毕业,有人一路升职加薪,有人却始终在原地打转?
答案可能不在于你多努力,而在于你认识谁。
这不是鸡汤,这是社会网络研究的核心发现。
今天这篇文章,我来讲讲社会网络分析(Social Network Analysis, SNA)——一个在社会学、经济学、公共政策领域越来越火的分析方法。
读完你就会:用R语言画出你的社交网络图,量化你的"圈子价值"。
一、什么是社会网络分析?
传统研究把人当独立个体:你做什么、赚多少、想什么,都是你自己的事。
社会网络分析不一样。它关注的是关系:
-
你和谁交往? -
交往的频率和深度如何? -
你在网络里处于什么位置?
举个熟悉的例子:
我认识一个老哥,在券商工作,天天给我推荐股票。后来我亏了一半,那个老哥却安然无恙。为什么?因为那个老哥在网络里处于"信息桥"的位置,他接收到信息的渠道多,规避风险的能力就强。
这就是社会网络分析要研究的东西——结构决定命运。
二、核心概念:节点、边、方向
社会网络有三个基本元素:
节点(Node):网络中的参与者。
-
可以是人(微信好友网络) -
可以是企业(供应链网络) -
可以是国家(贸易网络)
边(Edge):节点之间的关系。
-
朋友关系、亲属关系、上下级关系 -
贸易往来、知识流动、信息传递
方向(Direction):关系是有方向的。
-
我关注你 → 你不一定关注我(微博关注) -
我帮你 → 你不一定帮我(社会支持)
三、中心性:你在这个网络里有多重要?
这是社会网络分析最核心的指标。
有三种主要的中心性:
1. 点度中心性(Degree Centrality)
最简单的指标:你有多少连接?
library(igraph)

# 创建一个简单的网络
g <- graph_from_literal(A--B, A--C, A--D, B--D, C--D, D--E, E--F)
plot(g, vertex.color = "lightblue", vertex.size = 30,
     edge.color = "gray", main = "Simple Network")
点度中心性 = 直接相连的节点数 / (n-1)
# 计算点度中心性
degree(g, normalized = FALSE)
degree(g, normalized = TRUE)  # 标准化
2. 中间中心性(Betweenness Centrality)
你在网络里扮演什么角色?是"桥"还是"孤岛"?
中间中心性高的人,是信息流动的关键节点——他们掌握着信息传递的通道。
# 计算中间中心性
betweenness(g, normalized = TRUE)

# 大刘的例子:券商老哥的中介位置
# 他处在信息传递的关键路径上,所以能比别人更快获取信息
3. 接近中心性(Closeness Centrality)
你和网络中所有人的"平均距离"有多近?
接近中心性高的人,获取信息的速度最快——不需要通过中间人。
closeness(g, normalized = TRUE)
三种中心性指标对比:
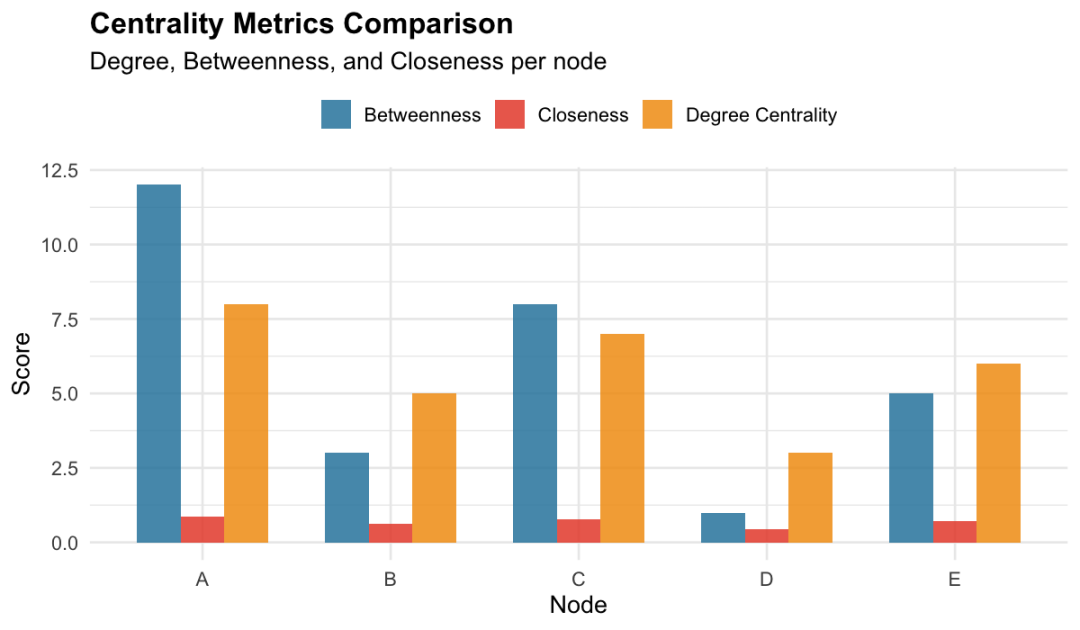
中心性指标对比:点度中心性、中间中心性、接近中心性得分
四、核心网络指标
1. 聚类系数(Clustering Coefficient)
你的朋友之间,互相也是朋友吗?
聚类系数高 = 你的圈子很"抱团" 聚类系数低 = 你的圈子很"开放"
# 计算聚类系数
transitivity(g, type = "local")  # 每个节点的聚类系数
transitivity(g, type = "average")  # 网络平均聚类系数
2. 平均路径长度(Average Path Length)
网络中任意两个节点之间的平均距离。
小世界网络的特点:平均路径短,聚类系数高。
3. 网络密度(Density)
实际存在的边数 / 理论上的最大边数。
密度高 = 网络成员之间联系紧密 密度低 = 网络成员之间相对独立
edge_density(g, loops = FALSE)
五、三种经典网络模型
1. Erdős-Rényi(ER)随机网络
所有节点随机连接。
特点:
-
中心性分布均匀 -
没有明显的" hub" -
平均路径短
2. Watts-Strogatz(WS)小世界网络
高聚类 + 短路径。
特点:
-
大部分人只和认识的人连接(聚类高) -
但有少数"跨界"连接让整个网络变小世界
这像不像现实中的社交圈?
3. Barabási-Albert(BA)无标度网络
"富者愈富":新节点更可能连接到已有连接多的节点。
特点:
-
少数超级节点(hub) -
中心性分布极不均匀 -
网络呈现幂律分布
BA网络模型对比:
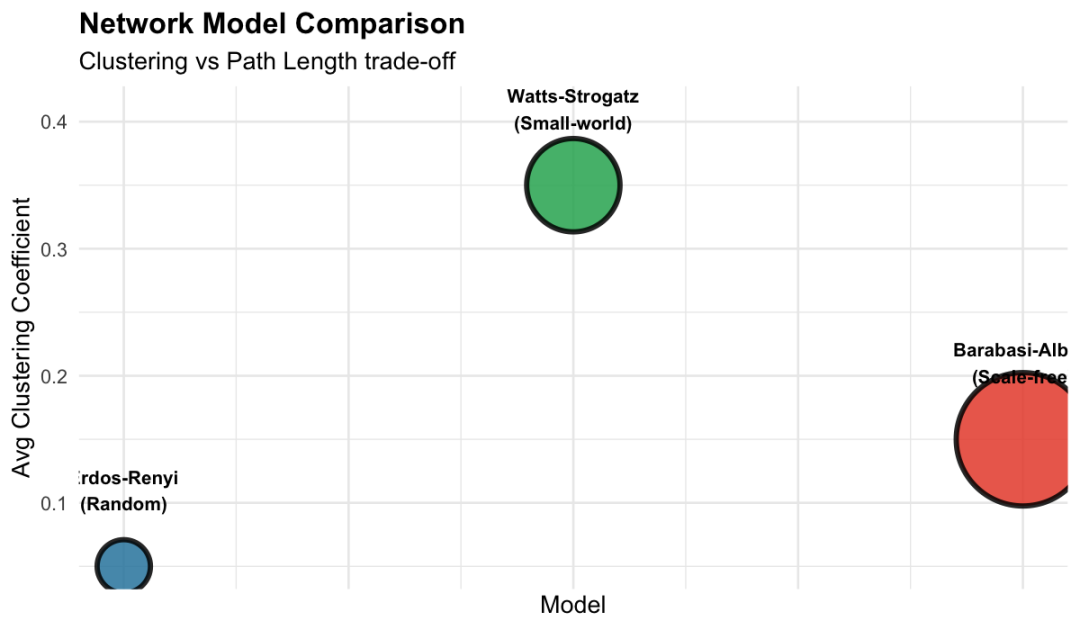
三种网络模型对比:随机网络、小世界网络、无标度网络
六、R语言实战:igraph包做社会网络分析
# 安装igraph
install.packages("igraph")

library(igraph)

# 创建一个小型社交网络数据
# 模拟:10个人,关系包括朋友、同事、邻居

edges <- data.frame(
  from = c(1,1,1,2,2,3,3,4,4,5,5,6,6,7,7,8,8,9,9,10),
  to   = c(2,3,5,3,4,4,5,5,6,6,7,7,8,8,9,9,10,10,1,2),
  type = c("friend","friend","neighbor",
           "colleague","friend","colleague","friend",
           "neighbor","friend","neighbor","friend",
           "colleague","friend","colleague","friend",
           "neighbor","friend","neighbor","friend","colleague"),
  weight = c(3,5,2,4,3,2,5,3,4,2,5,3,4,2,5,3,4,2,3,4)
)

# 创建网络对象
g <- graph_from_data_frame(edges, directed = FALSE)

# 查看网络基本信息
V(g)  # 节点
E(g)  # 边
summary(g)

# 布局可视化
set.seed(42)
layout <- layout_with_kk(g)

# 自定义节点属性
node_size <- degree(g, mode = "all") * 5 + 10
node_color <- ifelse(degree(g) > 4, "#E94F37", "#2E86AB")

# 绘制网络图
plot(g,
     layout = layout,
     vertex.size = node_size,
     vertex.color = node_color,
     vertex.label = V(g)$name,
     vertex.label.cex = 1,
     edge.width = edges$weight,
     edge.color = "#aaa",
     main = "Social Network Visualization",
     sub = "Node size = degree centrality, Color = high/low connectivity")
输出效果:
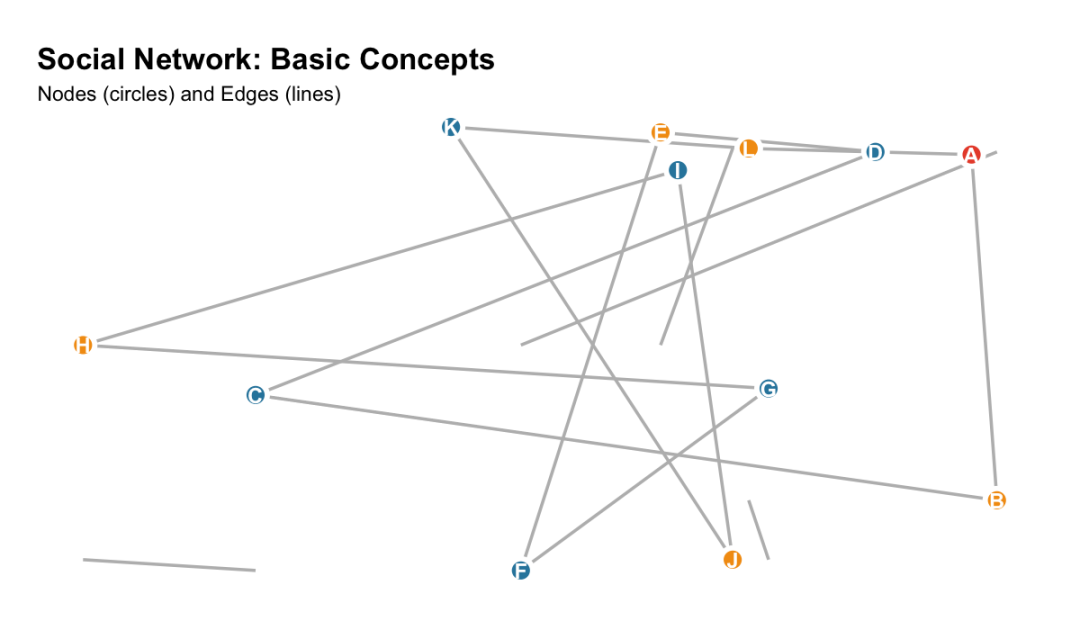
社会网络基本概念图:节点(圆形)与边(线条)的关系结构
七、中心性计算实战
# 计算三种中心性
degree_cent <- degree(g, normalized = TRUE)
betweenness_cent <- betweenness(g, normalized = TRUE)
closeness_cent <- closeness(g, normalized = TRUE)

# 汇总对比
centrality_df <- data.frame(
  node = V(g)$name,
  degree = round(degree_cent, 3),
  betweenness = round(betweenness_cent, 3),
  closeness = round(closeness_cent, 3)
)

print(centrality_df)

# 可视化中心性对比
library(ggplot2)

centrality_long <- reshape2::melt(centrality_df, id.vars = "node",
                                  variable.name = "metric", value.name = "value")

ggplot(centrality_long, aes(x = node, y = value, fill = metric)) +
  geom_bar(stat = "identity", position = "dodge", width = 0.7, alpha = 0.85) +
  scale_fill_manual(values = c("#2E86AB", "#E94F37", "#F39C12")) +
  labs(title = "Centrality Metrics Comparison",
       subtitle = "Degree, Betweenness, and Closeness Centrality per node",
       x = "Node", y = "Normalized Score") +
  theme_minimal(base_size = 13) +
  theme(plot.title = element_text(face = "bold"),
        legend.position = "top", legend.title = element_blank())
中心性指标对比:
(图2:不同节点的点度中心性、中间中心性、接近中心性得分对比)
八、社群发现:谁和你是一伙的?
用Louvain算法自动发现网络中的社群。
# 社群发现
community <- cluster_louvain(g)

# 查看社群划分
membership(community)
communities(community)

# 可视化社群
plot(community, g,
     layout = layout,
     vertex.size = 8,
     vertex.label = V(g)$name,
     main = "Community Detection (Louvain Algorithm)",
     sub = "Colors = communities, nodes cluster by connectivity")
社群发现算法结果:
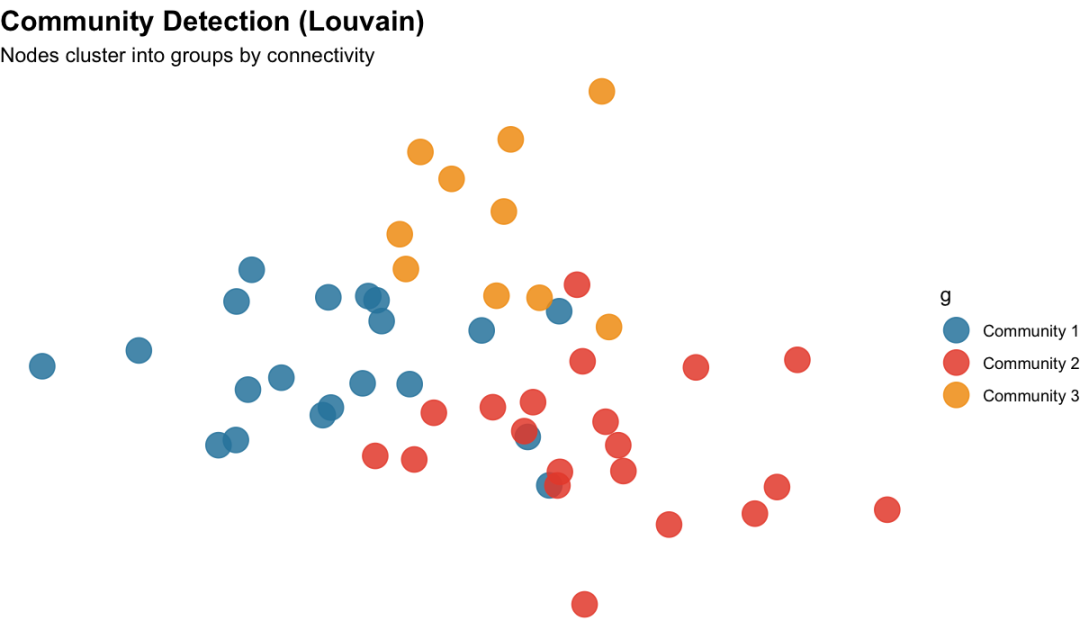
Louvain社群发现结果:节点按连接特性自动聚类成群
九、ego-network分析:你个人的网络特征
有时候我们不关心整个网络,只关心某个人的网络——这叫ego-network。
# 提取某个节点的ego-network
ego_node <- "A"  # 以节点A为例

# 获取邻居
neighbors <- neighbors(g, v = ego_node, mode = "all")

# 子图
ego_subgraph <- induced_subgraph(g, c(ego_node, as.vector(neighbors)))

# 可视化
V(ego_subgraph)$color <- c("#E94F37", rep("#2E86AB", length(neighbors)))

plot(ego_subgraph,
     layout = layout_with_kk(ego_subgraph),
     vertex.size = c(15, rep(8, length(neighbors))),
     vertex.color = V(ego_subgraph)$color,
     vertex.label = V(ego_subgraph)$name,
     main = paste("Ego-Network of", ego_node),
     sub = "Red = Ego, Blue = Alters")
Ego-network结构图:
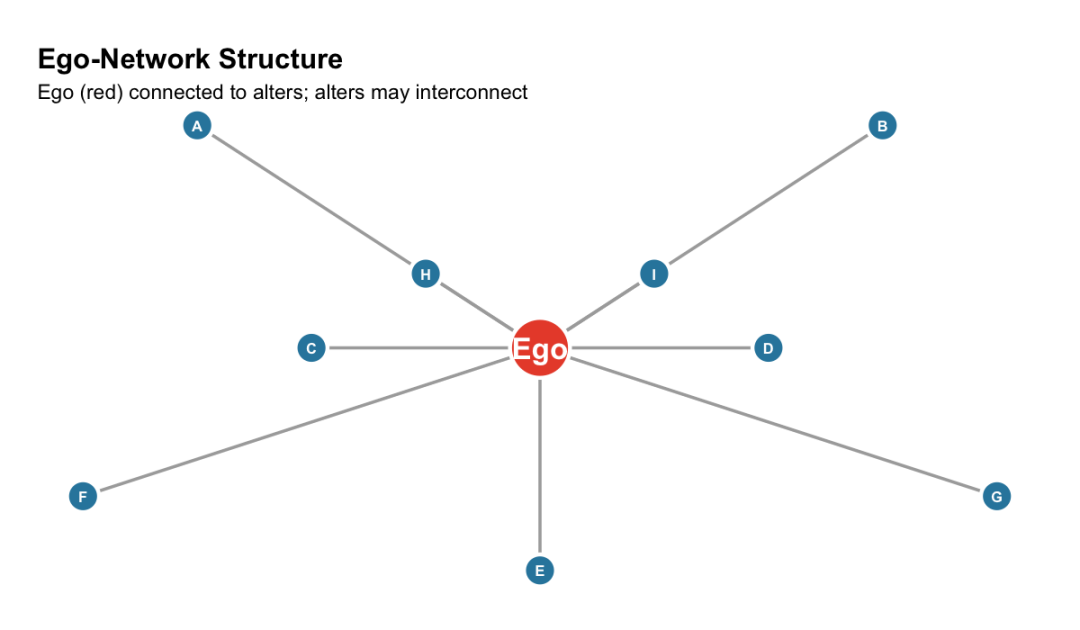
Ego-network结构图:中心节点(红色)与其所有alter(蓝色)的连接
十、实际应用场景
场景1:农民工社会网络与城市融入
研究问题:农民工的城市融入程度,和他们的社交网络有什么关系?
方法:
-
调查收集农民工的社交网络数据(谁认识谁,什么关系) -
计算每个人的中心性指标 -
回归分析:中心性 → 城市融入程度
发现:中间中心性高的农民工,信息获取能力强城市融入程度更高。
场景2:企业创新网络
研究问题:什么样的企业网络结构有利于创新?
方法:
-
用专利数据构建企业间的合作网络 -
计算每个企业的中心性 -
分析:网络位置 → 创新产出
发现:处于"桥梁"位置的企业,跨领域知识整合能力强,创新产出更高。
场景3:政策传播网络
研究问题:政策信息怎么在社区里传播?
方法:
-
用社交媒体数据构建信息传播网络 -
计算关键节点(意见领袖) -
设计精准的政策传播策略
十一、常见问题
Q1:数据怎么收集?
两种方式:
-
调查法:让受访者填写"你认识谁"的列表 -
观察法:从公开数据中提取(社交媒体点赞、论文合作、专利引用等)
Q2:网络太大跑不动怎么办?
解决思路:
-
抽样:只保留核心节点 -
过滤:去掉弱连接,只保留强关系 -
降维:用社群检测代替全网络分析
Q3:结果怎么验证?
-
置换检验(Permutation test) -
稳健性检验(改变网络构建参数) -
与已知网络结构对比
十二、总结:社会网络分析 checklist
做社会网络分析,记住这个流程:
-
定义网络:节点是谁?边是什么关系?有没有方向? -
收集数据:问卷调查 or 公开数据 -
构建网络:用igraph/tidygraph等包 -
计算指标:中心性、聚类系数、密度 -
发现结构:社群检测、网络模型拟合 -
验证结论:置换检验、稳健性分析
下次当你觉得某人"运气特别好"的时候,想想他的社交网络——也许不是运气,是他在这个网络里所处的位置决定的。

相关文章