中央网信办9月2日通报:"清朗·整治AI应用乱象"专项行动第二阶段累计清理违法违规信息561万余条,查处账号4.9万余个,处置违规网站、应用程序等2400余个;
抖音、腾讯、百度、小红书等平台优化多模态识别模型,豆包、元宝、千问、文心一言严把语料审核关,华为、小米、OPPO、vivo应用商店拦截违规APP入库。被治理的核心不是"内容由AI生成",而是虚假、仿冒、低俗、侵权、未履行标识。对做GEO的企业,信号已经很直白:用AI逃避责任的时代结束,让真实品牌事实更容易被发现、理解和核验,才是接下来的唯一合规路径。
一、监管打击的不是AI,而是“用AI逃避责任”
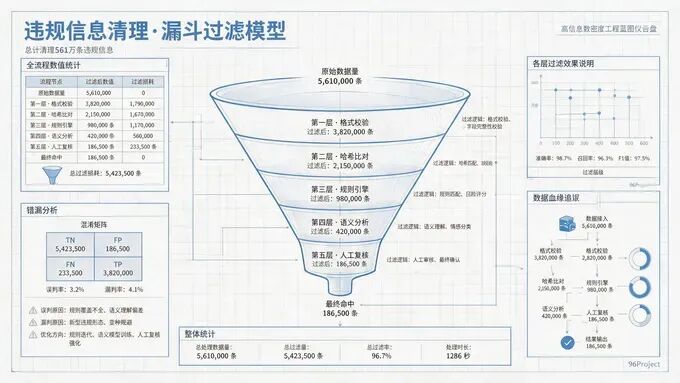
从官方通报看,被治理的共同点并非“内容由AI生成”,而是虚假、仿冒、低俗、侵权、操纵舆论及未履行标识等行为。
AI降低了生产成本,也降低了造假门槛。一张虚假灾害图、一个冒充专家的数字人、几千个自动评论账号,可以在短时间内制造“很多人都这么认为”的假象。
当这种信息进入搜索和大模型的证据池,风险会继续放大:模型可能把伪造共识整理成答案,再由用户当作决策依据。
二、GEO为什么必须与“投毒”划清界限
中央网信办在专项行动第一阶段已明确提到,以伪造权威数据、恶意营销等方式实施AI数据投毒属于治理对象。
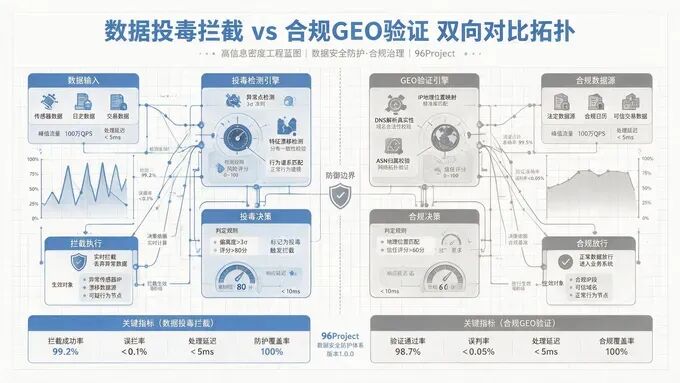
因此,GEO不能被理解成给模型“喂得足够多”。真正合规的工作,是让真实品牌事实更容易被发现、理解和核验;投毒则是用伪造、重复和操纵,让AI误以为某个结论更可信。
两者的差别不在技术手段,而在证据是否真实、商业关系是否披露、用户是否被误导,以及品牌是否愿意为内容负责。
三、品牌的内容资产需要增加“证据身份证”
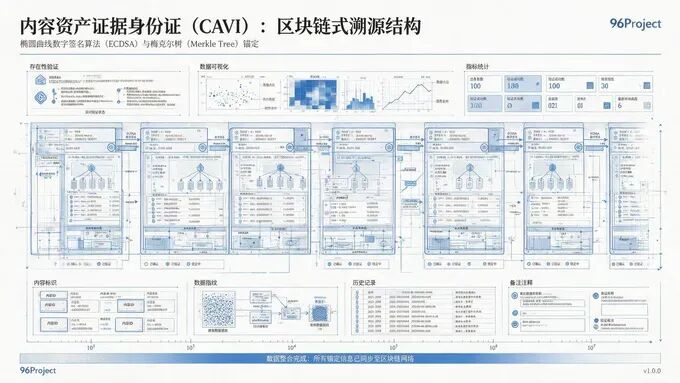
每一条关键事实至少要回答五个问题:谁发布、依据是什么、何时有效、由谁确认、发生变化后如何更新。
产品功效应绑定检测或合规材料,案例应说明主体与授权,市场数据应标明统计口径,专家观点应保留身份来源,AI辅助内容应按规则标识。
这套工作看起来比批量发稿慢,却决定了内容能否长期存在。未来平台不仅识别文本,还会比对人脸、声纹、来源、时间与账号行为。造假的边际成本正在上升,可信资产的复利反而开始显现。
四、企业现在应立即停止的三类动作
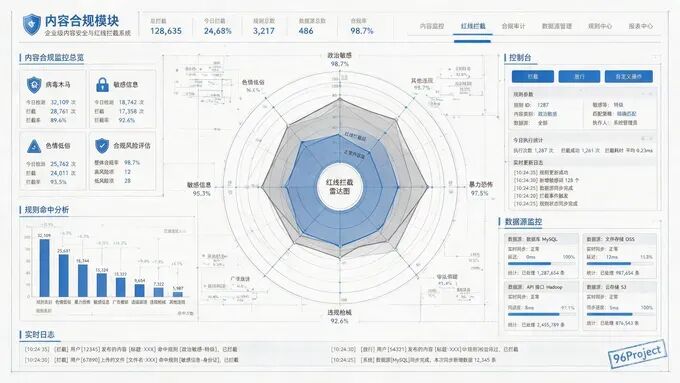
第一,停止用虚构媒体、虚构专家和虚构用户评价制造信任。
第二,停止用大量相似账号和同质内容营造假共识。
第三,停止把AI生成稿直接发布,尤其是医疗、金融、法律、公共事件和未成年人相关内容。
与此同时,企业应建立内容审核责任人、事实台账、授权记录、版本管理和下线机制。发布不是流程终点,纠错能力同样是品牌信用的一部分。
五、可信将成为AI推荐时代最昂贵的稀缺品
当低质量内容近乎无限,AI和平台真正需要筛选的就不再是“有没有信息”,而是“哪条信息值得相信”。
监管收紧并不意味着品牌没有机会,恰恰意味着那些愿意建设真实证据、统一口径、明确边界的企业,将更容易被区分出来。
GEO的未来不是让AI被内容包围,而是让AI在关键问题上能找到一组来源清楚、彼此印证、可以追责的事实。清朗行动清理的是污染;品牌现在要建设的,是经得起验证的知识基础设施。
信息来源与事实边界
中央网络安全和信息化委员会办公室《中央网信办深入开展“清朗·整治AI应用乱象”专项行动第二阶段工作》,2026年9月2日;第一阶段工作通报,2026年7月6日。

相关文章