用 AI 辅助编程已经成为很多开发者的日常,但不少人在月底看账单时都会倒吸一口凉气:Token 怎么消耗得这么快?
Token 是 AI 计量的基本单位,你和 AI 说的每一句话、AI 回复的每一个字、它读取的每一个文件、调用的每一个工具,全都要折算成 Token 计费。更关键的是——每进行一轮对话,之前的历史上下文都要重新计算一遍。这意味着浪费会被不断放大。
本文盘点 AI 编程中最常见的 Token 浪费现象,并给出可落地的解决方案。
一、这些行为正在悄悄烧掉你的 Token
1. 装了一大堆用不上的 Skill / 插件
很多人的习惯是:看到有趣的 Skill 就装,功能相似的还装好几个。问题在于,已安装的 Skill 描述会在每次会话开始时注入系统上下文。哪怕你这次任务根本用不到它们,这些描述也会白白占用每一轮的 Token。三个功能重叠的插件,就是三倍的固定开销。
2. 提问太笼统,让 AI 去"猜"
❌ "帮我优化一下这段代码。" ❌ "这个报错怎么回事?"(然后不贴报错)
提问过于笼统时,AI 只能猜测你的意图:猜目标、猜环境、猜约束。猜错了,你要纠正;纠正完,它再猜。一个本可以一轮解决的问题,硬是聊成了五轮——而每一轮都带着完整的历史上下文重新计费。
3. 不会用专业术语,描述全靠"感觉"
"那个页面上方的东西点了一下没反应"——这样的描述,AI 需要先帮你把口语翻译成技术概念,再定位问题。而"点击导航栏的 <Button> 组件后,onClick 回调未触发,控制台无报错"这样的表达,AI 可以直接进入排查。专业术语不是炫耀,而是压缩信息量的编码方式。
4. 一个上下文窗口聊到天荒地老
这是最容易被忽视、也最烧钱的习惯。对话历史会随轮次累积:第 20 轮提问时,前面 19 轮的内容会全部作为上下文再算一遍 Token。一个聊了 10 万 Token 的窗口里再问一句"顺便改下颜色",这句简单的话可能要付出数万 Token 的代价。
5. 粘贴"全集"而不是"关键片段"
报错时把 500 行完整堆栈 全贴进来,而关键错误只有最后 3 行; 把 整个文件 发给 AI,而需要修改的只有其中一个函数; 把 整份日志 丢给 AI,而不是先自己 grep出 ERROR 行。
6. 让 AI 重复劳动
同一个文件,AI 读过了,你又让它"再看看这个文件"; 已经生成过的代码,换个说法让它重新生成一遍; 文件只需要改一行,却让它 全量重写 整个文件(输出 Token 往往比输入更贵)。
7. 每个新会话都重新口述一遍项目背景
"我的项目是用 React + TypeScript + Tailwind 写的,目录结构是……"——每次开新会话都打一遍这段话,一年下来是一笔可观的开销。这类稳定信息应该沉淀到 项目级规则文件(如 AGENTS.md、CLAUDE.md)或记忆功能中,让 AI 自动加载。
8. 大炮打蚊子:简单问题动用重型模式
问一个 API 的拼写,也开着深度研究模式;查一个已知的语法,也让 AI 联网搜索五轮。工具越重,链路越长,Token 消耗越大。简单问题就该用简单方式解决。
9. 纵容 AI 盲目试错
不给出明确约束,AI 就会"猜一个方案 → 运行 → 报错 → 再猜 → 再运行"。每一轮试错都是实打实的 Token。给足上下文和约束,是减少试错轮次的最有效手段。
二、解决方案:省 Token 不等于省质量
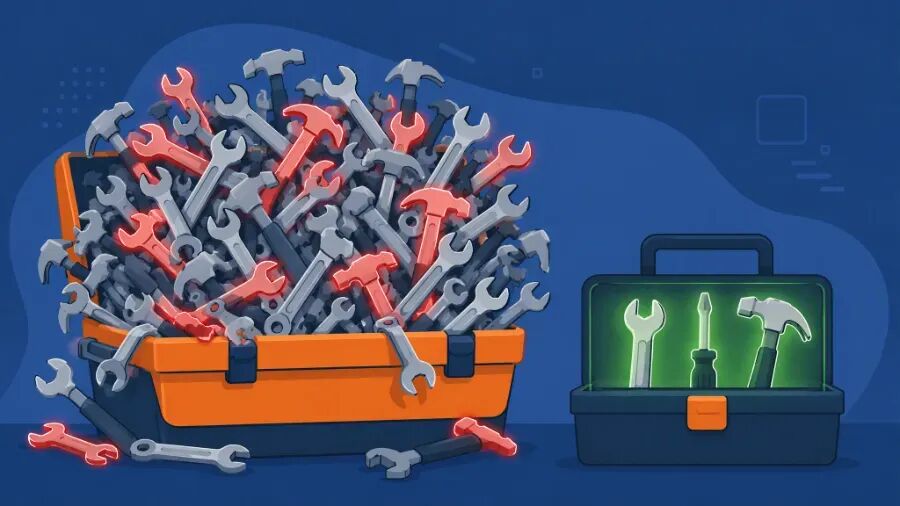
很多人担心:省 Token 会不会让 AI 输出质量下降?其实恰恰相反——高质量的输入本身就是省 Token 的。因为精准的提问减少了来回纠错的轮数,而纠错才是最大的浪费源。
方案 1:定期给 Skill / 插件"断舍离"
只安装 当前阶段真正需要 的 Skill,用完即卸; 功能重叠的只保留一个(对比后留下最贴合你工作流的); 每月检查一次安装列表,把"装完就没用过"的清掉。
方案 2:掌握"精准提问公式"
一个好提问 = 角色 + 任务 + 上下文 + 约束 + 输出格式
✅ "你是前端专家。任务:修复这个 React 组件的内存泄漏。上下文:组件在路由切换后定时器未清除,相关代码如下(贴出 20 行关键代码)。约束:不能改动组件的对外 props。输出:只给出修改的代码 diff 和一句原因说明。"
对比"帮我看看这个组件有没有问题",前者一次到位,后者至少三轮。记住一个原则:你多花 1 分钟写清楚问题,AI 少花 5 轮猜测,省下的 Token 远超你打字的那几个。
方案 3:学会用专业术语和结构化表达
说"导航栏组件"而不是"上面那个东西"; 说"接口返回 401"而不是"登录好像坏了"; 贴代码时带上语言标记、文件名、行号; 描述问题时用"预期行为 / 实际行为 / 复现步骤"三段式。
方案 4:主动管理上下文窗口
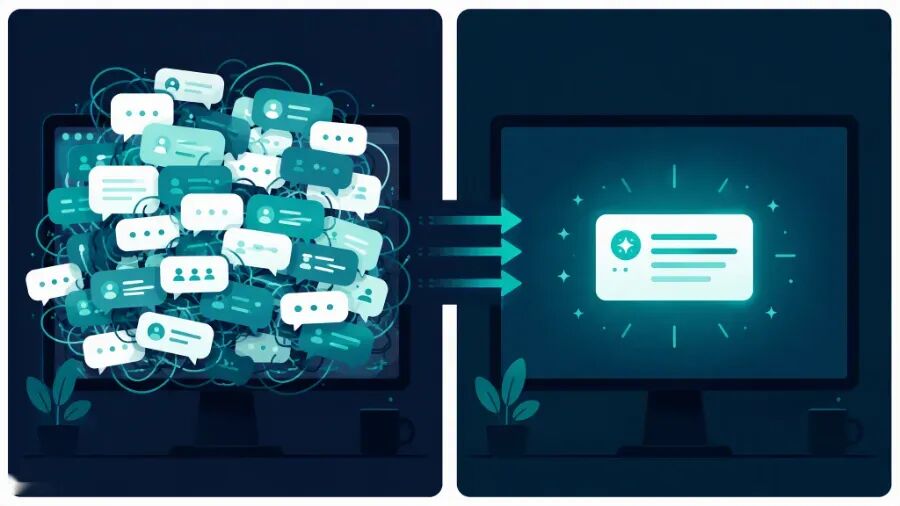
上下文管理是省 Token 的核心战场:
一个会话只做一件事。任务完成,立刻开新会话;不要在写了三小时后端代码的窗口里突然问前端样式。 善用压缩命令。上下文变长时,使用 /compact(或等价功能)把历史压缩成摘要,只保留关键结论再继续。该清就清。话题切换时用 /clear清空历史,而不是让无关内容继续占坑。长任务分段。大任务拆成几个阶段,每个阶段结束时让 AI 输出一份"交接摘要",新会话直接从摘要开始,而不是拖着几万 Token 的历史前进。
方案 5:给"关键片段",不给"全集"
报错只贴 错误本身 + 上下 5 行,长堆栈先自己过滤; 改 bug 只贴 相关函数,并说明它在哪个文件里; 日志先用 grep ERROR、tail -50筛一遍再贴;如果 AI 需要更多上下文,它会主动要——按需供给比一次性灌入更省。
方案 6:控制 AI 的输出量
输出 Token 通常比输入更贵,管不住输出的长度,预算就管不住:
明确说"只输出修改的部分 / diff",而不是全量重写文件; 明确说"先给方案大纲,我确认后再展开",避免 AI 一次生成 3000 字你却只要其中一段; 简单问题注明"一句话回答"。
方案 7:把稳定信息沉淀成"记忆"
在项目根目录维护 AGENTS.md/ 规则文件,写清技术栈、目录约定、代码规范——AI 每次自动加载,不用你反复口述;利用工具的长期记忆功能保存个人偏好(如"回复用中文""代码风格用 2 空格缩进")。
方案 8:给足约束,减少试错轮次
在让 AI 动手前,先告诉它:运行环境是什么、哪些命令不能跑、目标效果是什么、验收标准是什么。约束越清晰,AI 的首次命中率越高,盲目试错的轮次就越少。
三、一张速查表
/compact 压缩、及时 /clear | ||
AGENTS.md / 记忆功能 | ||
四、结语
省 Token 的本质,不是"少说话",而是提高每一轮对话的信息密度。
把 AI 当作一位计费昂贵但能力很强的同事:你不会让他猜你的需求,不会把整箱文件倒在他桌上让他自己找,也不会在已经讨论了三小时的会议末尾随口加一个无关议题。
精准提问、精简上下文、按需供给、控制输出——做到这四点,你会发现:Token 省下来了,AI 的输出质量反而更高了。

相关文章