这是我 AI 开发阶段的主干实践。前端的工程化纪律、全栈的链路意识,在这一步被重新组织成一条可复用的 AI 研发流水线,后面讲评审、测试、契约的文章,都拿它当地图。
先说我的判断:大多数人用 AI 写代码,还停留在「光标后面补两行」,出 bug 了再问一句「这怎么报错了」。这跟当年用 IDE 自动补全区别不大,只是更聪明了点。
真正让玩法变了的,是把整条研发链路摊开,让 AI 在每一步都进场,把它当成流水线上的工位,而不是高级补全。下面这套,是我们团队跑了一年、产出近百万行代码之后沉淀下来的工作流,每一步都经过真实项目验证。
全链路总览
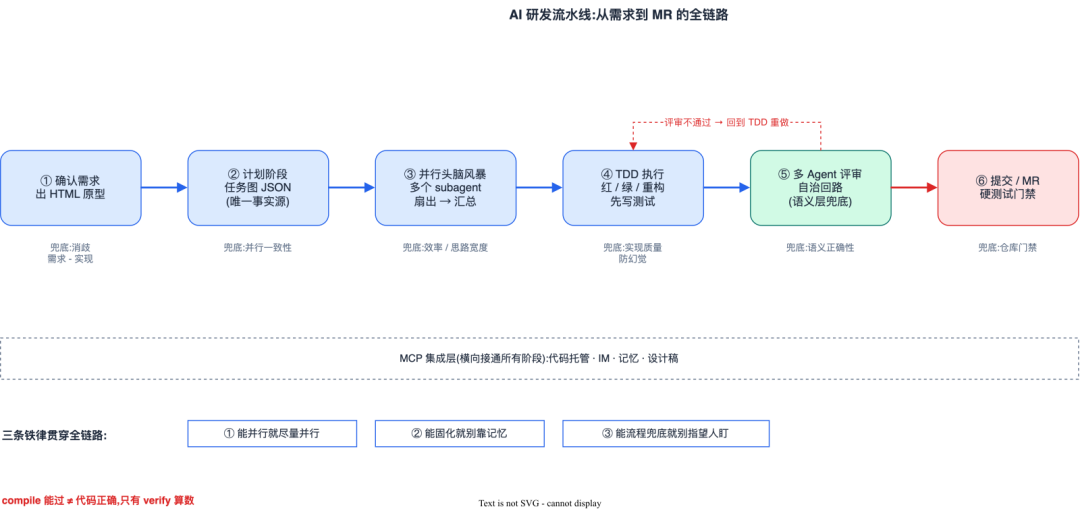
整条链路长这样:
- 确认需求 → HTML 原型 → 计划 → 多轮并行头脑风暴 → TDD 执行(红/绿/重构)→ 自治多 Agent 评审 → 提交/MR。
每一步都不是「问 AI 一句话」那么简单。每一步都对应一个明确的兜底目的:消歧、一致性、效率、质量、语义正确性、仓库门禁。如果某一步的兜底目的你能用别的方式达到,完全可以替换——但目的不能省,流程可以变。
第一步:需求之后,先出 HTML 原型
确认需求之后,先出 HTML 原型,而不是直接开写。
原因很直接:对着空气写需求,人和 AI 都容易跑偏。需求文档里的「支持商品管理」「首页可配置」这种描述,十个人能脑补出十种界面。先把界面用 HTML 画出来,需求和实现的歧义在原型阶段就消掉了大半。
具体做法是:需求一确认,丢给 AI 让它先出一版静态 HTML 原型。不用漂亮,关键是把关键页面、关键交互画出来。这个 HTML 后面会被丢掉,但它的价值不在产物本身,而在「强迫双方把模糊的需求变成具体形状」。
我们踩过一次坑:一个「会员权益」的需求,文档写得清清楚楚「会员可见专属价格」,直接让 AI 写代码,实现成了所有商品都展示会员价、非会员看不到价格——但实际需求是所有用户都看得到原价,只有会员额外看到优惠价。这种歧义,如果先出 HTML 原型,5 分钟就能在原型上发现。
原型阶段的产出不是代码,是共识。 这一步省下来的成本,是后面返工的好几倍。
第二步:计划阶段,确立唯一事实源
计划阶段是整个工作流里我最强调的一环。
做法是做两轮计划,产出一份任务图 JSON,并约定它是唯一事实源。两轮计划分别是:
- 粗计划
:让 AI 把需求拆成大块(「前端」「后端」「数据迁移」三层),每块标个范围。 - 细计划
:在大块内,把任务拆到半天到一天可完成的粒度,每个任务标明:输入是什么、输出是什么、依赖谁。
最终的产物是一份任务图 JSON,长这样:
{ "tasks": [ { "id": "T-001", "title": "订单详情接口", "layer": "backend", "input": ["订单 schema (T-000)"], "output": ["GET /api/orders/:id"], "depends": ["T-000"], "status": "todo" }, { "id": "T-002", "title": "订单详情页", "layer": "frontend", "input": ["GET /api/orders/:id (T-001)"], "output": ["订单详情.vue"], "depends": ["T-001"], "status": "todo" } ] }这条规矩的本质是解决并行的一致性:每个 agent 各自理解任务、各干各的,很快撞车——你改的文件我也要改,我设计的接口跟你对接不上。任务图摆在中间,谁做什么、依赖谁,一目了然。
没有这个事实源,并行越多越乱。我们最早期没有任务图,3 个 agent 同时开工,2 小时后发现其中两个都在改同一个文件,另一个 agent 设计的接口字段名和后端实际写出来的对不上——整上午白干。引入任务图之后,这类撞车基本消失。
任务图是唯一事实源的意思是:所有 agent 只信这份 JSON,不信自己脑子里的理解。任务状态变化(从 todo 到 doing 到 done)也只更新这份 JSON,不让 agent 自己声称「我做完了」——状态以 JSON 为准。
第三步:多轮并行头脑风暴
然后是多轮并行头脑风暴。
我们有一条近乎硬约束的原则:能开并行 subagent 就尽量多开,团队甚至把「尽可能多地开并行 subagent 执行」写进了规矩里。
两种用法的本质区别在于:
- 串行问 AI
,是把它当搜索引擎。 - 并行扇出去
,是把它当一支团队——同一个问题让多个 agent 同时从不同角度去想,再汇总。
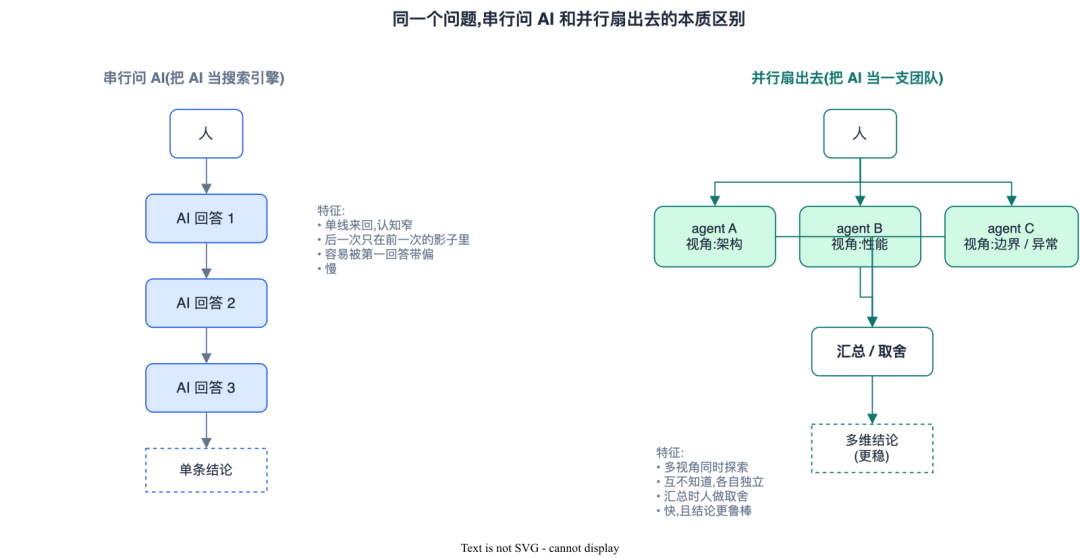
效率和质量都不是串行能比的。
举个具体场景:设计一个多租户 AI 助手的工具调用桥接。串行做法是问 AI「设计一下工具调用桥接」,得到一版方案,觉得不放心再追问。并行做法是同时开 3 个 subagent:
- agent A 视角:架构
——怎么把工具定义和 AI 框架解耦。 - agent B 视角:性能
——并发调用怎么处理,会不会卡死。 - agent C 视角:边界 / 异常
——工具调用失败、超时、循环调用怎么兜。
三个 agent 互相不知道彼此存在,各自独立产出方案。汇总时,你会发现 A 的架构 + B 的性能预警 + C 的异常处理拼起来,正好是一份完整的、鲁棒的设计。串行问 AI 永远得不到这种多视角叠加——因为后一次问答永远在前一次的影子里,容易被第一回答带偏。
这里有个反模式要避坑:很多人误以为「并行」就是把一个任务拆成 N 份让 N 个 agent 各做一份,然后挑最好的。这不是并行,这是「抽卡」。真正的并行是让每个 agent 用不同的视角看同一个问题,汇总时人来做取舍。视角不同,结论才会互补;任务相同,只是抽 N 次卡,白白浪费算力。
第四步:TDD 执行,红 / 绿 / 重构
执行阶段走 TDD:红、绿、重构。
我的做法是让 AI 先写测试,再看着测试补实现,而不是直接写实现。理由是:
-
AI 写测试比写实现在行——实现容易「幻觉」。 -
测试要贴合真实行为,反而能反过来约束实现。
具体节奏是这样的:
- 红
:让 AI 先写测试用例(覆盖正常路径 + 边界 + 异常),此时实现还没写,测试必然全红。 - 绿
:看着测试,让 AI 补最简实现,只求测试转绿,不追求优雅。 - 重构
:测试都绿了,再让 AI 优化实现结构(抽取重复、改善命名、补注释),这一步测试必须始终是绿的,任何重构让测试变红就立刻回滚。
为什么不让 AI 直接写实现?因为直接写实现时,AI 的优化目标是「让代码看起来对」,而不是「让行为正确」。先写测试,等于先把「正确」的定义钉死,实现只是去逼近这个定义。质量比「直接写实现」高一个台阶。
一个真实数据:切到 TDD 之后,我们 code review 阶段发现的 bug 数下降了大约 40%。不是因为 AI 写得更少了,而是因为错误被测试在第一时间暴露,不会拖到 review 阶段。
第五步:自治多 Agent 评审回路
执行完不是直接提交,而是过一道自治多 Agent 评审回路。这是整个系列的灵魂,细节我单独写了一篇,这里只说它在工作流里的位置。
它是提交前的最后一道闸。评审完、收敛了,还要再过一道硬测试门禁才允许走 MR。
评审回路和 TDD 的分工很清楚:
- TDD 兜实现层
——单个函数、单个模块的行为对不对。 - 评审回路兜语义层
——跨模块、跨层、跨文件的设计是否合理,逻辑是否一致。
举个例子,TDD 能保证「订单详情接口在传入正确 ID 时返回正确数据」,但保证不了「前端调用的接口路径和后端注册的路由是否对得上」——这种跨层契约,TDD 测不到,正是评审回路要补的盲区。
工作流的尾巴不是「人觉得写完了」,而是「流程判定它能进仓库了」。这一条特别重要:人的「我觉得写完了」是最不可靠的信号,真正的信号是「评审回路通过 + 测试门禁通过」。
第六步:MCP 集成,接通项目孤岛
再补一块容易被忽略的拼图:MCP 集成。
我们主力按使用频率是 Claude Code、Cursor、OpenCode,同时通过 MCP 把代码托管、IM、记忆、设计稿这些孤岛接进来。
接通之前,AI 是个「瞎子」:你粘贴什么它看什么,你不粘贴它就不知道。设计稿在 Figma 里,代码托管在 GitHub 里,项目约定在某个飞书文档里,AI 一个都看不到。结果是 AI 写出来的东西「看着像,但和这个项目的真实约定对不上」——名字风格不对、目录结构不对、复用不了已有的工具函数。
接通之后,AI 不再是只能看你粘贴代码的「瞎子」,而是能自己看设计稿、翻仓库、查记忆里记下的项目约定。输出从「看着像」变成了「真的贴合这个项目」。
MCP 不是接一个工具,是接通整个项目上下文。这一步省下来的「人工解释项目背景」时间,远超配置 MCP 的成本。
本质:把「人盯」变成「流程兜底」
链路走顺之后,我的判断是:工作流的本质,是把「人盯」变成「流程兜底」。
以前人在每一步盯着:需求对不对、代码乱不乱、提交前跑没跑测试。问题是人会累、会忘、会偷懒。现在把判断挪进流程:
- 任务图
兜一致性。 - 并行
兜效率。 - TDD
兜实现质量。 - 评审回路
兜最终门禁。
人和流程的分工也很清楚:人定方向、做取舍、处理例外;流程跑例行、做校验、兜底线。流程接管得越多,人能腾出来思考的越多。
链路是不是太重了?
有人会问:这套链路是不是太重了?
我的回答是:链路是骨架。具体到一个 bugfix,你当然可以跳过原型、跳过头脑风暴。但骨架要在。
有流水线而选择不用,和压根没有流水线,是两回事。
判断什么时候该走完整链路、什么时候可以跳步,本身也是一种工程能力。我们的原则是:
- 新功能 / 大改动
:走完整链路,一步不省。 - bugfix / 小调整
:跳过原型和头脑风暴,但 TDD + 评审回路必走。 - 配置 / 文档
:只走计划 + 提交两步,其它都跳。
判据很简单:这次改动会不会影响别人?会不会跨层?如果会,流程不能省。
一条铁律:compile 能过 ≠ 代码正确
这套工作流也不是没教训。我们最疼的一次,是某次「搜索优化」提交:编译照过,却静默删掉了 270 行并发安全代码——因为当时的评审回路只盯编译、没盯测试。
事故复盘写得很清楚:AI 在重构时,把一段它「觉得没用」的同步代码删了。这段代码在单线程测试下确实没用,但在高并发场景下是关键的线程安全守卫。编译能过、单测全绿、功能自测也没问题——AI 和编译器都看不见并发场景。
这条事故催生了铁律:compile 能过不等于代码正确,只有 verify 算数。verify 不只是跑测试,还包括:
-
多 Agent 评审(语义层) -
完整测试套件(行为层) -
关键路径的 E2E 验证(集成层)
只有这三层都绿,才算「真的写完了」。
反模式:这些做法不是 AI 研发工作流
讲完正确做法,有必要说说哪些做法不算 AI 研发工作流——我们在团队内外见过太多伪装成「AI 研发」的反模式,看起来在用 AI,实际效率和代码质量都没真正提升。
反模式一:把 AI 当外包,需求一句话丢过去。「帮我做个用户管理页面」就指望 AI 产出可交付的代码。这种做法的本质是放弃了「人定方向」的环节,把所有判断都交给 AI——结果是产出一坨能跑但不符合项目约定、复用不了已有组件、命名风格突兀的代码。AI 是工位上的执行者,不是外包团队。方向必须人来定。
反模式二:没有事实源,多 agent 自由发挥。开了 5 个 subagent 同时干活,但没有任务图约束,每个 agent 自己理解任务、自己改文件。两小时后,5 个 agent 改的文件互相覆盖,产出的代码合并起来一堆冲突。并行不是自由发挥,是「在同一份事实源约束下各自执行」。没有约束的并行只是制造混乱。
反模式三:把 TDD 理解成「先写测试再写实现」的形式主义。测试写得敷衍、只覆盖 happy path、边界和异常一个不测,然后号称「我们走了 TDD」。这种 TDD 比不写测试更危险——因为它给了「我已经测过了」的虚假安全感。TDD 的核心不是顺序,是「正确性被先定义」。测试覆盖不到的代码路径,等于没测。
反模式四:评审回路只走形式。让一个 AI agent 评审另一个 AI agent 的产出,但不给 checklist,让它「自由评审」。结果是评审 agent 找些无关痛痒的小问题(命名不够好、注释不够全)交差,真正的语义错误、跨层契约问题一个没发现。评审必须有明确的检查维度——架构合理性、跨层一致性、边界处理、性能影响——而不是泛泛的「看看有没有问题」。
反模式五:流程一旦上去了就死守。一个 3 行的配置改动,也要走完「原型 → 计划 → 并行 → TDD → 评审」全套流程。这是用流程压垮团队,不是用流程赋能团队。流程的价值在于对复杂改动提供保障,简单改动硬套流程,只会让团队觉得这套东西是负担,最终弃用。
识别这五个反模式,比记住正确流程更重要——反模式的共同点是「形式到了,实质没到」,看起来每一步都做了,但每一步的兜底目的都没达到。
给想上手这套工作流的团队几条建议
如果你也想在团队里推这套,有几条经验值得先说:
- 先从单步试点,别一上来铺全套
。选一个不紧急的新功能,先试「计划 + TDD」两步,跑顺了再加并行、加评审。一次铺全套,团队会被流程压垮,反而弃用。 - 任务图必须由人维护,不能交给 AI 自治
。任务图是事实源,谁动谁负责。让 AI 自己更新任务图,它会「优化」掉自己不想做的任务。 - 并行 subagent 的视角要事先设计好
。不要让 AI 自己决定开几个、各看什么视角。视角设计是人的工作,AI 只负责按视角产出。 - 评审回路要给明确的 checklist
。不要让评审 agent「自由评审」——它会找些无关痛痒的小问题交差。给 checklist,让它一条条对。 - 保留人工兜底的逃生通道
。流程跑挂了、AI 卡死了,要能立刻切回人工模式继续推进。流程是辅助,不是依赖。
小结
AI 研发不是换个补全工具,是重新搭一条流水线。三条原则贯穿始终:
- 能并行就尽量并行。
- 能固化就别靠记忆。
- 能让流程兜底就别指望人盯。
这三条不是「最佳实践」那种正确而无用的废话,而是真的会在你不做时出事的硬约束。并行不做,效率被串行拖死;固化不做,知识只存在某个人脑子里,人走就走知识;流程不兜底,线上事故总会等到你下班后才发现。
把这三条落到工作流的每一步,这套 AI 研发流水线就立住了。

相关文章