“读取我的课程资料,整理知识点,判断重点,制定复习计划,再检查有没有遗漏,最后生成一份完整文档。”
一、复杂任务真正的问题,不是“步骤多”
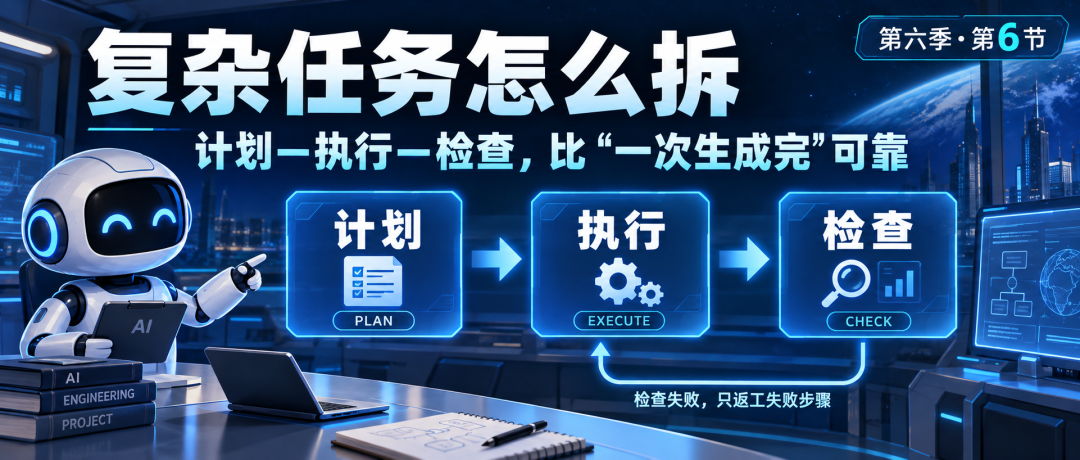
二、第一步:Plan——先计划,不要急着执行
三、第二步:Execute——一次只做一个可验证动作
四、第三步:Check——不要让“生成完成”等于“任务完成”
五、用一个完整案例看懂这套方法
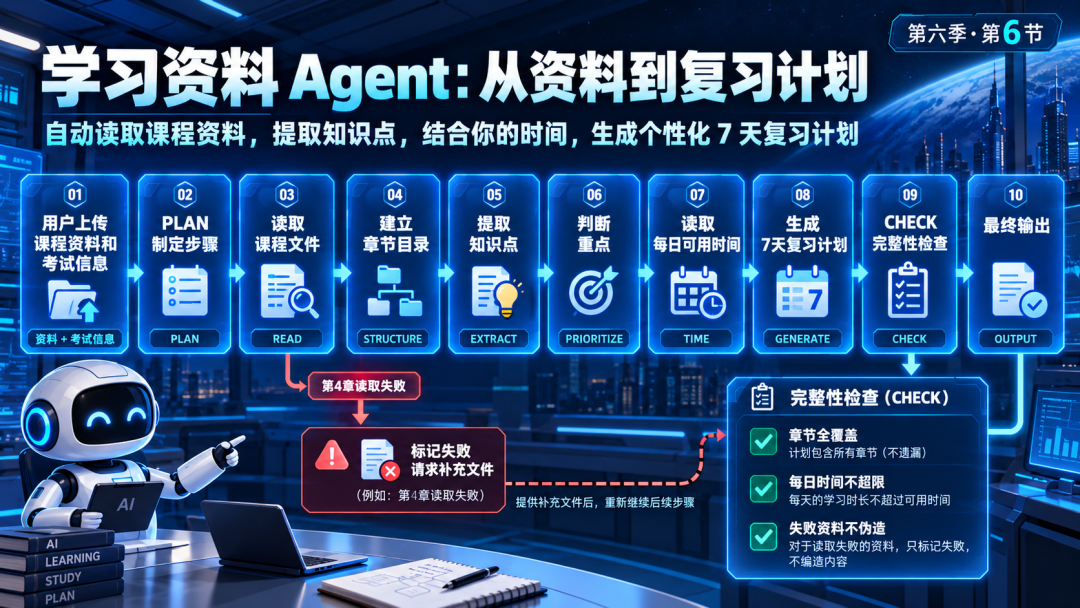
六、为什么这种方式比“一次生成完”更适合 Agent?
七、你可以直接保存的 Agent 任务拆解检查表
01 PLAN 计划
- □ 目标是否明确
- □ 步骤是否拆分
- □ 依赖是否明确
- □ 需要哪些工具
- □ 停止条件是什么
02 EXECUTE 执行
- □ 每一步输入是什么
- □ 输出是什么
- □ 结果能否验证
- □ 失败有没有记录
- □ 能否只重做失败步骤
03 CHECK 检查
- □ 完成标准是什么
- □ 有没有遗漏
- □ 结果是否来自真实输入
- □ 有没有把不确定写成完成
- □ 失败后返工还是人工处理

© 版权声明
文章版权归作者所有,未经允许请勿转载。
相关文章

暂无评论...


职场人导航(www.zcrdh.com)是为上班族与打工人打造的一站式工具导航网站,精选办公工具、AI工具、效率软件、摸鱼网站与生活实用资源,覆盖日常办公、工作提效、学习成长与下班生活等多种场景,帮助你快速找到真正好用的网站与软件,提升工作效率与生活体验。