如何选择适合自己的大模型? 一文搞懂 6 大模型的区别

大语言模型 · 多模态 · 全模态 · 生图 · 视频 · 语音

你有没有过这样的时刻:打开 AI 工具,面对 DeepSeek、GPT、Claude、Qwen、Gemini……一长串模型名单,却不知道该点哪一个?

今天聊聊市面上常见的大模型有哪些,又该如何选择。

这篇文章带你一次理清它们的区别、代表选手和适用场景,看完就知道怎么选。

本文导读

01 大语言模型

只跟文字打交道

02 多模态模型

能看能听,用文字答

03 全模态模型

实时双向交流

04 生图模型

会画画的数字画师

05 视频模型

会"拍片"的导演

06 语音模型

专注听与说

01大语言模型(LLM)

家族的"老大哥"

一句话定义:只跟文字打交道的模型——读文字、想问题、写文字。(AI的大脑)

大语言模型(Large Language Model)是整个大模型家族的起点,也是大家最熟悉的一类。它的输入和输出都是文字:你用文字提问,它用文字回答。写邮件、改文案、做翻译……背后基本都是语言模型在工作。它本身不支持图片、视频的读取和生成。

它是智能体(Agent)的"大脑",负责思考、规划、工具调用、逻辑推理和生成文本指令。

代表选手:

模型
机构
特点
DeepSeek V4 Pro
深度求索
纯文本,无图像输入(托管文档口径:仅支持文本)。1.6T MoE / 激活 49B,1M 上下文,1M 下 KV Cache 仅为 V3.2 的 10%。SWE-bench Verified 96.4%、Terminal-Bench 87.9,代码工程与 Agent 能力见长。
混元 Hy4 Preview
腾讯
纯文本,无视觉,多模态待正式版补齐(视觉另走 Hy Vision 线)。770B MoE / 激活 49B,1M 上下文,Apache 2.0 开源。GPQA Diamond 92.3,定位"为生产力而生"。
GLM-5.3
智谱
仅文本,无多模态(官方口径"仅处理文本")。744B MoE / 激活约 40B,1M 上下文。全部提升来自后训练,编程较 5.2 提升 50%;视觉另走 GLM-V 线。
Qwen3.7-Max
阿里
仅纯文本,官方明确"无多模态能力"。1.2T Dense / 激活 450B(四者中最高),1M 上下文,闭源仅 API。AA 榜国产第一,视觉交给 Qwen3.7-Plus。

02多模态模型(Multimodal)

长了眼睛和耳朵

一句话定义:能同时理解文字、图片、音频甚至视频的模型,但输出仍以文字为主。

"模态"指的是信息的形态:文字是一种模态,图片、声音、视频各是一种模态。多模态模型就是在语言模型的基础上,学会了"看"和"听"——你可以给它发照片、发截图、发语音,它理解之后用文字回答你。

可以把多模态模型理解为:一个会看图、会听音的语言模型。它的核心大脑依然是语言模型,输出仍然是文字。

代表选手

模型
机构
特点
Claude Opus 5 / Fable 5.1 / Sonnet 5
Anthropic
官方模型卡写明"Text and images in, text out"。DocVQA 93.0 断层第一,长文档理解是主场。无音频、无视频输入。
GPT-6 Astra / GPT-5.5
OpenAI
GPT-5.5 明确"文本 + 图像,无原生音频 / 视频"。结构化视觉推理强(ChartQA 92.1、AI2D 96.2、DocVQA 91.5)。
Grok 4.6
xAI
文本 + 图像进、文本出,靠 X 平台实时数据做差异化。
Qwen3-VL
阿里
SigLIP 视觉塔,1M token 上下文,视频理解超 2 小时,开源阵营里最能打的一支。
Kimi K3
月之暗面
2.8 万亿参数,首个原生四模态的万亿级开源模型(2026-07 开源)。

看到这里,你可能想问:为什么平时使用大语言模型(如 Hy4、DeepSeek V4 Pro)时,明明能输入图片,也能让它生成图片?

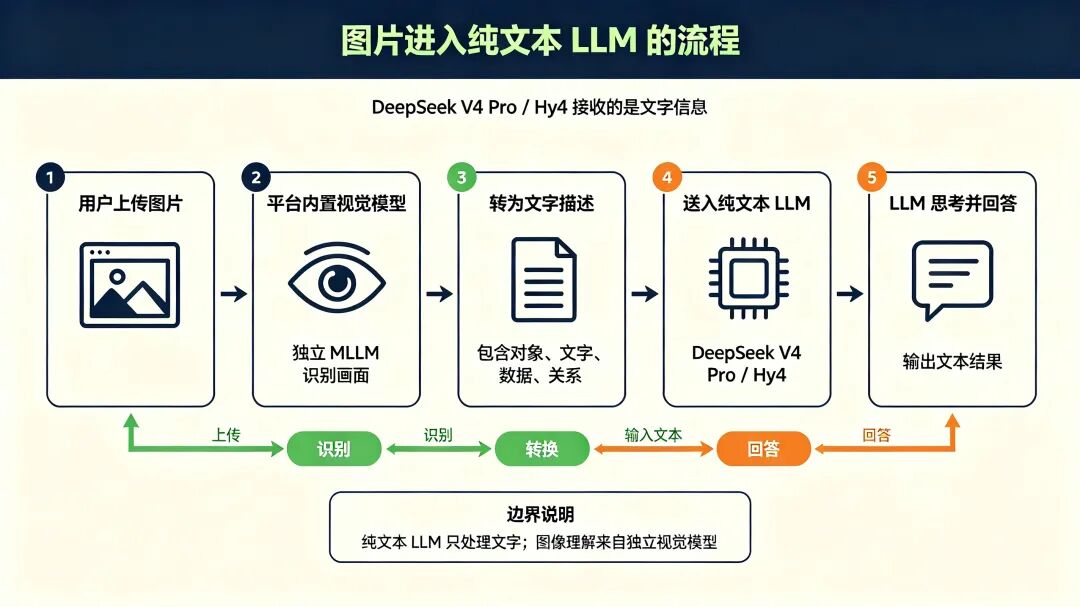
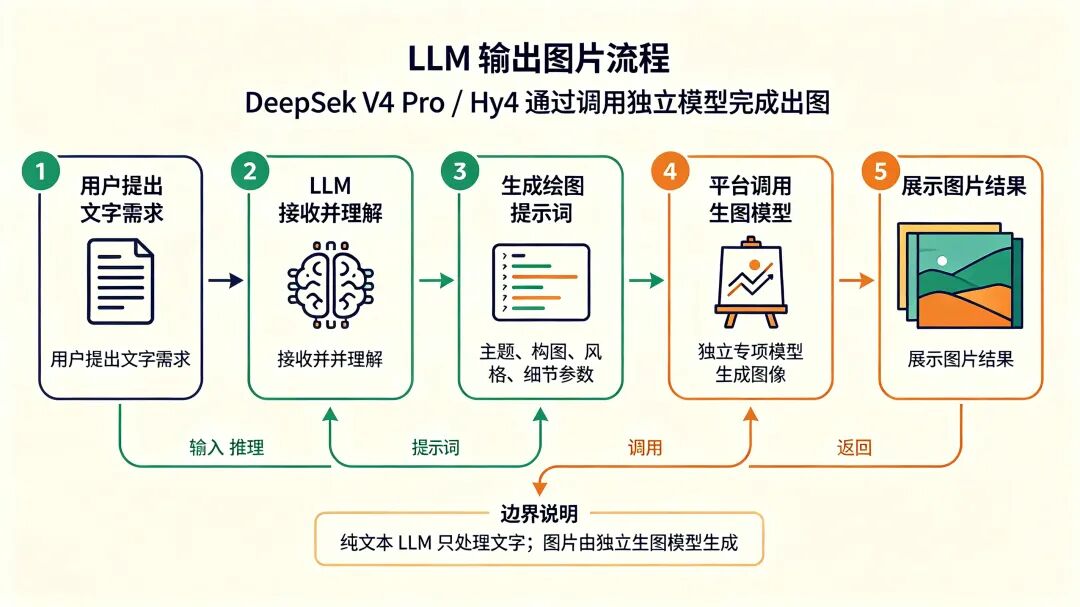
原因在于:纯文本 LLM 的底层基座本身看不懂图、也画不了图。图片和视频的处理,是靠 Agent 系统额外挂了独立的多模态模型做"前置预处理",再把结果转成文字交给 LLM。

举个例子,当你发一段文字让 Agent 帮你生成图片,整个过程是这样的:
如何选择适合自己的大模型? 一文搞懂 6 大模型的区别

图:文字需求如何变成一张图片

同理,当你发一张图片给它,处理流程则是:

如何选择适合自己的大模型? 一文搞懂 6 大模型的区别

图:一张图片如何被纯文本 LLM"看懂"

小结:大语言模型本身并不能直接识别图片,只有原生视觉模型才可以。你感受到的"能看图、能生图",其实是 Agent 在背后替你调度不同的模型。

03全模态模型(Omni-modal)

像人一样实时交流

一句话定义:听、说、读、写、看全部打通,并且能低延迟、实时地和你双向交流的模型。

全模态(Omni)和多模态只有一字之差,区别在哪?

多模态模型是"能看懂、能听懂,但用文字回答你";全模态模型则更进一步——它能用声音甚至画面回应你,而且是实时的。你可以像打电话一样和它视频通话:它看着你的表情、听着你的语气,立刻用自然的语音接话,中间几乎感觉不到延迟。

代表选手

模型
机构
特点
Qwen3.5-Omni(Plus / Flash)
阿里
Thinker–Talker 双解码器 + 混合注意力 MoE。256K 上下文(约 10 小时音频 / 400 秒 720p 视频),36 种语言语音输出。权重开放,可自部署。
Gemini Omni
Google
2026-05 I/O 公布的 any-to-any 世界模型方向,视频与音频同步生成。
GPT-4o
OpenAI
历史意义最大——首个端到端原生多模态,语音进语音出平均 320ms。注:chatgpt-4o-latest 已于 2026-02-16 弃用。
MiniMax M3 / 海螺 Omni
MiniMax
全模态理解 + 语音合成一体,性价比突出。
豆包 Seed 2.1
字节
App 端实时语音对话,国内装机量第一。

04生图模型(Image Generation)

会画画的"数字画师"

一句话定义:输入一段文字描述(或参考图),输出一张图片的模型。

生图模型是典型的"输出型"选手:你给它一句话——"一只穿着宇航服的柴犬,电影质感,暖色调",它就能画出一张以假乱真的图。除了"文生图",主流生图模型还支持"图生图":上传一张参考图,让它改风格、换背景、改文字,同时保持主体不变。

代表选手

模型
机构
特点
GPT Image 2(gpt-image-2)
OpenAI
LMArena 生成与编辑双榜第一。用"先推理再画"的方式,指令遵循最强、中文字最准。代价是慢——高质量约 109 秒 / 张。
Nano Banana Pro(Gemini 3 Pro Image)
Google
2025-11-20 发布。最多 14 张参考图、5 人一致性,2K / 4K,多语言文字清晰,支持局部编辑。
Midjourney V8.2 + Edit Model
Midjourney
2026-07-24 / 08-27 发布。审美天花板,2K 原生,会"自己帮你设计"。无公开 API,只有订阅。
Seedream 5.0 Pro / V5
字节
2026-07-09 发布。14 种语言文字渲染,套索 / 框选 / 草图区域编辑,可分离图层。中文商业设计最强。
Grok Imagine Image 2.0
xAI
2026-08-07 发布。小字清晰、魔法棒区域编辑、一键重排 9 种比例,出图极快(5.8–7.6 秒)。
Recraft V4.1 / V4.1 Vector
Recraft
2026-05-14 发布。唯一能直接输出原生 SVG 矢量文件的模型,Logo / 图标 / 品牌系统必看。

05视频模型(Video Generation)

会"拍片"的导演

一句话定义:输入文字描述或一张图片,输出一段连贯视频的模型。

视频生成是这两年进步最快的赛道。你只需要写一句"一只金毛犬在雪地里奔跑,镜头跟随,电影感",模型就能生成一段几秒到十几秒的成片;新一代模型还能同步生成对白、音效和背景音乐,实现"音画一体"。

代表选手

模型
机构
特点与关键数字
Kling 3.0 / 3.0 Omni(可灵)
快手
物理运动、流体、高速动作、写实人体最强;首尾帧控制 + 视频续写,做镜头衔接比别家友好;原生 4K。价格中高,高清 / 长片段加价明显,高峰期排队严重。3.0 Omni 支持多模态参考。
Seedance 2.5
字节
多镜头结构、镜头转场、运镜、时间戳级编辑;支持大参考集(主体 / 场景 / 声音),单次最长约 30 秒并可续写,长期领跑 Arena 视频榜。注意:2026-03 起因与电影公司的版权争议,消费者端推送受影响,商业项目先确认可用性。
Wan 3.0(通义万相)
阿里
单次最长 30 秒

(Wan 2.7 只有 10 秒),480P / 720P / 1080P,原生音频默认开启(对话 / 音乐 / 音效随视频一次生成,不计入价格)。杀手级功能:文档直接当输入——DOCX / XLSX / PPTX / PDF / TXT / Markdown / iWork / 网页链接,单文件 ≤100MB、≤50 页,一份 PPT 可直接变成品牌片。最多 20 个参考资产。价格 $0.05 / $0.10 / $0.20 每秒(480P / 720P / 1080P),两个型号 wan3.0-video 与高速版 wan3.0-video-prime。注意:网上流传的"4K 支持"与"Apache 2.0 开源权重"两个说法已被第三方分析否认,目前无法证实。
Hailuo 2.3(海螺)
MiniMax
人体动作与表演表达力强,6 / 10 秒,768p 或 1080p(1080p 目前绑定更短时长)。另有开源 MiniMax H3:最低 12G 显存可跑(推荐 24G),768P 原生音画同出、Ref2VA 多参考角色锁定,是私有化漫剧 / 分镜工作流首选。注意:协议为社区商用许可,不是 Apache / MIT,上线前需细读。
HappyHorse-1.0
阿里
音视频联合生成,7 语言唇形同步。2026-04 从匿名榜单一路冲到榜首的黑马。

06语音模型(Speech Model)

专注"听"与"说"

一句话定义:在声音和文字之间做转换的模型——听得清的是语音识别,说得像的是语音合成。

语音模型其实是一个"双子星"家族,外加一项热门能力:

方向
说明
代表
语音识别(ASR)
语音转文字。把你说的话实时转成文字,会议转写、语音输入法、字幕生成都靠它。
OpenAI Whisper、讯飞星火语音、阿里 Paraformer
语音合成(TTS)
文字转语音。把文字读出来,而且读得抑扬顿挫、富有感情。
ElevenLabs、字节豆包语音、阿里 CosyVoice、MiniMax 语音
声音克隆
用几秒钟的音频样本,复制出一个人的音色和语气,常用于配音和内容创作。
—

+加餐:Agent 使用中的两个疑问

怎么选模型?为什么同样的模型输出不一样?

六类模型介绍完了。但在实际使用 Agent 时,大家可能还有两个疑问,接下来一一解答。

Q1日常用 Agent,应该如何选择模型?

日常用 Agent(比如 WorkBuddy 这类工具)选模型,核心原则是:按任务难度和类型选,而不是永远用最强的。一个实用的决策思路:

1. 先看任务类型

●写代码 / 改 Bug / 重构:选编码能力强的旗舰模型(如 Claude 系列、GPT 系列的高配版),这类任务对长上下文和工具调用能力要求最高。

●写文案、做总结:中端模型完全够用,响应还更快。

●看图、读截图、分析文档:必须选带视觉能力的多模态模型。

●高频简单操作(格式化、改名、查语法、翻译):用轻量 / 快速版模型,延迟低、成本低。

2. 再看任务的"长度"

需要 Agent 连续执行十几步、跨多个文件的任务(比如实现一个完整功能),选长上下文 + 强 Agent 能力的模型——它更不容易"忘记"前面的指令,更少跑偏。

3. 平衡成本与速度

日常默认用中端模型,遇到复杂问题再手动切旗舰模型,是性价比最高的用法。很多 Agent 工具的"自动模式"就是在做这件事:简单任务派给小模型,难题派给大模型。

4. 一个简单的经验法则

这个任务做错了,代价大吗?
大,用最强的;不大,用最快的。

Q2不同 Agent 里用同一个大模型,为什么输出不完全一样?

先记住一个公式:Agent = 大模型 + Harness(脚手架)。

虽然大模型是同一个,但各个工具(Claude、WorkBuddy 等)的 Harness 并不完全一样。具体来看:

●系统提示词不同:每个 Agent 都会在你看不到的地方塞一段"出厂设定",包括角色、语气、规则、输出格式。

●上下文不同:模型没有记忆,它看到的只有你这次发给它的全部内容。不同 Agent 会附带不同的上下文——历史对话、项目文件、记忆库、联网搜到的资料。输入不同,输出自然不同。

●采样参数不同:Temperature 等参数控制着输出的随机性。

●框架细节不同:更多工程层面的差异,也会反映到最终结果上。

一句话总结:大模型决定的是能力的上限,而系统提示词、上下文、工具和参数,共同决定了它实际发挥成什么样。这也是为什么,评价一个 Agent 好不好,不能只看它接了哪个模型。


分享到: 文章二维码
© 版权声明

暂无评论

您必须登录才能参与评论!
暂无评论...