



用 Agent,不需要盯着它的每一步。要盯的是它现在处于什么状态,以及它实际做得对不对。
上一期那张图里我说,Chat 帮我想,Agent 帮我做。但“做”具体是怎么发生的,当时没展开。
我第一次真正理解 Agent,是从一个很直白的问题开始:
我只说了一句话,它为什么最后真的跑起了命令?
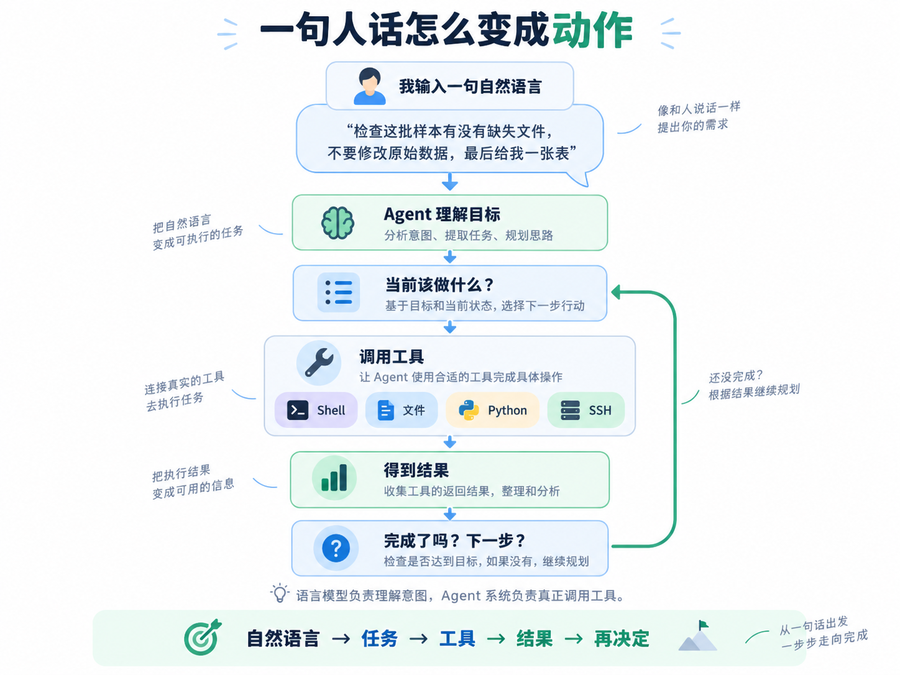
比如我输入这样一句自然语言:检查这批样本有没有缺失文件,不要修改原始数据,最后给我一张表。
这句话交给 Chat,通常换回来一段建议,或者一段代码。
交给 Agent,它会被理解成一个要完成的任务,然后拆成几件具体的事:
1. 这份工作里有哪些文件 2. 样本的命名规则是什么 3. 哪些文件应该存在、哪些实际存在 4. 缺的是哪几个 5. 怎么整理成一张表
接着它一步步做:需要什么工具就调用什么——读目录、执行 Shell、跑一段 Python,或者改一个已有脚本。拿到结果后,再决定继续还是收工。
所以我现在更愿意这样理解 Agent:
自然语言目标 → 拆成当前任务 → 调用工具 → 得到结果 → 再决定下一步。
计划不是一开始就写全的。 多数时候它是一边做、一边根据结果调整——这恰恰是它和“一次性给我一段脚本”最大的区别。
还有一层分工:语言模型负责理解意图、判断下一步;Agent 系统负责调用工具、把结果送回来。 上一期讲的 Shell 和 SSH,就是这一层。
至于记忆、技能、任务规划、上下文管理,都是让这个循环跑得更久更稳的附加能力,第一次用不必先学。
常见入口大致三种:命令行、编辑器插件、桌面客户端。我只说区别在哪。
命令行。 我本来就在终端里连服务器、跑脚本、看日志,Agent 也在同一个地方,SSH、Python、Git 天然接得上。
编辑器插件。 好处不是“更强”,而是代码、文件树和改动就在眼前,审它动了哪些文件比在终端里直观。
桌面客户端。 不想长期盯终端的人更舒服,它把 Agent 做成一个完整应用,一样能调用本地工具。
这三种经常是共享相同或相近的底层能力,部分配置也能共用,只是交互界面不同。对初学者,尤其是平时不怎么写代码、不太熟悉命令行的人,我更推荐从桌面端入手;其他情况,按自己的习惯在这三种里选一个就行。
安装这件事,我的习惯很简单:先看官网。 命令行按官方命令装,编辑器插件去插件市场搜,桌面端下载安装包——官网加包管理器,能覆盖大多数安装情况。 各系统差别大、更新也快,具体步骤搜一次就有。
只提醒一句:命令行那条安装命令一般从境外服务器下载,网络不通会失败。
开始一个任务时,我做的第一件事不是写 Prompt,而是先站对目录:
这是我用了一阵才养成的习惯。在项目目录里启动,和在它的上一级目录里启动,对 Agent 来说是完全不同的工作现场——它会优先围绕这个目录寻找文件、配置和项目上下文。
项目根目录有 README 和清楚结构,它一进来就大概知道是干什么的,比在 Prompt 里解释省事。
进去以后我会确认一下自己站在哪(Linux / macOS 里是 pwd,Windows 里是 dir,图形界面一般直接显示着)。
先说个和直觉不太一样的:我平时几乎不敲斜杠命令。
做事情的时候,我基本都直接用自然语言。比如:
它听得懂,不必记语法。我刚开始也以为要记很多命令,后来发现不是——用得最多只有两个:看状态的 /status,换模型的 /model,其他需要时再找。
真正需要我主动去看的,是这几个状态:
上下文不是无限的:任务做久了,讨论过的方案、读过的文件、命令输出都会占地方。我通常在一个阶段结束、准备切下一阶段时整理一次:命令行里是 /compact,把前面这段压成摘要,带着重点继续。/compact 我也是用了一阵子才意识到它很重要。图形界面里可能有对应按钮,也可能自动处理——要知道的是“上下文会满”,不是背 /compact。
同样一个操作,在不同入口里形态完全不同。要记的不是命令,而是“我现在需要知道什么”。具体哪里找,最后列了张表。
权限我一开始设得很保守,结果 AI 干活我一直在旁边点“允许”。
那段流程大概是这样:
Agent 最让人难受的,不是“不会做”,而是它明明知道下一步该干什么,却每步都回来问我一次。
很快就退化成:AI 在操作,我在负责按确认键。
后来,在项目目录、远程身份和数据边界都已经明确之后,我才逐渐减少一些重复确认。原因不是我信任它不会犯错,而是我大概知道它会怎么干:代码在哪、要动哪些文件、大概会跑哪些命令。它真动手的时候,做的正是我预想的那些事。方向既然清楚,再让我把每一步确认一遍,意义就不大。
当然,前提是上一期的边界已经搭好:工作目录明确,远程身份是一把单独的 key,数据边界也划过。
先限制它在哪活动,再减少每一步都问。 顺序反了的话,放宽权限就只剩风险。
这是我最花时间的一件事。
比如让它:检查这个项目有哪些样本、缺失哪些文件,不要动原始数据,最后给我一张检查表。
这时候我不会去读它每一句“思考”,只看另外几样:
这些问题有个共同点:问的是行为,不是说法。 Agent 很会写“我正在仔细检查……”,这不花成本;但命令有没有真跑、报错有没有换路、最后表有没有交出来,骗不了人。
但到这儿只解决了一半:它做得对不对。 还有更难的一半——这件事本身该不该这么做。
Agent 更擅长完成我给它的目标,而不是质疑目标值不值得做。目标越模糊,它越需要自己补假设;最危险的不是报错,而是这些假设一路没报错,最后顺利跑到错误方向。
子代理更适合在方向已经比较明确之后拆任务、并行执行。方向本身还没定时,多开几个执行者并不能自动解决判断问题。
我的办法是换一个视角:把 Agent 做出来的东西,拿给另一个 Agent 看。 具体就是网页端,把关键产物和结论贴过去,问一句“我这么做对吗”。
为什么是网页端?因为它独立,不在我的项目里。换一个独立会话,相当于故意拿掉前面的路径依赖——它不一定更正确,但更容易从另一个角度重新检查问题。
我一般在两种时候问:动手前目标还不清楚,以及它一路顺利你却越来越觉得不对劲。“说不上哪里不对”的感觉,往往是对的。
执行可以交出去,复核也可以交给另一个 Agent,但最后方向还是我决定。
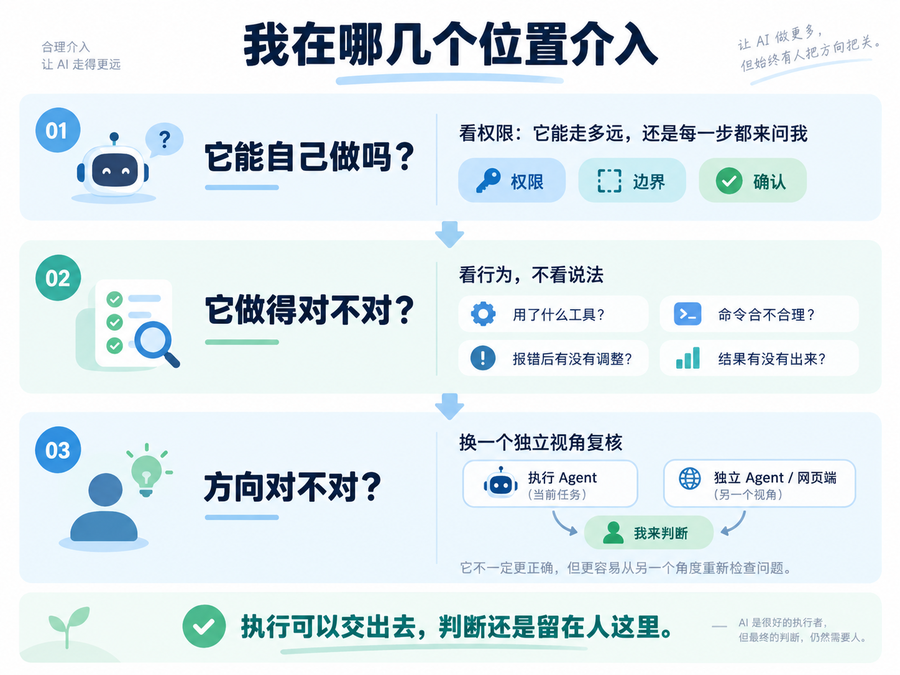
回来看,这一期只讲了一件事:我和 Agent 配合的方式变了——它执行,我判断。 前面那几件事里没有一件是关于命令的。
最后把提到的操作集中成一张表。不用背,需要的时候回来查就行。
下面命令以我目前使用的 Codex CLI 为例,其他 Agent 名字可能不同,但要解决的问题基本相同。
/status | ||
/model | ||
/usage | ||
/permissions | ||
/compact | ||
/ps | ||
/stop | ||
/diff |
右边那列说的就是这个:同一个操作,换个入口就换个形态。命令只是其中最需要“记”的一种——这正是我不建议你背它的原因。
真正值得记住的不是这些命令,而是:我什么时候需要看状态、什么时候该介入、什么时候应该让它停下来。
这个系列后面会从真实任务写起。具体先写哪一件我还没定——大概率是把我手里某条需要反复跑的流程,从头到尾整理一遍。等真做过一遍,再来写。

相关文章


