




告警响了,你的第一反应是什么?
大多数人会打开控制台、刷一下页面、看看报错——这说明你有经验,但也暴露了一件事:你没有系统思考过「监控」这件事。真正建过监控体系的人,第一反应是打开大盘,找到是哪个维度在告警,然后下钻。这篇文章就是帮你建立这个系统思维。
🎯 这篇文章解决什么问题
前端监控不是装一个 SDK 就完事了。你需要回答三个问题:监什么(四个维度的完整覆盖)、怎么监(SDK 架构怎么设计才不会变成屎山)、怎么落地(采样、去重、合规,三道绕不开的关卡)。
这篇文章基于一个真实落地的前端可观测平台来讲,不是纸上谈兵。读完你既能理解体系全貌,也能直接用在面试回答上。
🔍 监什么:四个维度的全景地图
前端监控的覆盖范围用一句话概括:性能 + 异常 + 行为 + 自定义。
很多团队只做了前两个,后两个缺失就意味着你知道「页面慢了」「报错了」,但不知道「用户在哪一步卡住了」「哪个接口拖累了转化率」。
性能维度:从 Vitals 到长任务
性能监控分三层,从宏观到微观:
第一层:Core Web Vitals(用户感知指标)
Google 定义的五个核心指标,直接对应用户体验的三个维度:
|
|
|
|
|
|---|---|---|---|
|
|
|
|
PerformanceObserver('largest-contentful-paint') |
|
|
|
|
PerformanceObserver('paint') |
|
|
|
|
PerformanceObserver('layout-shift') |
|
|
|
|
PerformanceObserver('event') |
|
|
|
|
navigation.responseStart - navigation.activationStart |
生产中推荐直接用 web-vitals 库采集,它处理了最终值时机(LCP/INP/CLS 在 pagehide 或 visibilitychange=hidden 时才封板)这个常见陷阱。
第二层:NavigationTiming 加载瀑布(9 阶段)
光看 Web Vitals 不够,还需要知道慢在哪个阶段。PerformanceNavigationTiming 提供完整链路:
按获取文档时记录的时间戳顺序排列的时间戳图
重定向 → DNS 查询 → TCP 连接 → SSL 握手 → 请求发出
→ 首字节返回(TTFB) → 内容下载 → DOM 解析 → 资源加载
用代码算出每段耗时:
const nav = performance.getEntriesByType('navigation')[0]
const stages = {
  redirect:    nav.redirectEnd - nav.redirectStart,
  dns:         nav.domainLookupEnd - nav.domainLookupStart,
  tcp:         nav.connectEnd - nav.connectStart,
  ssl:         nav.connectEnd - nav.secureConnectionStart,
  ttfb:        nav.responseStart - nav.requestStart,
  download:    nav.responseEnd - nav.responseStart,
  domParse:    nav.domInteractive - nav.domLoading,
  resourceLoad: nav.loadEventStart - nav.domContentLoadedEventEnd,
}
这 9 段数据就是大盘「加载瀑布图」的原始素材。
第三层:长任务分级(Long Task)
长任务是卡顿的直接原因。生产中按 duration 分三级:
|
|
|
|
|---|---|---|
long_task |
|
|
jank |
|
|
unresponsive |
|
|
new PerformanceObserver((list) => {
  list.getEntries().forEach(entry => {
    const tier = entry.duration >= 5000 ? 'unresponsive'
               : entry.duration >= 2000 ? 'jank' : 'long_task'
    monitor.report({ type: 'long_task', tier, duration: entry.duration })
  })
}).observe({ type: 'longtask', buffered: true })
💬 面试官:你们是怎么监控页面卡顿的?
✅ 标准答案:用
PerformanceObserver监听longtask类型,duration ≥ 50ms 的任务就是长任务,上报到监控系统。 🎁 加分答案:说出三级分类(50ms/2s/5s),以及 TBT(Total Blocking Time)= FCP 到 TTI 之间所有长任务中超过 50ms 部分的总和,这是 Lighthouse 的实验室口径。
补充:首屏时间(FSP)
Web Vitals 没有直接提供「首屏时间」,需要自己实现。主流方案是用 MutationObserver 监听 DOM 变化,配合 requestAnimationFrame 记录可视区域内最后一次有意义的渲染时间点:
let fsp = 0
const mo = new MutationObserver(() => {
  requestAnimationFrame(() => {
    if (hasVisibleContent()) fsp = performance.now()
  })
})
mo.observe(document.body, { childList: true, subtree: true })
load 后 3 秒封板,避免异步内容无限延迟上报时机:
window.addEventListener('load', () => {
  setTimeout(() => {
    mo.disconnect()
    monitor.report({ type: 'performance', metric: 'FSP', value: fsp })
  }, 3000)
})
FSP 精度约 ±20%,适合趋势对比,不适合精确断点分析。
生产中 Web Vitals 采集的三个坑
第一,LCP/INP/CLS 不能在 load 事件后立刻上报,它们的最终值要等到 pagehide 或 visibilitychange=hidden 才能确定——用户在页面上继续操作可能让 LCP 继续更新。
第二,SPA 路由切换后 PerformanceObserver 不会自动重置,需要手动在路由切换时清空缓存数据并重新初始化观察。
第三,web-vitals 库的 onCLS 是累积最大窗口而非累积总量,直接取最大布局偏移窗口的分数,与旧版统计方式不同,迁移时注意口径对齐。
🔧 真实场景:某医疗平台在上线新版药品搜索页后,LCP 从 1.8s 升到 4.2s(Poor 区间),但研发团队没有感知。根本原因是只有 Lighthouse 跑分,没有真实用户 LCP 监控。接入 Web Vitals 后,p75 LCP 数据才暴露出问题——是一张未压缩的药品主图拖慢了 LCP,压缩后恢复到 2.1s。
异常维度:四类错误 + 白屏兜底
异常监控要覆盖四类来源,漏掉任何一类都会有盲区:
|
|
|
|
|---|---|---|
|
|
window.onerror
|
undefined is not a function |
|
|
unhandledrejection
|
|
|
|
error 监听 |
|
|
|
requestIdleCallback
|
|
白屏检测是容易被忽略的一类。原理是:在 requestIdleCallback 回调中,采样页面根节点(#app / #root / main)的 clientHeight 和直接子节点数量——如果可视高度为 0 或子节点数为 0,就认为白屏并上报。
requestIdleCallback(() => {
  const root = document.querySelector('#app') || document.body
  const isEmpty = root.clientHeight === 0
               || root.children.length === 0
  if (isEmpty) monitor.report({ type: 'error', subType: 'white_screen' })
})
💬 面试官:JS 错误和资源加载错误都用
window.onerror能捕获吗?✅ 标准答案:不能。
window.onerror只能捕获 JS 运行时错误(冒泡阶段);资源加载错误(script/img/link)不冒泡,必须在捕获阶段监听addEventListener('error', handler, true)。 🎁 加分答案:unhandledrejection也要单独处理,因为 Promise 拒绝不触发onerror。三种监听方式缺一不可。
异常指纹与 Issue 聚合
原始错误事件数量庞大,直接看没有意义,需要按「指纹」聚合成 Issue。指纹的计算方式:
fingerprint = sha1(subType + normalizedMessage + topFrame)
-
subType:错误类型(js / promise / resource / white_screen) -
normalizedMessage:去掉动态部分(如数字、URL 参数)的标准化消息 -
topFrame:堆栈顶帧的文件名 + 行列号(经过 Sourcemap 还原后)
同一根因的错误会收敛到同一个 Issue,监控面板展示「出现次数 + 影响用户数 + 首次/末次时间」,而不是每条原始事件。
Sourcemap 还原是让异常监控真正可用的关键一步。生产代码经过压缩混淆,堆栈里是 bundle.js:1:23456,没有 Sourcemap 根本看不懂。解决方案是发布时上传 .map 文件到监控平台,服务端在处理事件时用 source-map 库自动还原到源码行列号。
🔧 真实场景:上线新版本后异常大盘突然出现一个高频 Issue,影响了约 3% 的用户。没有 Sourcemap 时只能看到 t.a is not a function at bundle.min.js:1:89234,毫无线索;接入 Sourcemap 还原后,立刻定位到 src/components/DrugCard/index.tsx:156——某个条件渲染逻辑在数据为 null 时没有做防守,一行修复解决问题。
面包屑:异常现场的还原利器
Sourcemap 解决了「报错在哪一行」,面包屑解决了「用户当时在干什么」。
两者缺一不可。光有行号,你知道代码在哪出错;有了面包屑,你才知道是用户点了哪个按钮、发了哪个请求、控制台打了什么 log,然后触发了这个错误。
面包屑是一条 FIFO 队列,默认最多保留 100 条,每条记录一个用户操作或系统事件:
interface Breadcrumb {
  timestamp: number     // Unix ms
  category: 'navigation' | 'click' | 'console' | 'xhr' | 'fetch' | 'ui' | 'custom'
  level: 'debug' | 'info' | 'warning' | 'error'
  message: string       // 简述,如 "GET /api/drugs/123 → 200"
  data?: Record<string, unknown>   // category 特定结构
}
SDK 会自动采集 6 类面包屑:
|
|
|
|
|---|---|---|
navigation |
|
from: /home → to: /drug/123 |
click |
|
button#buy-now |
console |
console.warn/error
|
|
xhr
fetch |
|
POST /api/cart 200 142ms |
ui |
|
input[name=keyword] changed |
custom |
addBreadcrumb()
|
|
当 error 或 api 事件上报时,会把当前队列里的所有面包屑一起打包发送——服务端把它们按时间序展示在 Issue 详情页,还原完整的操作路径。
💬 面试官:监控到一个 JS 报错,但复现不了,你怎么排查?
✅ 标准答案:先看 Sourcemap 还原后的堆栈定位出错位置,再看面包屑还原操作路径——出错前用户做了什么、发了哪些请求、控制台有没有 warning,通常能还原出复现步骤。 🎁 加分答案:面包屑是 FIFO 队列,100 条上限,超出会淘汰最旧的。如果出错前有大量 API 请求,可能把关键的用户操作面包屑挤掉,所以核心业务操作要用
addBreadcrumb手动追加,确保不被淘汰。
行为维度:三层埋点体系
行为监控是理解用户路径的唯一手段,分三层:
API 监控:通过 monkey-patch 劫持 XMLHttpRequest 和 window.fetch,对每个请求记录 method、url、status、duration,异常请求(≥400 / 网络错误 / 超时)额外记录请求参数片段,并注入 x-trace-id 实现前后端链路串联。
API 监控的核心价值在于两张大盘:
-
成功率大盘:按接口分组,实时展示成功率和 p50/p75/p95/p99 耗时分位数,一旦某个接口的 p95 突然升高,就能直接告警 -
慢请求 Top N:找出平均耗时最高的接口,给后端优化提供方向
monkey-patch fetch 的关键点是要保持对原始行为的透传,不能改变返回值类型,同时要处理 AbortController 中止的情况:
const originalFetch = window.fetch
window.fetch = function(...args) {
  const startTime = Date.now()
  const url = typeof args[0] === 'string' ? args[0] : args[0].url
  return originalFetch.apply(this, args).then(res => {
    monitor.reportApi({ url, status: res.status, duration: Date.now() - startTime })
    return res  // 必须原样返回,不能消费 body
  }).catch(err => {
    monitor.reportApi({ url, status: 0, error: err.message, duration: Date.now() - startTime })
    throw err   // 必须重新抛出,不能吞掉
  })
}
资源监控:PerformanceObserver('resource') 监听所有 PerformanceResourceTiming,按 initiatorType(script/link/img/font/media)分类,记录加载耗时、transferSize、是否命中缓存、CDN 主机。
埋点体系:三种粒度,按成本从低到高选用:
|
|
|
|
|---|---|---|
|
|
monitor.track('btn_click', { productId })
|
|
|
|
click/submit,读取 data-track-* 属性 |
|
|
|
IntersectionObserver
data-track-expose 元素 |
|
曝光埋点的关键细节:元素进入视口后需要停留 ≥ 500ms 才算有效曝光,避免快速滚动时大量误报。
const io = new IntersectionObserver((entries) => {
  entries.forEach(entry => {
    if (!entry.isIntersecting) return
    // 停留 500ms 才上报
    const timer = setTimeout(() => {
      monitor.track('expose', { element: entry.target.dataset.trackExpose })
    }, 500)
    entry.target._exposeTimer = timer
  })
}, { threshold: 0.5 })
💬 面试官:全埋点和代码埋点怎么选?
✅ 标准答案:全埋点成本低、覆盖广,适合快速铺量;代码埋点精度高、语义强,适合核心转化路径。生产中通常组合使用——全埋点做基础覆盖,核心漏斗节点用代码埋点补强。 🎁 加分答案:全埋点依赖 DOM 结构稳定,重构时容易丢数据;代码埋点和业务代码耦合,维护成本高。各有取舍,没有银弹。
🔧 真实场景:在一个医疗电商的药品详情页,把「加入购物车」「立即购买」「查看说明书」三个按钮同时用全埋点覆盖,再对「加入购物车 → 结算 → 支付完成」这条核心漏斗用代码埋点打点,两种方式互补。
访问分析:PV、UV 与 Session 轨迹
知道「页面报错了」,但不知道「这个用户是从哪个渠道进来的、在哪个页面停留了多久、这次访问是新用户还是回访」——这就是访问分析要填补的空白。
PV 与 UV 的采集原理
PV(Page View)每次 page_view 事件上报一次;UV(Unique Visitor)由服务端按 sessionId 去重得出。两者都不需要登录,匿名用户同样统计。
SPA 场景下路由切换不触发页面刷新,需要劫持四个事件才能完整捕获:
// 劫持 history API + 监听 popstate/hashchange
const originalPush = history.pushState
history.pushState = function(...args) {
  originalPush.apply(this, args)
  reportPageView()
}
history.replaceState = wrapHistoryMethod('replaceState')
window.addEventListener('popstate', reportPageView)
window.addEventListener('hashchange', reportPageView)
漏掉任何一个,SPA 的 PV 数据都会严重偏低。
Session 策略:30 分钟超时 + 跨标签页共享
Session 是访问分析的基础单元。策略如下:
-
首次访问生成 sessionId,写入localStorage(键名含projectId隔离多项目) -
30 分钟无任何事件上报则标记过期,下一条事件触发新 Session -
visibilitychange=hidden也计入超时倒计时——用户切到后台超 30 分钟视为会话结束 -
跨标签页共享:优先用 BroadcastChannel('ghc_session')同步,降级用storage事件监听
UTM 解析与来源识别
每条 page_view 事件自动解析访问来源,填充到 page 字段:
const utm = {
  source:   urlParams.get('utm_source'),
  medium:   urlParams.get('utm_medium'),
  campaign: urlParams.get('utm_campaign'),
}
// referrer 白名单识别搜索引擎
const SE_LIST = ['google','baidu','bing','duckduckgo','sogou','so.com','yahoo']
const searchEngine = SE_LIST.find(se => document.referrer.includes(se))
这样就能在大盘上区分「直接访问 / 搜索引擎 / 社交媒体 / 广告投放」四个来源渠道,评估不同渠道的用户质量。
设备环境与 GeoIP
每条事件都携带设备上下文:os / browser / deviceType(desktop|mobile|tablet) / network.effectiveType(4g|3g|2g) / screen / language / timezone。服务端用 MaxMind GeoIP2 按客户端 IP 补充 country / region / city,无需 SDK 上报。
页面停留时长
通过 visibilitychange 事件累计用户在页面上的真实活跃时间:
let enterTime = Date.now()
document.addEventListener('visibilitychange', () => {
  if (document.visibilityState === 'hidden') {
    const activeMs = Date.now() - enterTime
    monitor.report({ type: 'page_duration', activeMs })
  } else {
    enterTime = Date.now()  // 重新计时
  }
})
这比 beforeunload 的停留时长更准确——排除了用户切出去挂机的时间。
💬 面试官:SPA 的 PV 统计为什么不准?你怎么解决?
✅ 标准答案:SPA 路由切换不触发页面刷新,默认的
pageshow事件只在初始加载时触发一次。需要劫持history.pushState/replaceState并监听popstate/hashchange四个事件,每次路由变化都主动上报一条page_view。 🎁 加分答案:还要处理初始化时机——SDK 加载时已经在某个路由页面上,要立刻上报一次初始 PV。另外,同一个 URL 的快速反复切换(如 tab 来回切换)要做防抖,避免重复计 PV。
🔧 真实场景:某医疗资讯 SPA 上线新版后,运营反馈「某篇文章的阅读量比以前低很多」。排查发现旧版是 MPA(多页刷新),PV 自然上报;新版 SPA 化后,用户从文章列表进入详情页是 pushState 跳转,根本没有触发监控上报。补齐四个路由事件后,数据恢复正常。
自定义上报:track / time / log 三接口
业务层需要一套轻量 API,覆盖三种上报场景:
// 业务事件(如:用户搜索、切换 Tab)
monitor.track('drug_search', { keyword: '布洛芬', resultCount: 42 })

// 自定义耗时(如:首屏渲染耗时、AI 问答响应时间)
monitor.time('ai_response', 1240, { model: 'claude-sonnet' })

// 分级日志(debug 信息上报,不占用异常监控配额)
monitor.log('warn', '药品数据接口降级', { fallback: 'cache' })
三个接口对应后端三张独立的表(custom_events_raw / custom_metrics_raw / custom_logs_raw),互不干扰,查询时也能独立聚合。
💬 面试官:你们怎么做自定义业务指标的监控?
✅ 标准答案:提供
track/time/log三个接口,分别对应事件、耗时、日志三种上报语义,在 SDK 内队列化后批量上报。 🎁 加分答案:time接口最容易被忽视但最有价值——可以监控任意业务流程的耗时,比如 AI 推理、图片压缩、复杂计算,这些 Web Vitals 覆盖不到。
🏗️ 怎么监:插件化 SDK 分层架构
直接把所有采集逻辑堆在一个文件里,是大多数自研 SDK 最终变成屎山的原因。插件化架构能解决这个问题。
Hub 核心 + Plugin 接口设计
核心思路是:Hub 负责生命周期管理和事件总线,Plugin 只负责一件事。
Plugin 接口极度简洁:
interface Plugin {
  name: string
  setup(hub: Hub): void   // 注册监听、初始化采集
  teardown?(): void        // 清理副作用(移除监听、取消 Observer)
}
Hub 的职责:解析 DSN、按需加载插件、维护全局上报队列、暴露 report(event) 方法。
七个内置插件各司其职:
|
|
|
|---|---|
ErrorPlugin |
onerror
unhandledrejection + 捕获阶段资源错误 |
PerformancePlugin |
|
ApiPlugin |
|
ResourcePlugin |
PerformanceObserver('resource')
|
PageViewPlugin |
|
WhiteScreenPlugin |
requestIdleCallback
|
ExposurePlugin |
IntersectionObserver
|
以 ErrorPlugin 为例,看看一个插件的完整实现骨架。先注册两个监听器:
const ErrorPlugin: Plugin = {
  name: 'error',
  setup(hub) {
    const onError = (msg, src, line, col, error) => {
      hub.report({ type: 'error', subType: 'js',
        message: msg, stack: error?.stack })
    }
    const onUnhandled = (e) => {
      hub.report({ type: 'error', subType: 'promise',
        message: String(e.reason) })
    }
    window.addEventListener('error', onError)
    window.addEventListener('unhandledrejection', onUnhandled)
再保存 cleanup 引用,供 teardown 调用:
    this._cleanup = () => {
      window.removeEventListener('error', onError)
      window.removeEventListener('unhandledrejection', onUnhandled)
    }
  },

`teardown` 负责清理副作用:

```typescript
  teardown() { this._cleanup?.() }
}
插件的 teardown 是容易被忽略的细节。SPA 路由切换、微前端子应用卸载时,如果不调用 teardown 清理监听,会造成内存泄漏和重复上报。
初始化流程分三步:
DSN 解析 → publicKey / host / projectId
  ↓
插件按需加载(enablePerformance / enableApiTracking 等开关控制)
  ↓
全局 API 缓存队列 flush(SDK 早于业务代码时,track/log 调用先入队)
最后一步很关键:SDK 通常放在 <head> 最前面,但业务代码可能在 DOMContentLoaded 之后才执行 monitor.track()。如果没有缓存队列,这些调用会静默丢失。
体积约束是硬指标:核心 + 错误 + 性能 gzip 后 < 15KB,全量插件 < 30KB。超了就要拆包,用动态 import() 按需加载非核心插件(如曝光埋点)。
💬 面试官:你们的监控 SDK 是怎么设计的?为什么用插件化?
✅ 标准答案:采用 Hub + Plugin 架构。Hub 管生命周期和上报队列,每个 Plugin 只负责一类采集,通过
setup(hub)注入依赖。插件化的好处是按需加载、体积可控、各模块独立测试。 🎁 加分答案:体积是 SDK 设计的第一约束,不是功能。一个 gzip 后 100KB 的监控 SDK 本身就会制造性能问题——占用主线程、阻塞首屏。约束是核心包 < 15KB,全量 < 30KB,宿主长任务占比 ≤ 2%。
上报通道四级降级
上报不是简单地发一个 fetch,需要应对四种场景:页面关闭时、弱网时、跨域限制时。
四级降级顺序:
|
|
|
|
|
|---|---|---|---|
|
|
navigator.sendBeacon |
pagehide
beforeunload 页面离开 |
|
|
|
fetch(keepalive: true) |
|
|
|
|
XMLHttpRequest
|
|
|
|
|
new Image().src |
|
|
Beacon 的 64KB 限制容易踩坑。解决方案是按优先级拆批:超限时先提取 error 和 session_end 等「必须送达」事件用 Beacon 发送,其余回滚进 IndexedDB 队列等下次 flush。
async function flushOnPageHide(queue) {
  const payload = JSON.stringify(queue)
  if (payload.length <= 64 * 1024) {
    navigator.sendBeacon('/ingest', payload)
    return
  }
  const critical = queue.filter(e => e.type === 'error' || e.isCritical)
  navigator.sendBeacon('/ingest', JSON.stringify(critical))
  await writeToIndexedDB(queue.filter(e => !e.isCritical))
}
离线可靠性同样不能忽视:网络失败的批次写入 IndexedDB,SDK 启动时和 online 事件触发时自动重试,队列上限 500 条(超量丢弃最旧)。
💬 面试官:页面关闭时的监控数据怎么保证不丢?
✅ 标准答案:监听
pagehide事件(比beforeunload更可靠,移动端也能触发),优先用navigator.sendBeacon发送,浏览器保证在页面卸载后仍会完成发送。 🎁 加分答案:Beacon 有 64KB 限制,超限要按优先级拆批——错误类优先,性能/埋点类降级到 IndexedDB 下次重试。fetch(keepalive: true)也有类似效果,但两者行为略有差异,生产中建议优先 Beacon。
🔧 真实场景:在一个医疗问卷 SPA,用户填写到一半直接关闭了 Tab。beforeunload + fetch 方案下这次行为数据丢失率约 30%;换成 pagehide + sendBeacon 后丢失率接近 0。
⚖️ 怎么落地:采样、去重、隐私三道关
架构设计好了,真正上生产还有三道关要过。
采样策略:双层设计
全量上报在高流量场景下会压垮存储。采样分两层:
客户端采样(决定是否上报到服务器):
const SAMPLE_RATES = {
  error: 1.0,        // 错误全量
  performance: 0.3,  // 性能采 30%
  api: 0.3,          // API 采 30%
  track: 1.0,        // 埋点全量
}
function shouldReport(type) {
  return Math.random() < (SAMPLE_RATES[type] ?? 1.0)
}
服务端采样(决定是否写入数据库):对已到达服务端的事件再做一次过滤,应对突发流量峰值,保护数据库写入压力。
两层解耦的好处:客户端采样节省带宽,服务端采样保护存储,各自独立调整不互相影响。
💬 面试官:采样率怎么设置?为什么错误要 100% 而性能只要 30%?
✅ 标准答案:错误是低频、高价值事件,必须全量捕获,否则会漏报。性能数据高频产生,30% 采样在统计上已足够计算 p75/p95 分位数。 🎁 加分答案:采样率应该可配置,不能硬编码。上线新功能时可临时把性能采样率调到 100% 做精确对比,稳定后再降回来。
幂等去重:UUID v7 + 服务端 UNIQUE
网络重试会带来重复数据。解决方案两端协作:
-
SDK 侧:每条事件生成 eventId(UUID v7,时间有序),重试时复用同一个 id -
服务端: event_id列加UNIQUE约束,重复插入自动幂等(INSERT ... ON CONFLICT DO NOTHING)
选 UUID v7 而不是 v4:v7 前缀是时间戳,在数据库 B-tree 索引上是有序插入,写性能比随机 v4 好得多。
💬 面试官:监控数据重复上报怎么处理?
✅ 标准答案:SDK 给每条事件分配唯一
eventId,重试时复用;服务端在eventId字段加唯一约束,重复插入幂等忽略。 🎁 加分答案:用 UUID v7 代替 v4,是为了利用时间有序特性优化数据库写入性能——随机 UUID 在 B-tree 索引上会造成页分裂,高并发写入时影响显著。
隐私合规:beforeSend 过滤边界
监控系统天然会接触敏感数据,必须在 SDK 侧做好过滤。beforeSend 是最后一道关卡:
GHealClaw.init({
  beforeSend(event) {
    const sensitiveKeys = /password|token|authorization|cookie|secret/i
    if (event.type === 'api' && event.requestBody) {
      event.requestBody = redactFields(event.requestBody, sensitiveKeys)
    }
    return event  // 返回 null 则丢弃整条事件
  }
})
SDK 默认的隐私边界:
|
|
|
|---|---|
|
|
password/token/authorization/cookie/secret
[FILTERED] |
|
|
email
name 不入库,只保留 user.id |
|
|
requestBody
responseBody 硬截断至 4KB |
|
|
json/text/form 类型的请求体直接丢弃 |
💬 面试官:监控 SDK 会不会上报用户的密码或 Token?
✅ 标准答案:通过
beforeSend钩子在发送前过滤。SDK 默认对请求参数做正则匹配,命中password/token/authorization等关键字的字段值替换为[FILTERED]。 🎁 加分答案:还要注意 URL 中的敏感参数(如?token=xxx),以及响应体体积控制(截断至 4KB)。隐私合规是强制约束,不是可选项。
🚨 告警与闭环:从数据到行动
监控的终点不是大盘,是告警驱动的行动闭环。数据采集做得再完整,没有告警就等于「只记录不响应」。
告警规则设计
告警规则本质是一个 DSL:在什么时间窗口内,什么指标,超过什么阈值,触发什么动作。
生产中常见的预置规则:
|
|
|
|
|---|---|---|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
通知渠道支持多路分发:邮件 / 钉钉 / 企微 / Slack / Webhook / 短信,按优先级和团队习惯选择。
💬 面试官:告警太多怎么避免「告警疲劳」?
✅ 标准答案:设置合理的触发阈值(不要用绝对值,用相对基线的百分比变化),加入「持续 N 个周期才告警」的防抖,避免瞬时波动误报。 🎁 加分答案:按严重程度分 P0/P1/P2,P0 电话/短信即时通知,P1 群消息,P2 邮件日报汇总。同一 Issue 的告警合并,不重复轰炸。
AI 自愈:从「告知」到「自动修复」
这是监控体系的终极形态——不只是告诉你「出问题了」,而是自动帮你修复它。
流程如下:
告警触发 → 用户点击「一键自愈」
  ↓
AI Agent 加载 Issue 详情 + Sourcemap 还原堆栈 + 仓库上下文
  ↓
LangChain ReAct 多步推理:readFile → grepRepo → writePatch
  ↓
Docker 沙箱运行 verify 命令(跑测试)
  ↓
GitHub/GitLab API 自动创建 PR
  ↓
回写修复状态 + 通知开发者 review
AI Agent 的安全边界同样重要:修改范围受 heal.paths 白名单限制,单次 LOC 超过阈值直接失败,所有 Tool 调用记录到审计日志,沙箱镜像不联网。
这不是科幻——它已经在真实项目中落地,对于明确的 NPE(空指针)、未处理的边界条件等模式固定的 bug,AI 的修复成功率相当高。
💬 面试官:你们是怎么把 AI 和监控结合起来的?
✅ 标准答案:监控系统在检测到高频 Issue 后,触发 AI Agent 加载错误上下文(堆栈 + Sourcemap + 相关代码),用 ReAct 模式多步推理生成 patch,在沙箱跑验证后自动开 PR。 🎁 加分答案:AI 自愈不是万能的,它适合模式固定的 bug(NPE、边界条件缺失)。对于逻辑 bug 或架构问题,AI 只能做诊断辅助,最终决策还是人来做。安全边界(白名单、LOC 上限、沙箱隔离)是上生产的前提。
💡 一张图总结(面试速记)
|
|
|
|
|
|---|---|---|---|
|
|
|
PerformanceObserver
web-vitals |
|
|
|
|
window.onerror
addEventListener(true) |
|
|
|
|
addBreadcrumb
|
|
|
|
|
IntersectionObserver |
|
|
|
|
pushState
visibilitychange |
|
|
|
|
|
|
|
|
|
|
|
|
|
|
sendBeacon
fetch(keepalive) |
|
|
|
|
UNIQUE
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
💻 实战
智愈监控系统
前端可观测 + AI 自愈修复平台。SDK 采集 Web/H5/小程序的性能、异常、API、资源、页面、埋点数据 → 后端聚合 → 可视化面板 → 告警 → AI Agent 诊断并生成修复 PR。

主要功能:
-
性能监控:Core Web Vitals(LCP / FCP / CLS / INP / TTFB)、页面加载各阶段耗时、首屏时间、长任务卡顿、加载瀑布图。


-
异常监控:JS 运行时错误、Promise 未处理拒绝、静态资源加载失败、AJAX/Fetch 异常、白屏检测、Source Map 源码位置还原。

-
API 监控:自动拦截 XHR / fetch,记录调用量、成功率、耗时分位(p50/p90/p95/p99)、慢请求、异常请求上下文、TraceID 前后端串联。

-
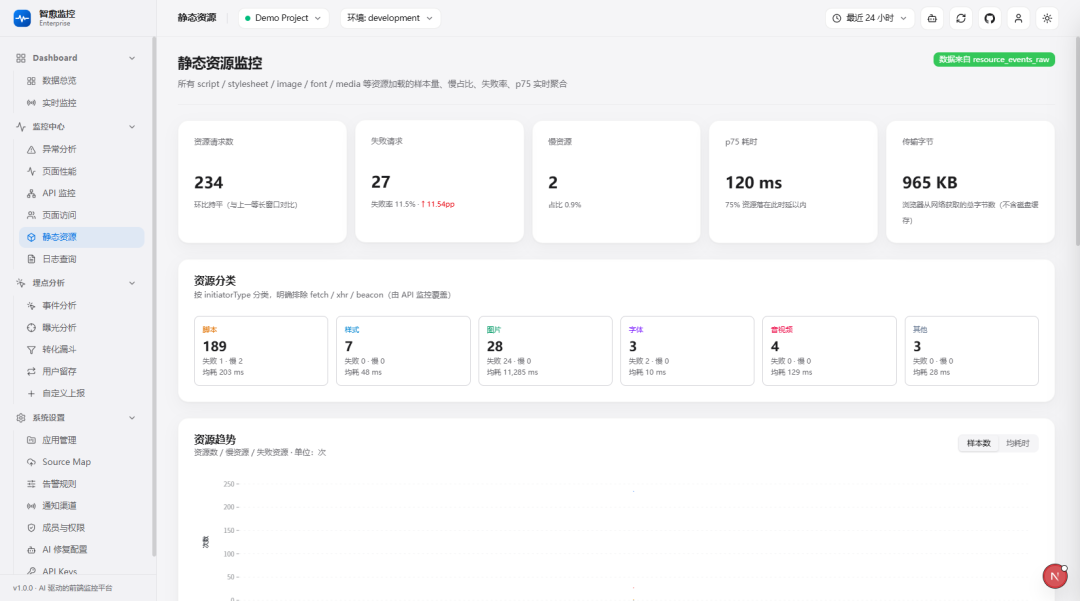
资源监控:按类型(script / style / image / font / media)拆分的加载耗时、大小、CDN 测速、失败率。
-
访问分析:PV/UV、会话轨迹、访问来源(referrer / UTM / 搜索引擎)、终端环境、IP 地域分布。

-
自定义上报:track/time/log事件、全局属性、分级日志。

-
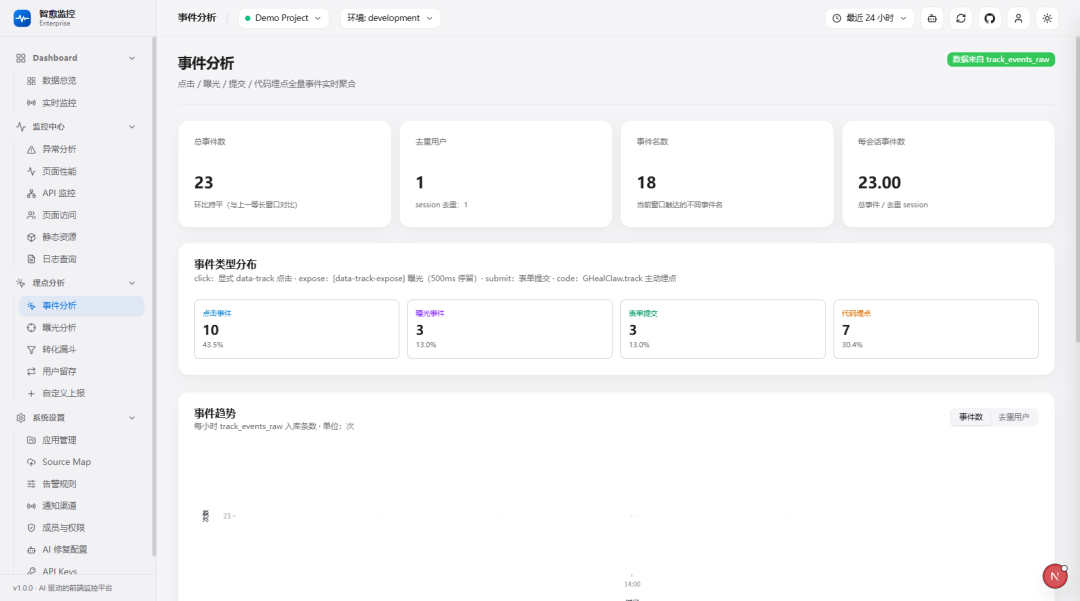
埋点:代码埋点、data-track 全埋点、曝光埋点(IntersectionObserver)、页面停留时长。
-
告警:错误率突增、Web Vital 劣化、API 成功率下降等预置规则;通过邮件 / 钉钉 / 企微 / Slack / Webhook / 短信分发。

-
AI 自愈:LangChain Agent 基于 Issue + Sourcemap + 仓库上下文 ReAct 推理,在 Docker 沙箱生成 patch + 跑 verify + 创建 PR。


✍️ 源码
https://github.com/lotosv2010/g-heal-claw
📝 留个问题
监控 SDK 本身也会影响页面性能,如何在「采集越全面越好」和「对宿主页面影响越小越好」之间做取舍?你们项目里是怎么平衡的?

相关文章


