



算力产业链的主线,不是“谁拥有最多 GPU”,而是“谁能把昂贵硬件转化成稳定、便宜、可交付的智能服务”。
过去两年,市场把注意力放在 GPU、万卡集群、智算中心上。可真正的产业链并不止这些。算力是一座 AI 工厂:芯片是发动机,HBM 是燃料管,网络是传送带,电力和制冷是地基,中游平台负责把机器开起来,下游应用负责把产能变成收入。
01 / 基础认知 / 算力不是一张卡,是一座 AI 工厂
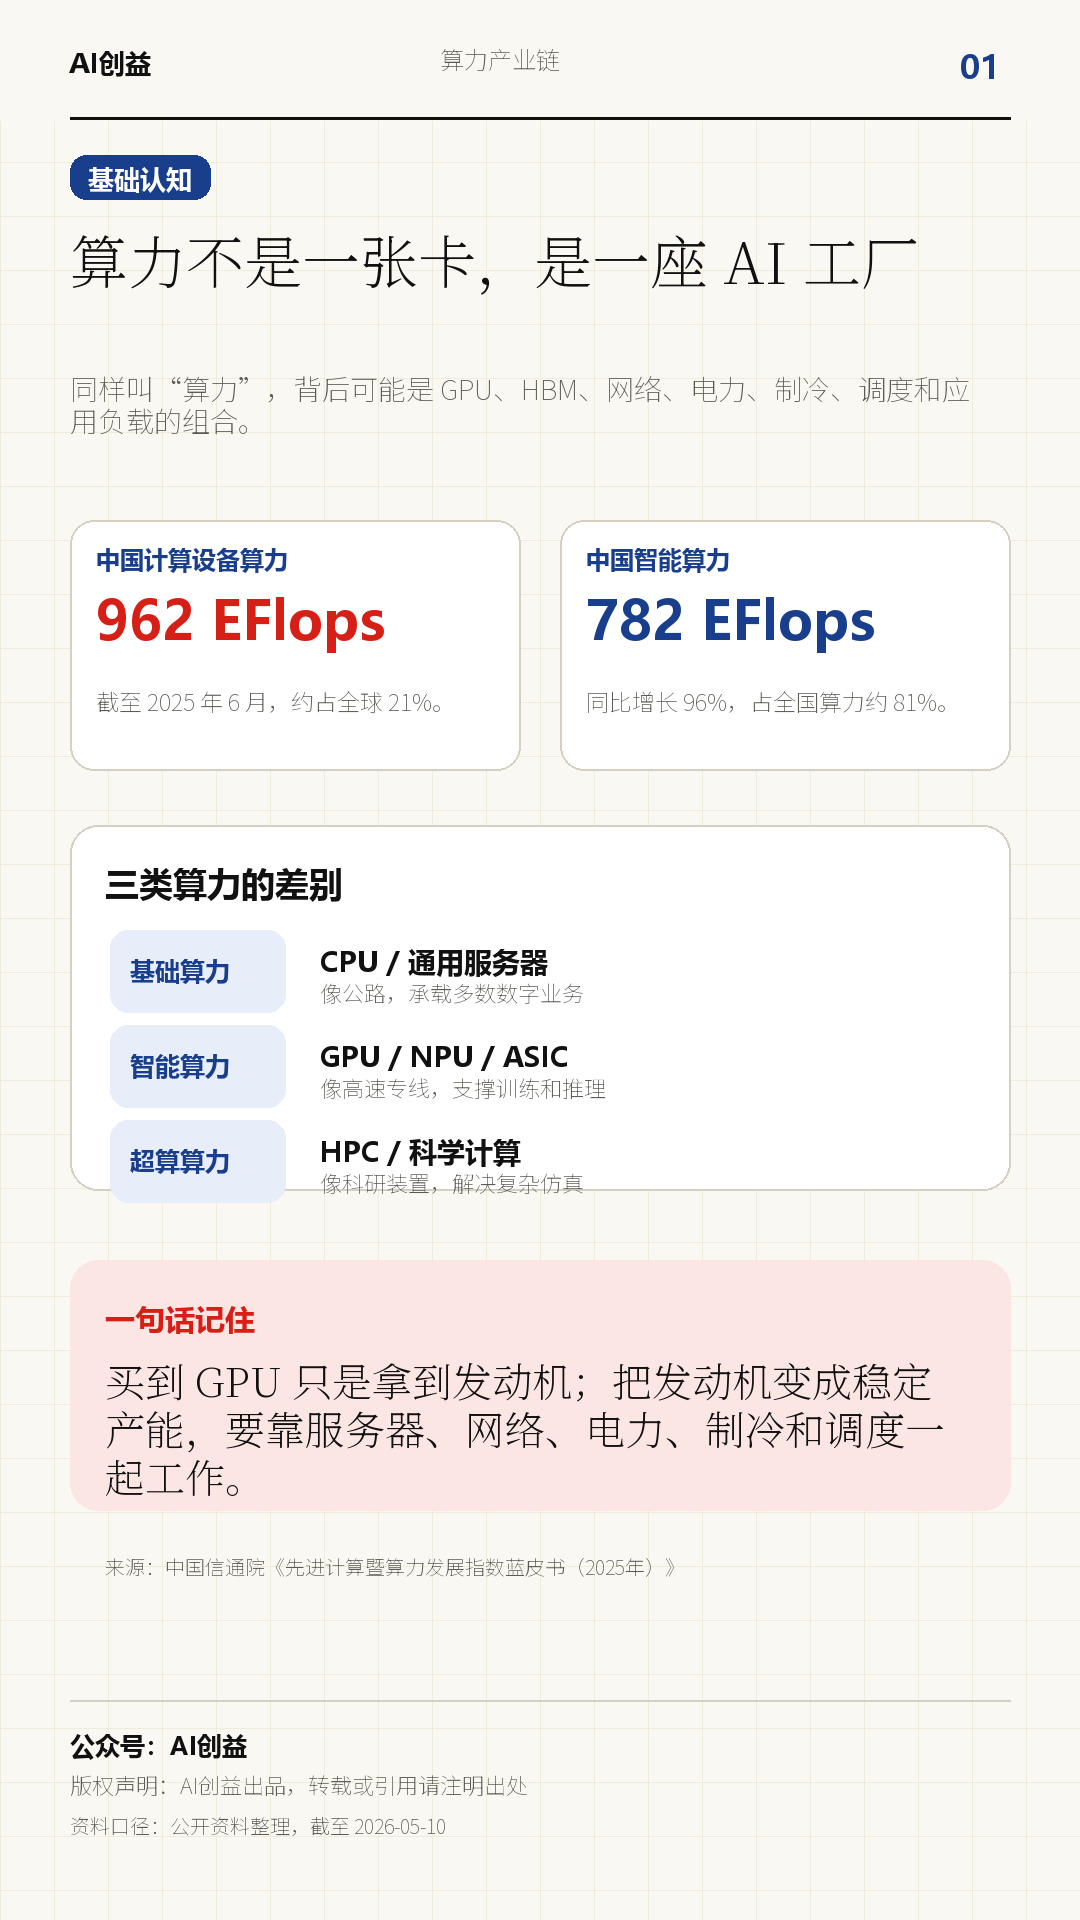
如果把算力只理解成 GPU,很容易看错这条产业链。
GPU 只回答“峰值能跑多快”。但商业世界真正关心的是:设备能不能连续跑,故障能不能隔离,训练任务能不能排队,推理成本能不能下降,电力和制冷能不能承接下一轮扩容。
中国信通院《先进计算暨算力发展指数蓝皮书(2025年)》显示,截至 2025 年 6 月,我国计算设备算力总规模达到 962 EFlops,其中智能算力达到 782 EFlops。这个数字背后,不只是芯片增长,而是整个基础设施栈在扩张。
一句话记住:买卡只是开始,把卡变成产能才叫算力。
02 / 产业链总览 / 算力产业链是一套六层栈
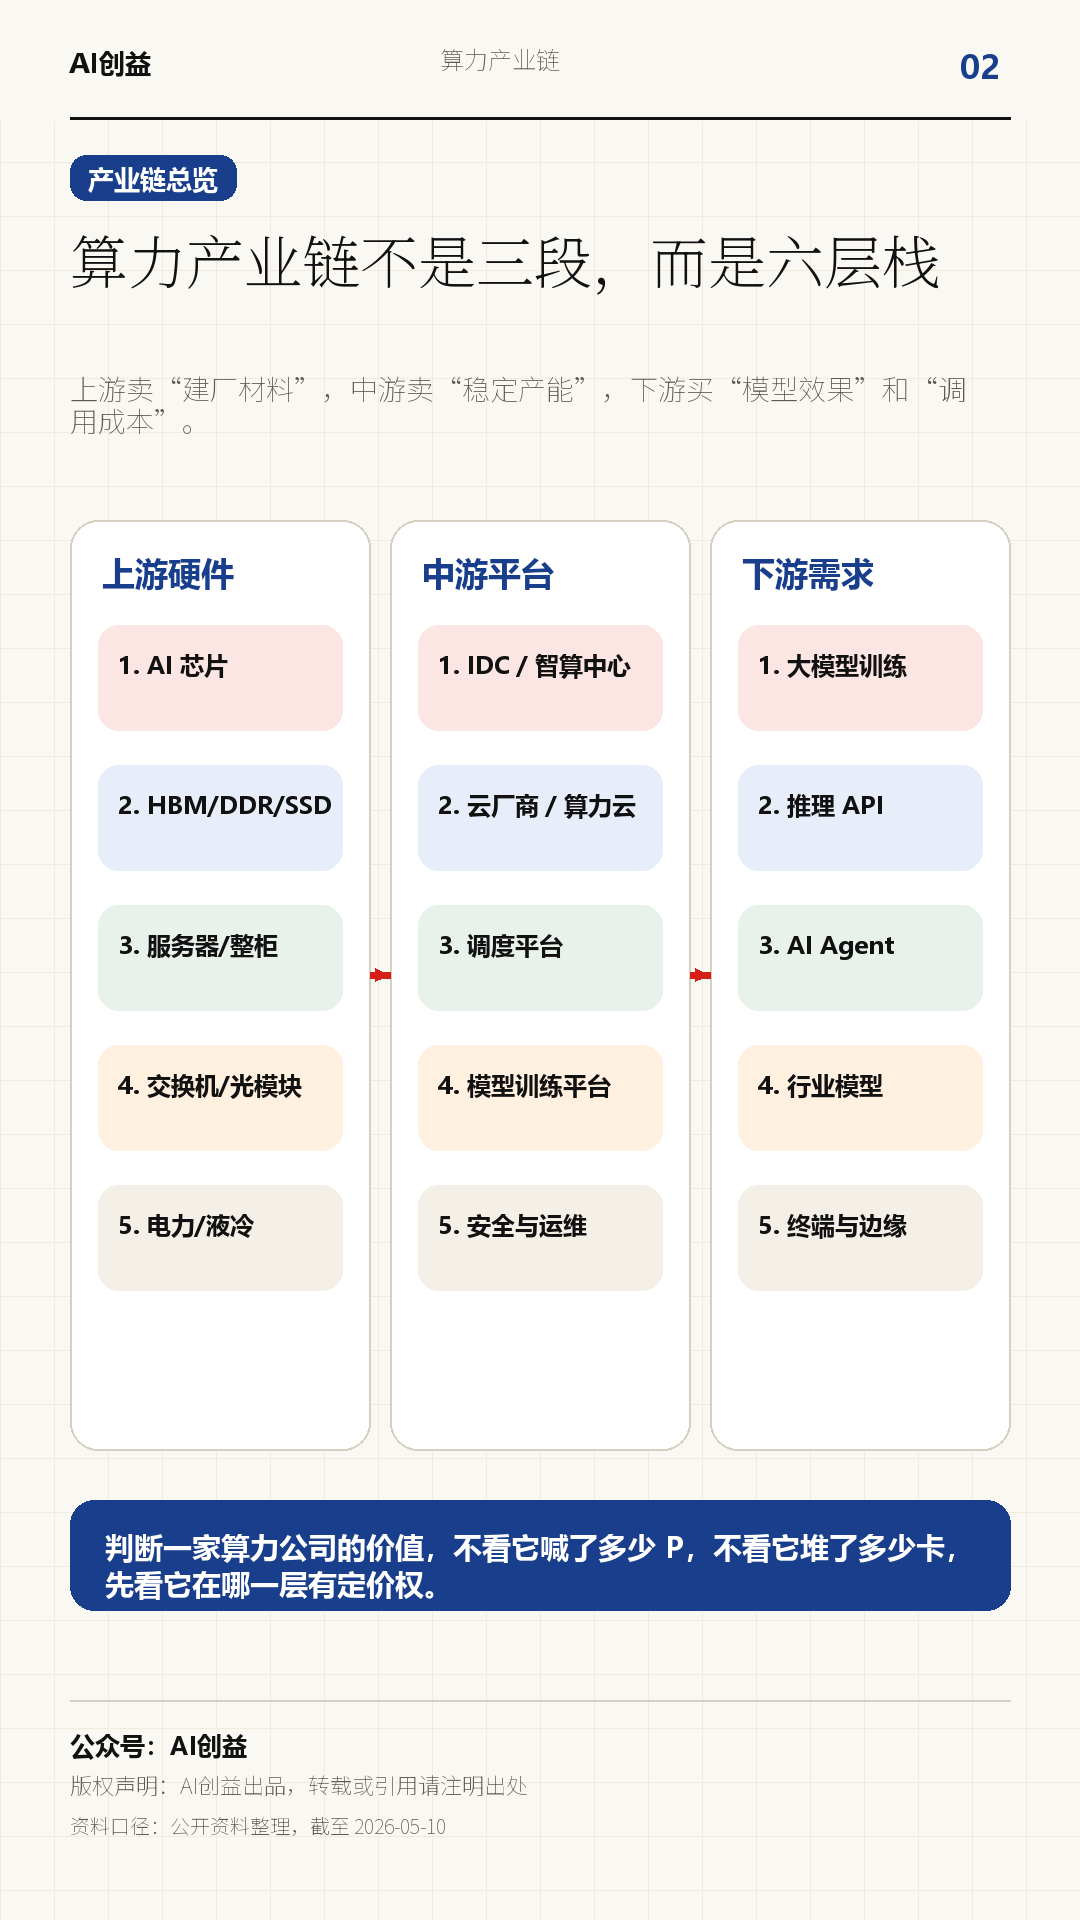
算力产业链可以拆成三段,但真正做业务时要看六层。
上游包括 AI 芯片、HBM、服务器、网络、电力设备、液冷和 IDC 工程。中游包括云厂商、智算中心、算力租赁、调度平台和模型训练平台。下游包括大模型训练、推理 API、AI Agent、行业模型和边缘终端。
上游卖“建厂材料”,中游卖“稳定产能”,下游买“模型效果”和“单位调用成本”。这三句话,比“上中下游”更接近产业链真实利润流向。
03 / 上游一 / 芯片和 HBM,是最贵的入口
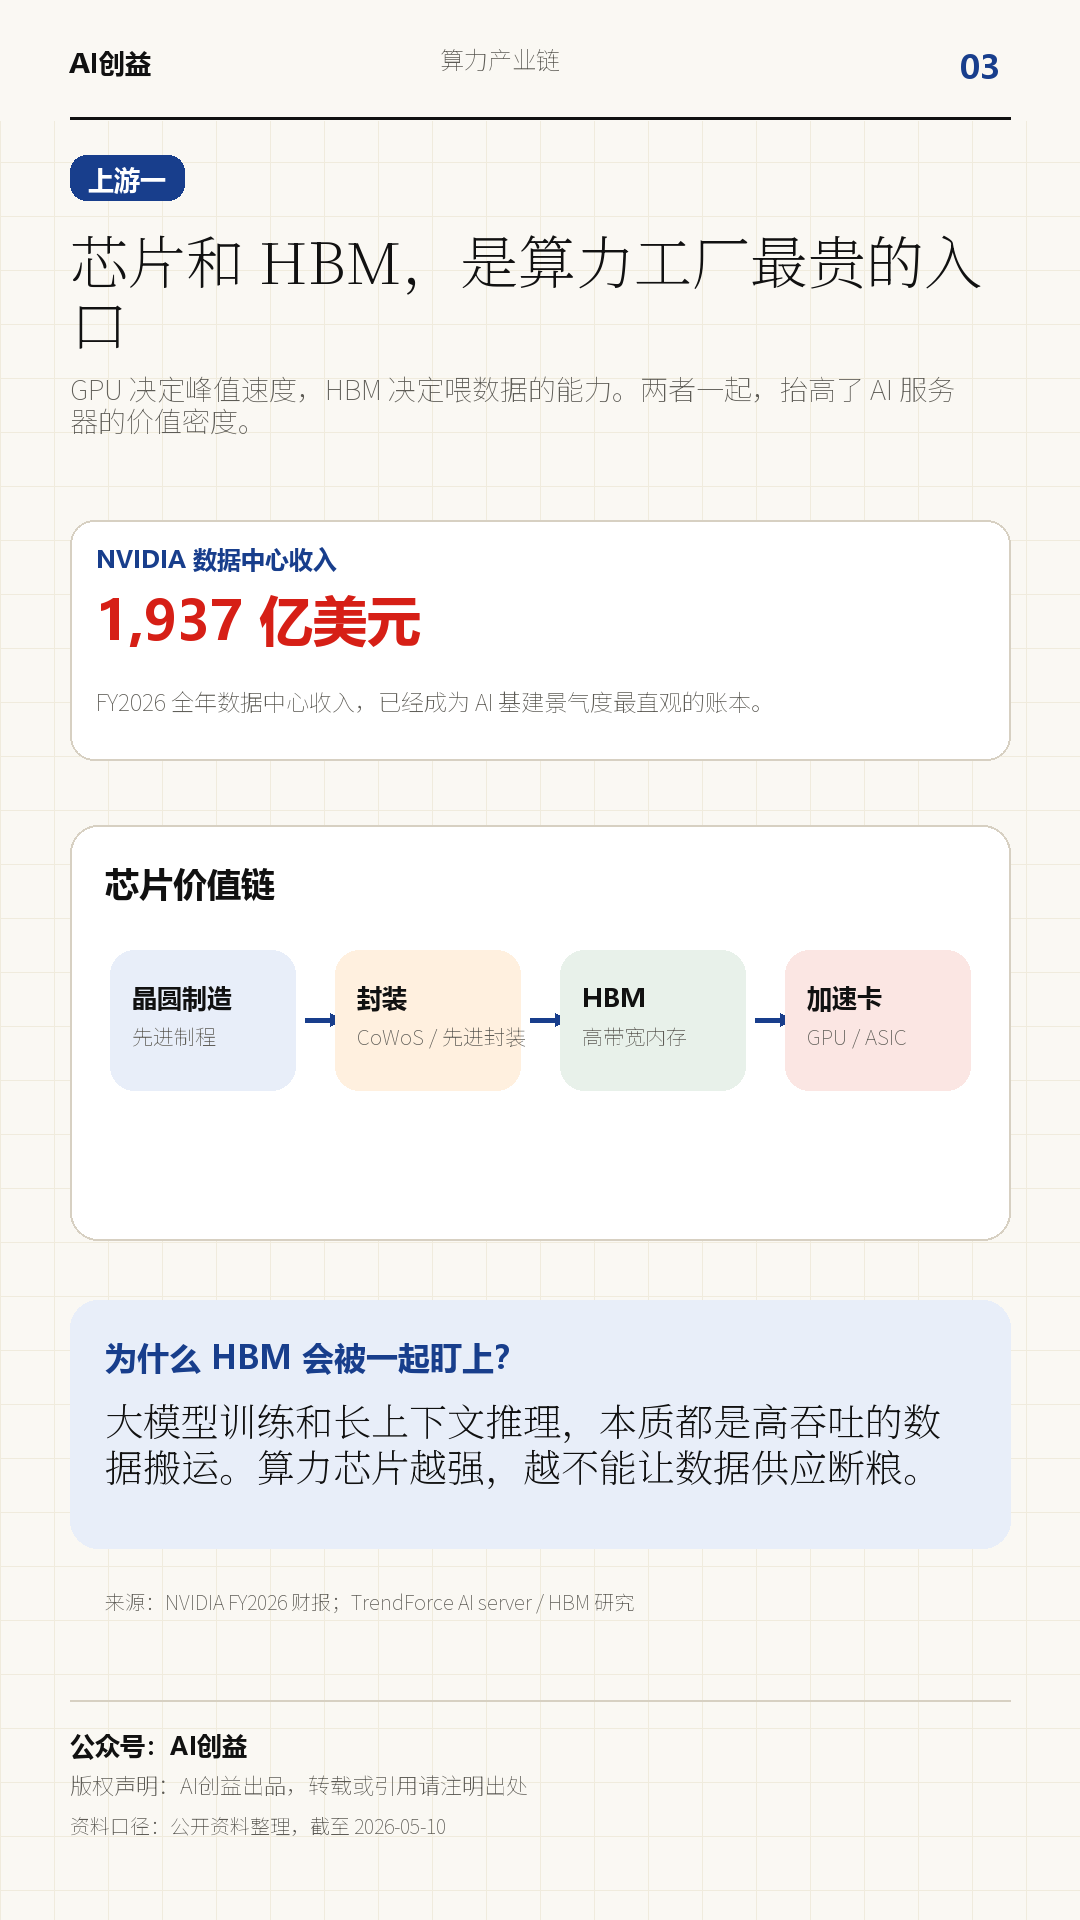
芯片仍然是算力产业链里最醒目的入口。
NVIDIA FY2026 全年数据中心收入达到 1,937 亿美元,已经把 AI 基建的景气度写进了财报。GPU 之外,HBM、先进封装和高速互连也被一起推上台前,因为大模型不是只需要“算得快”,还需要“数据供得上”。
训练大模型时,参数、激活值、梯度和优化器状态不断搬运;推理长上下文时,KV cache 又会持续吞内存带宽。算力芯片越强,越不能让数据供应断粮。
所以芯片环节的定价权,不只在 GPU 本体,也在围绕 GPU 的先进制程、先进封装、HBM 和高速互连。
04 / 上游二 / 服务器正在从“单机”变成“整柜产品”
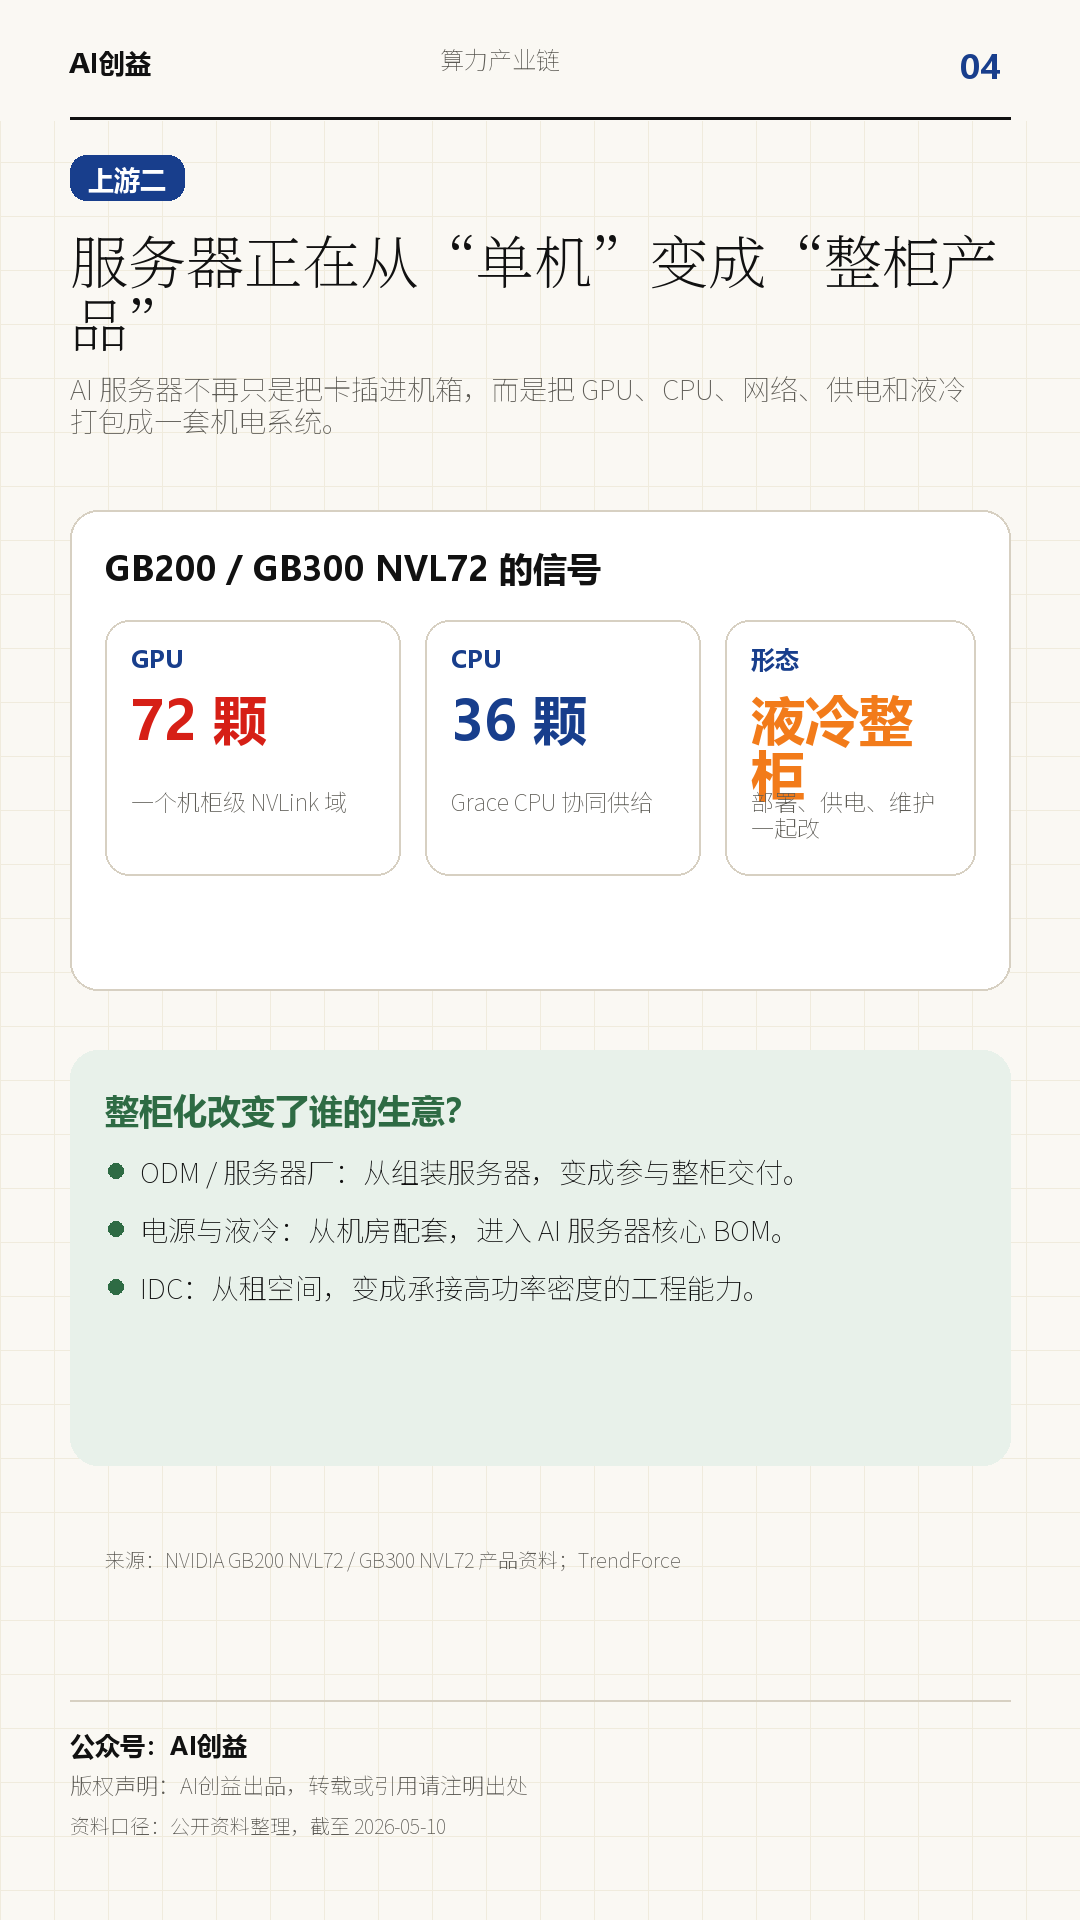
AI 服务器的形态正在从单机、节点,走向整柜和集群。
NVIDIA GB200 / GB300 NVL72 这种整柜级方案,把数十颗 GPU、CPU、NVLink、网络和液冷集成到一套系统里。对产业链来说,这意味着服务器厂不只是做机箱和主板,电源、液冷、线缆、机柜、现场交付和运维能力都变得更关键。
这也是为什么传统 IDC 的能力边界被重新定义。AI 机房不是多放几排服务器,而是要承接更高功率密度、更复杂的液冷、更紧张的交付周期。
一句话记住:服务器从“设备采购”变成了“机电工程”。
05 / 上游三 / 网络决定 GPU 能不能一起干活
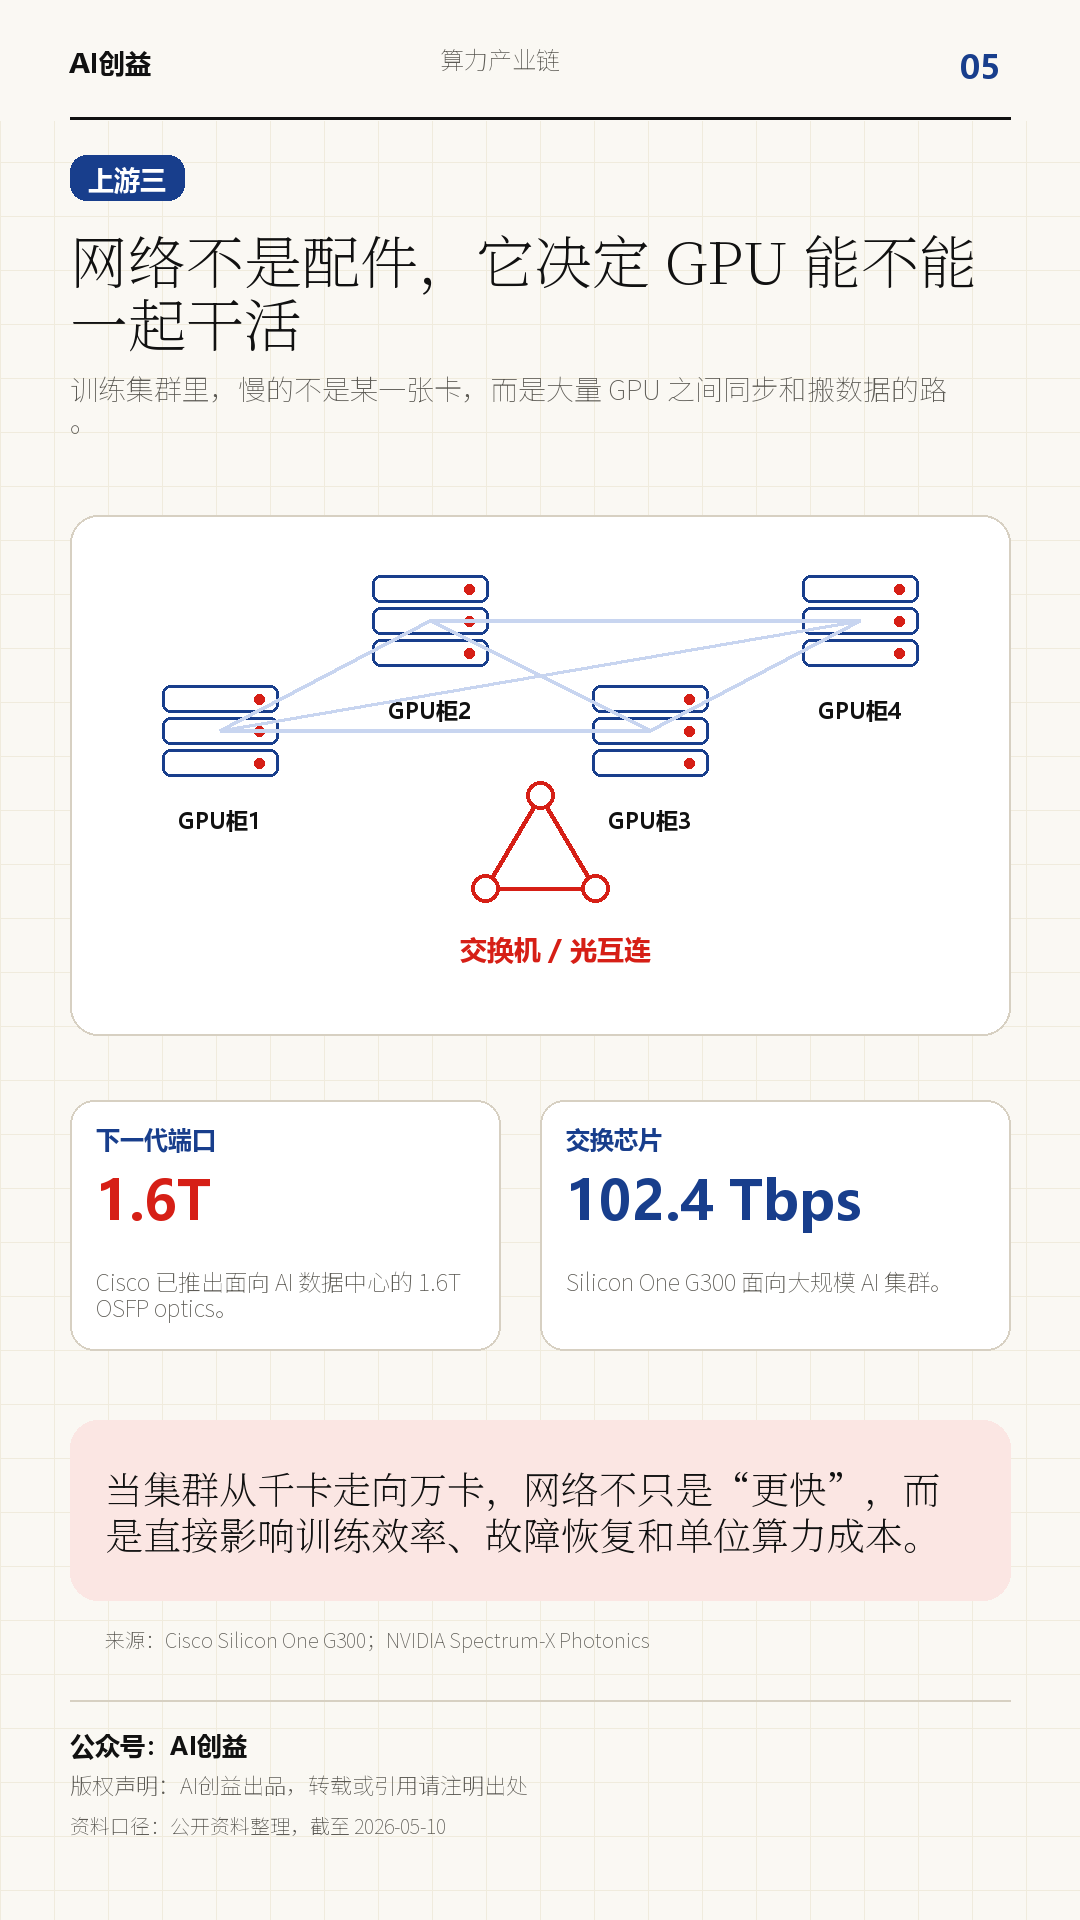
AI 集群最容易被低估的环节,是网络。
训练集群不是让每张 GPU 各算各的,而是让大量 GPU 在同一个任务里频繁同步。只要网络拖后腿,昂贵芯片就会出现等待。等待就是浪费,浪费最终会进到每一次训练和推理的成本里。
Cisco 2026 年发布的 Silicon One G300 面向 102.4 Tbps 交换能力和 1.6T OSFP optics;NVIDIA 也在 Spectrum-X Photonics 中强调用光互连提升 AI factory 的规模和能效。方向已经很清楚:算力规模越大,网络越不像配件。
一句话记住:GPU 决定峰值,网络决定这些峰值能不能相加。
06 / 上游四 / 电力和制冷,正在变成硬约束
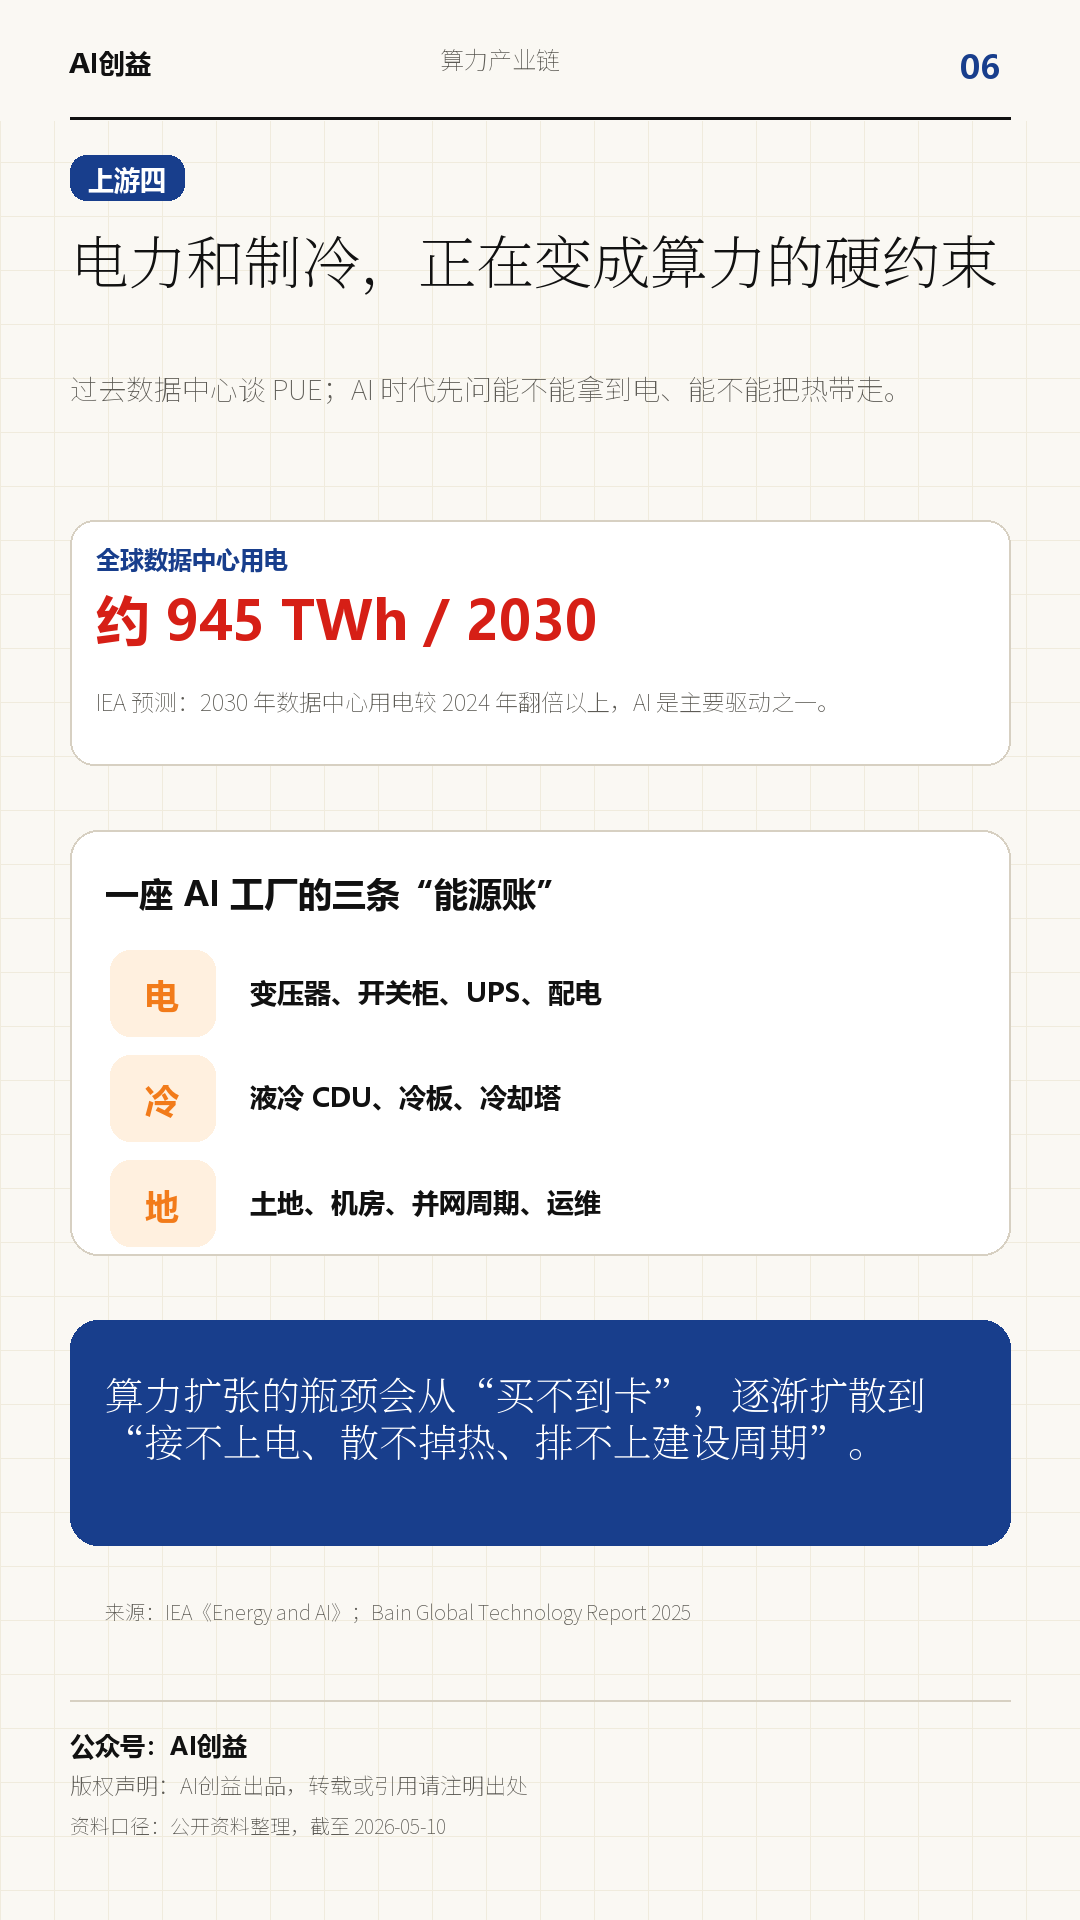
AI 基建最现实的问题,不是 PPT 里的“万卡”,而是现场能不能接电、散热、并网、运维。
IEA 在《Energy and AI》中预计,全球数据中心用电到 2030 年将增长到约 945 TWh,较 2024 年翻倍以上。Bain 的测算也把约束讲得很直白:未来要满足 AI 算力需求,数据中心建设需要巨额资本开支,同时受制于电力、工程施工、GPU 等关键部件和电气设备供应。
这解释了为什么电力设备、液冷、UPS、变压器、开关柜、CDU、冷板和数据中心工程公司,会突然出现在“AI 产业链”的讨论里。
算力不是空中楼阁。越往后,越像重资产工业。
07 / 中游 / 中游卖的不是 GPU,而是稳定可用的产能
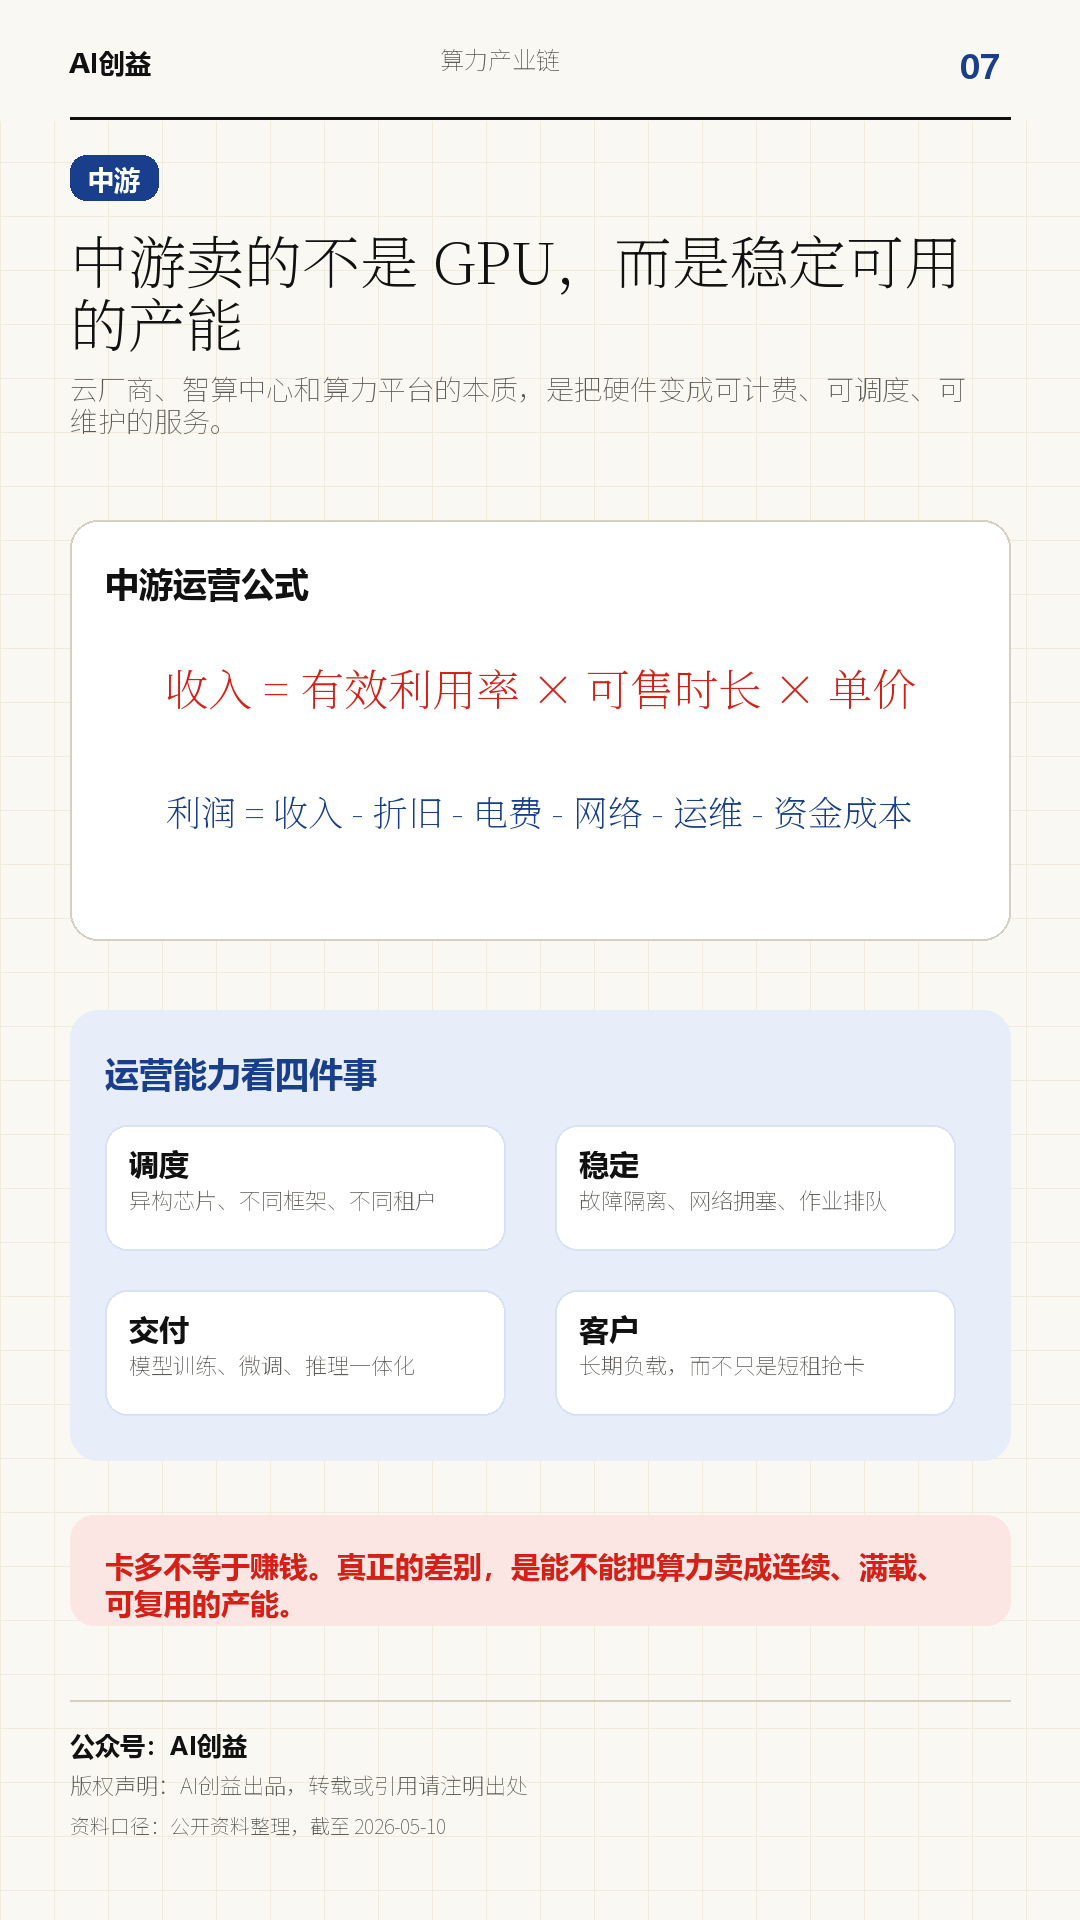
中游的核心生意,是把硬件变成可计费、可调度、可维护的服务。
同样一批卡,利用率 30% 和 70% 是两门生意。前者像囤货,后者像工厂。对云厂商、智算中心和算力租赁平台来说,真正的竞争不是“我有多少卡”,而是“这些卡有没有客户、有没有长期负载、有没有稳定的调度和运维体系”。
算力运营看四件事:异构调度、故障隔离、网络拥塞处理、客户负载沉淀。少一项,纸面产能都可能变成闲置资产。
一句话记住:卡多不等于赚钱,满载才接近赚钱。
08 / 下游需求 / 训练点火,推理烧钱;Agent 会把需求拉成长尾
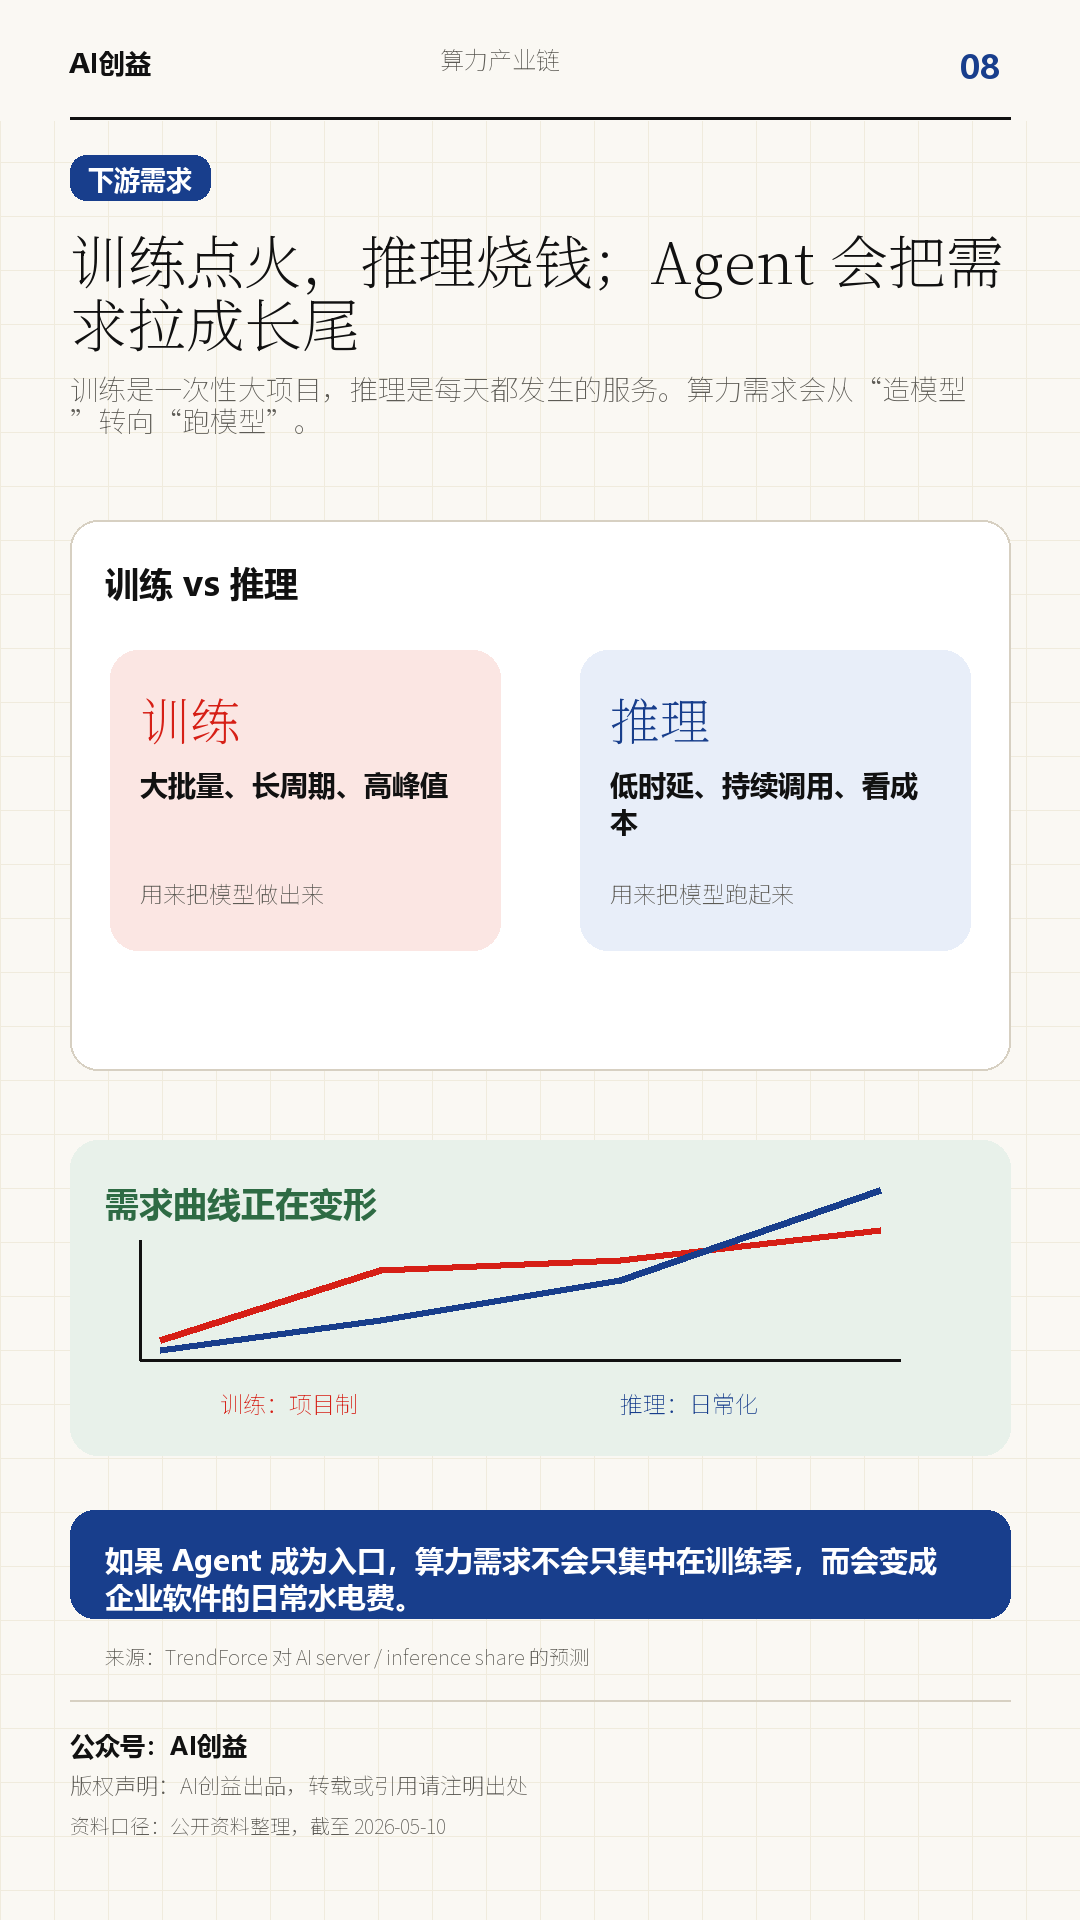
下游需求大致分两类:训练和推理。
训练像点火。它一次性吞掉大量算力,用来把模型做出来。推理像烧水。用户每问一次、企业每调用一次、Agent 每执行一步,都在消耗算力。
TrendForce 在 2025 年对 AI server 的研究中提到,低成本模型与应用扩张会推动 AI 推理服务器占比上升。这个判断很重要:如果 AI Agent 成为软件入口,算力需求就不会只集中在训练季,而会变成企业软件的日常水电费。
训练决定模型上限,推理决定商业天花板。
09 / 竞争格局 / 算力热潮里,最确定的是“卖铲子”的环节
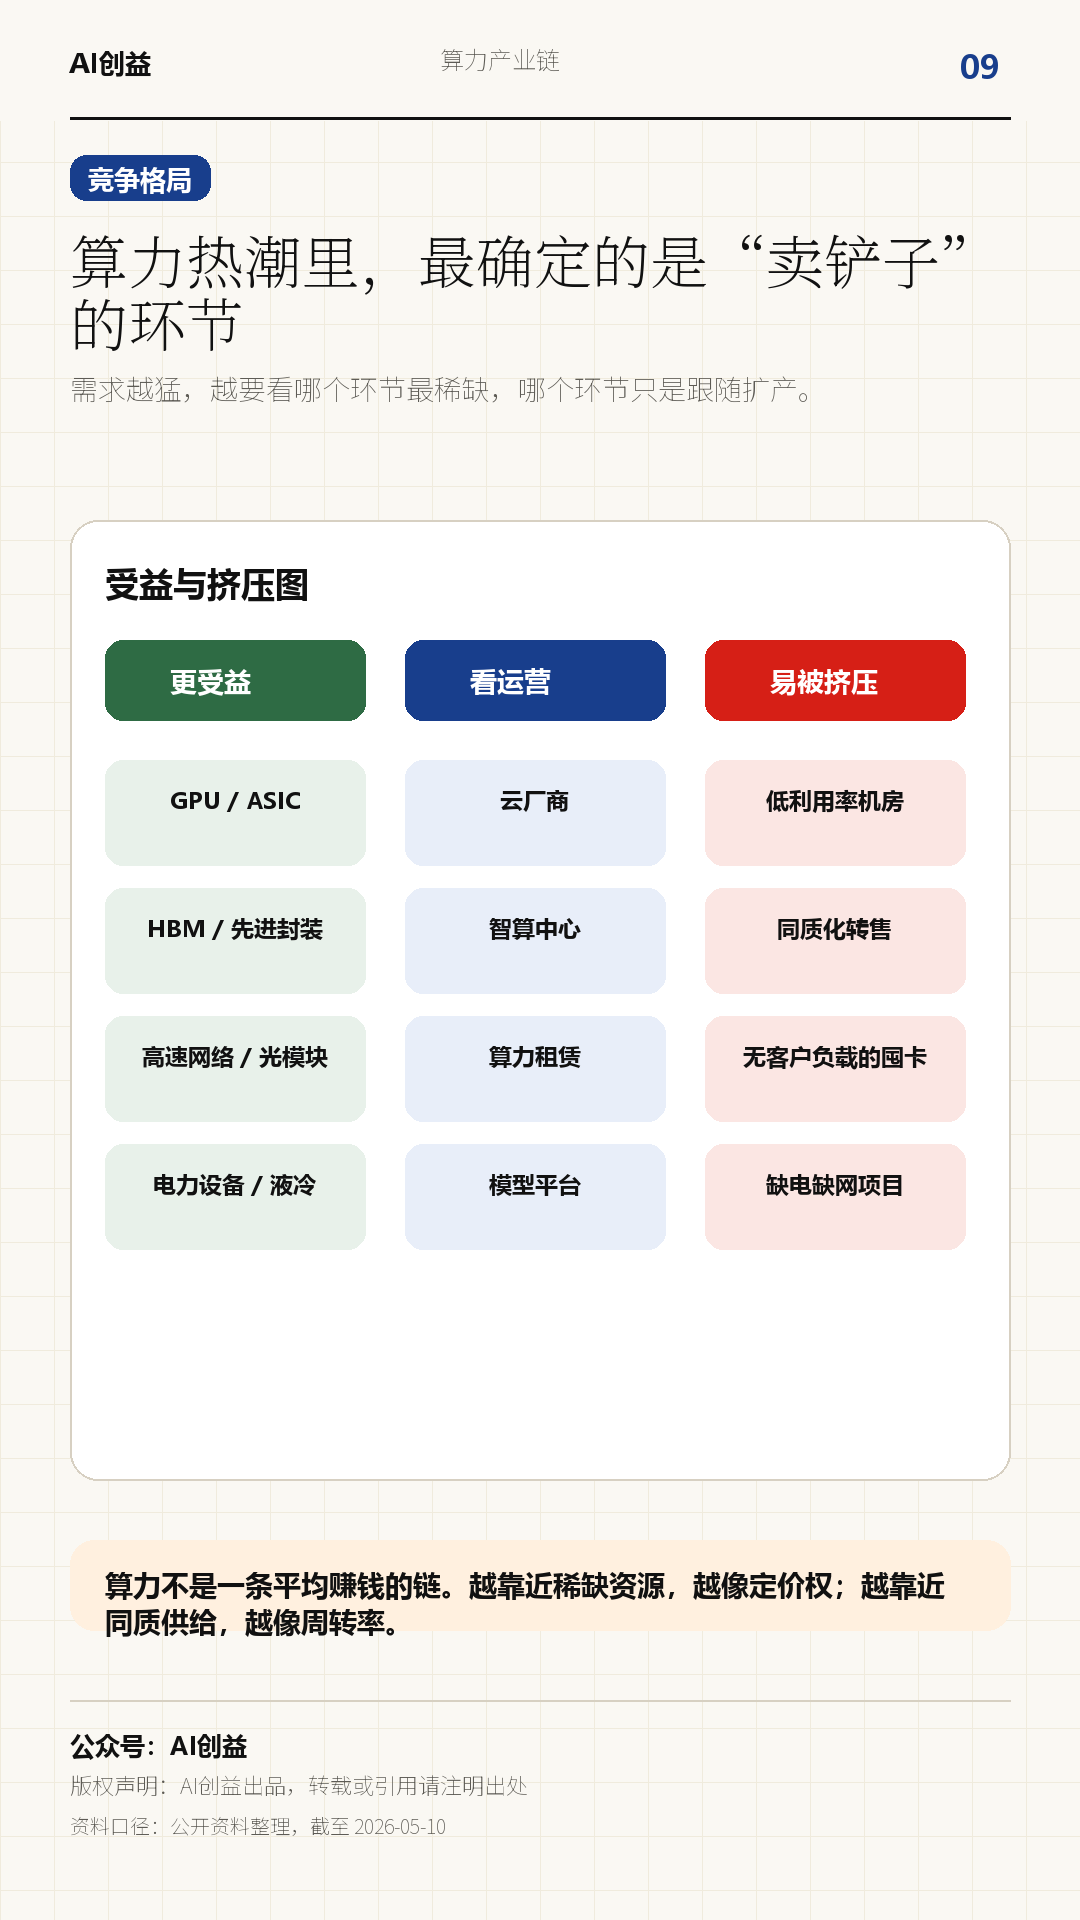
算力产业链不是平均赚钱。
越靠近稀缺资源,越有定价权。GPU、HBM、先进封装、网络光互连、电力设备、液冷和高质量 IDC 工程,都属于“供给跟不上需求”的环节。
越靠近同质化供给,越看运营。云厂商、智算中心、算力租赁平台要靠客户、利用率和服务能力区分。没有稳定客户负载的囤卡项目,最终会被折旧、能耗和价格下行挤压。
这条链上最危险的不是没有故事,而是只有故事。
10 / 单位经济 / 算力公司的利润,最后都要回到三张表
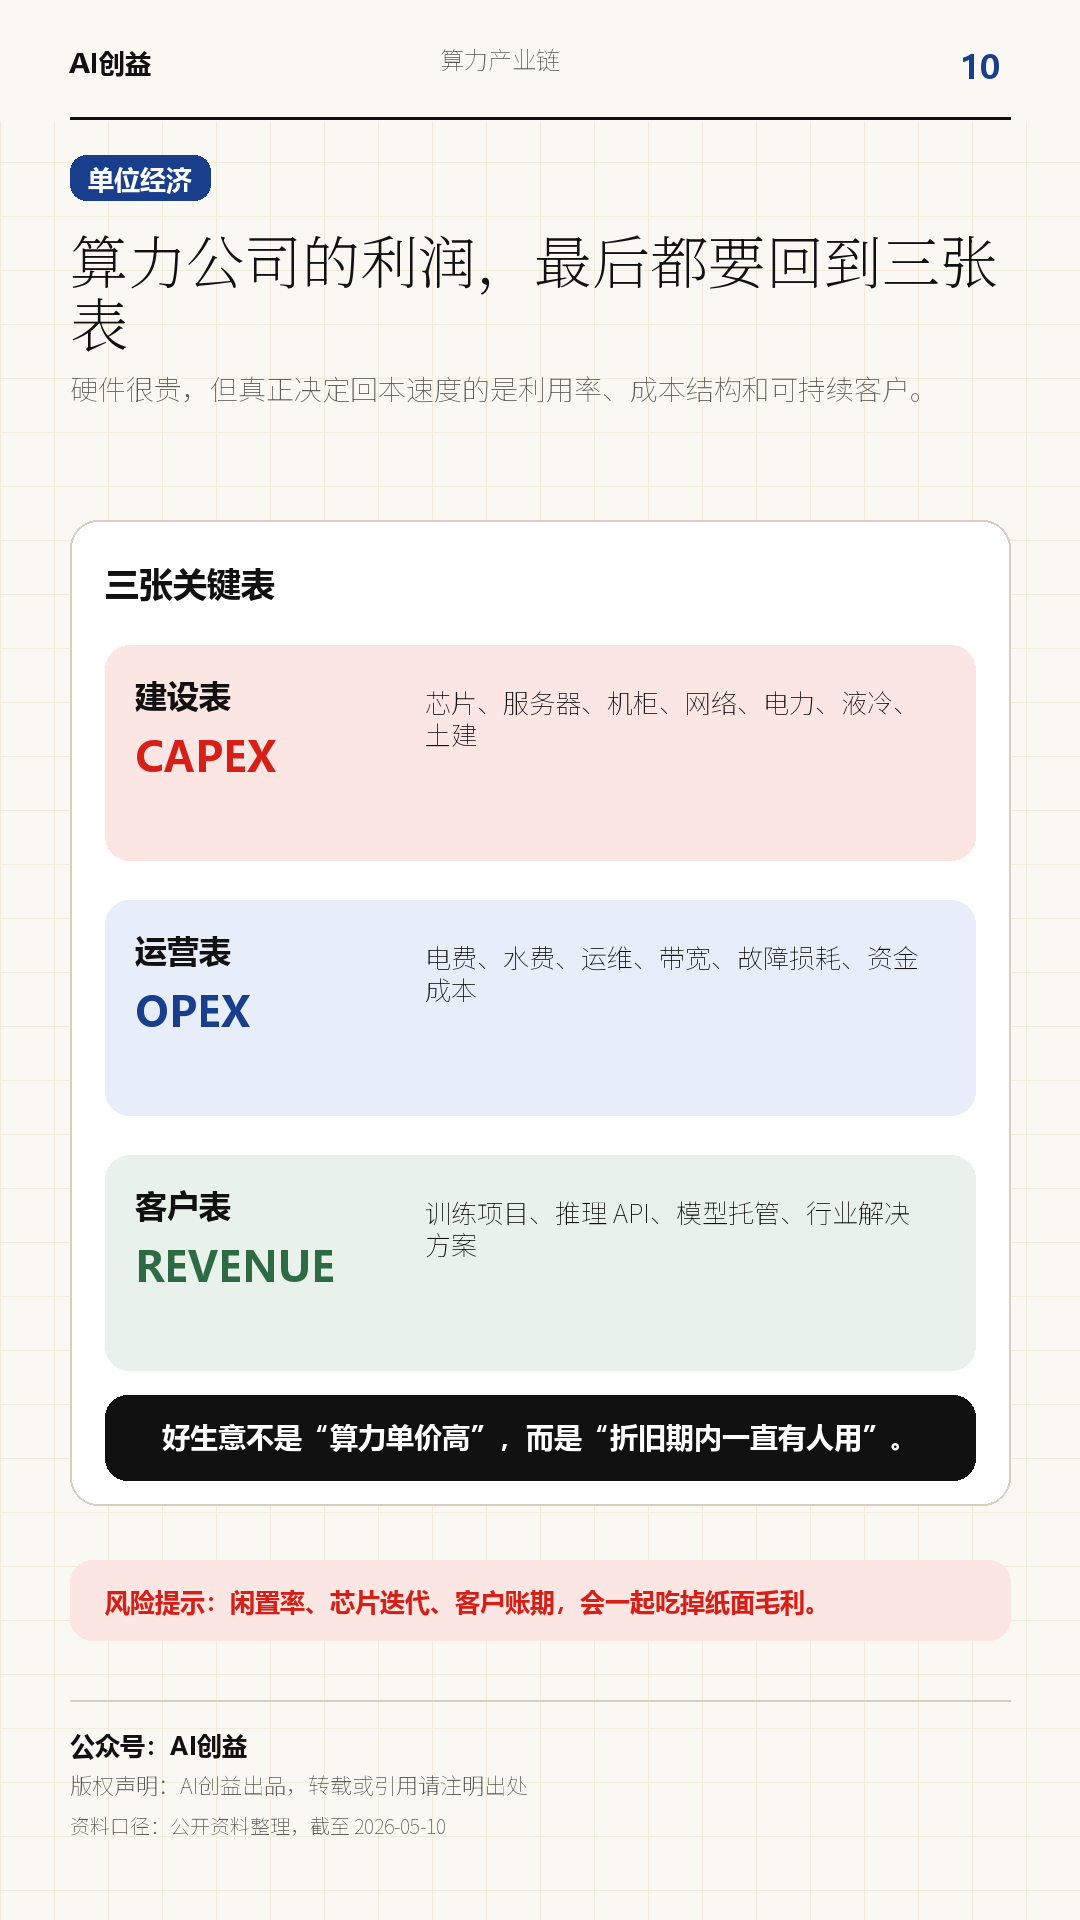
看算力公司,不能只看规模。
第一张表是建设表:芯片、服务器、机柜、网络、电力、液冷、土建,决定初始投入。第二张表是运营表:电费、水费、运维、带宽、故障损耗、资金成本,决定日常消耗。第三张表是客户表:训练项目、推理 API、模型托管、行业解决方案,决定收入是不是可持续。
算力单价高的时候,很多问题会被掩盖。等供给上来,真正能留下的,是低成本、低故障、高利用率、客户负载稳定的平台。
好生意不是“算力单价高”,而是“折旧期内一直有人用”。
11 / 最终判断 / 未来的算力公司,不只是买卡公司
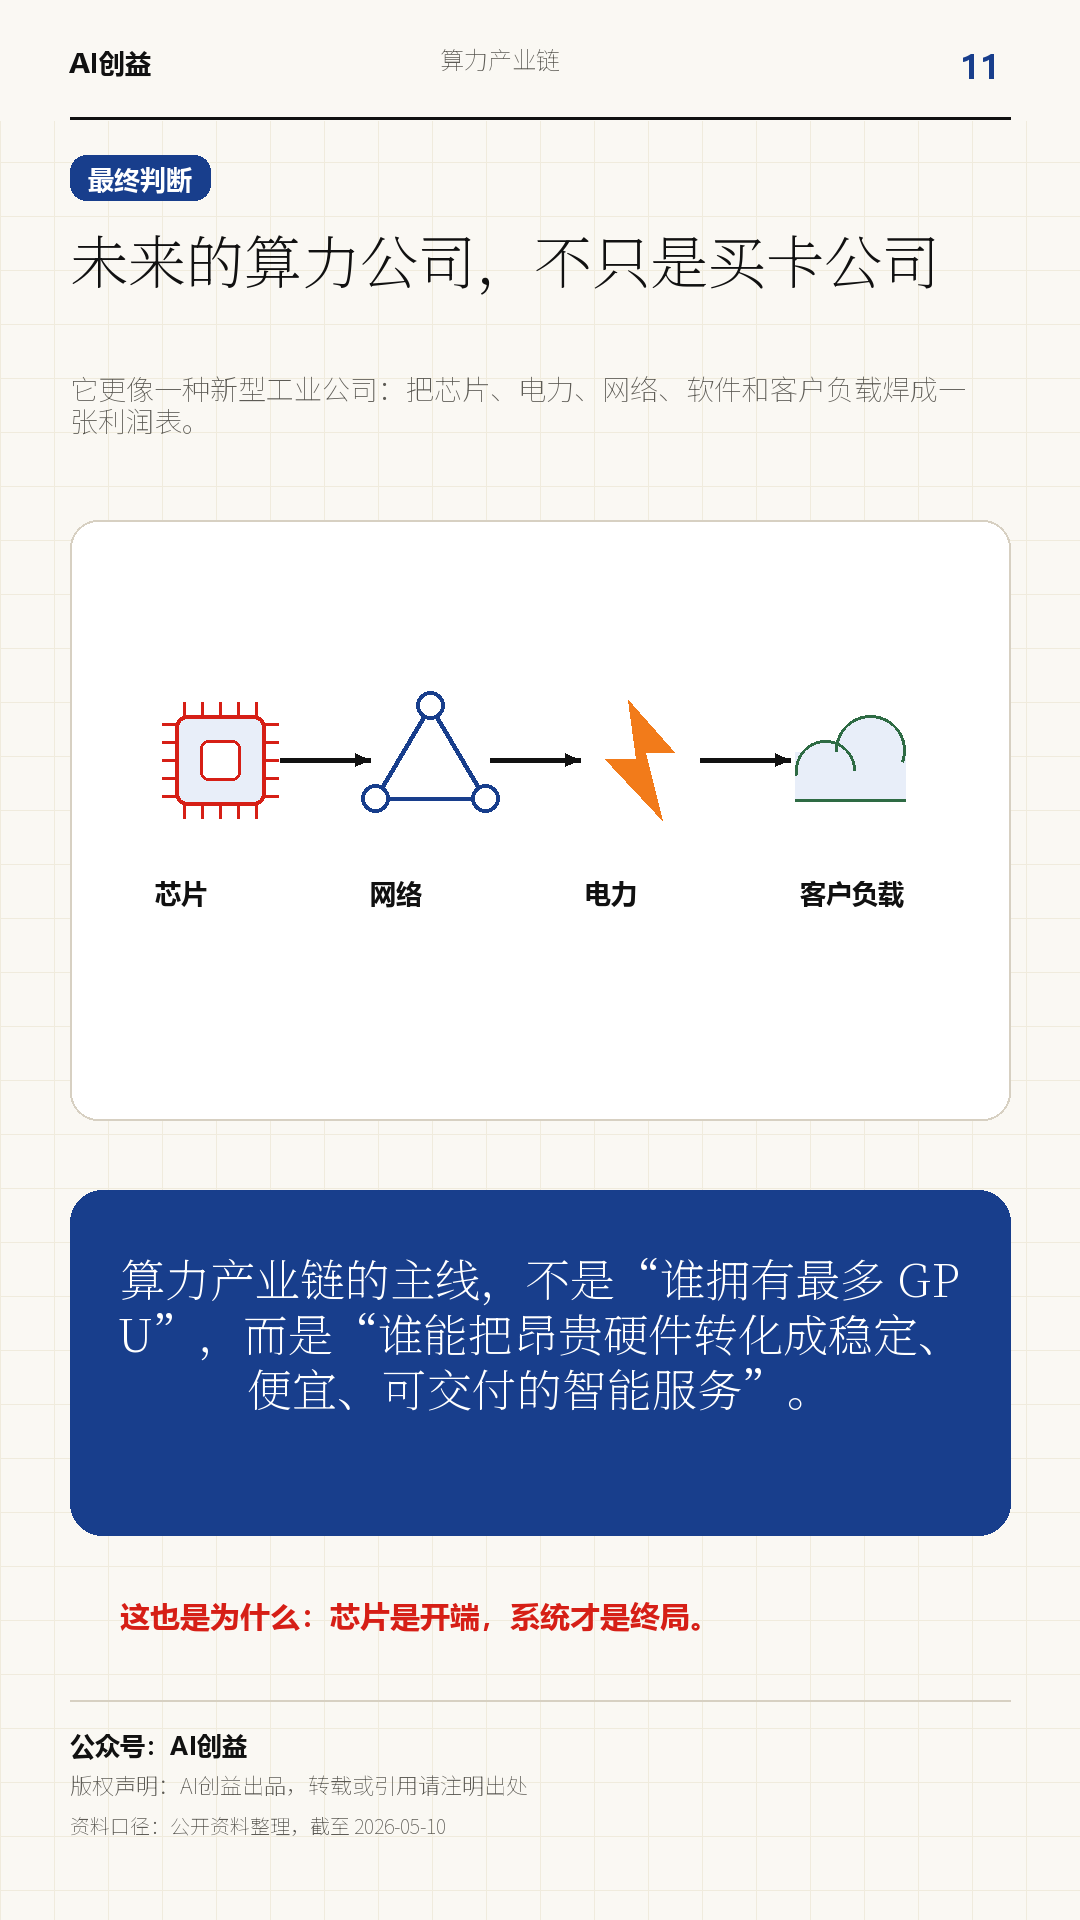
算力产业链的终局,不会停留在“谁买到了更多 GPU”。
真正能穿越周期的公司,要把芯片、电力、网络、软件和客户负载焊成一张利润表。上游看稀缺资源,中游看运营效率,下游看推理场景能不能跑出持续收入。
如果用一句话收束这条产业链:
芯片是开端,系统才是终局。
资料来源
-
微信参考文章:《一天吃透一条产业链:磷酸铁锂(需求激增)》 -
中国政府网:《算力基础设施高质量发展行动计划》政策解读 -
中国信通院:《先进计算暨算力发展指数蓝皮书(2025年)》 -
IEA:Energy and AI -
NVIDIA FY2026 财报新闻稿 -
NVIDIA GB200 NVL72 / GB300 NVL72 产品资料 -
Cisco:Silicon One G300 与 1.6T optics -
NVIDIA:Spectrum-X Photonics -
TrendForce:AI server shipments 2025 -
Bain:How Can We Meet AI's Insatiable Demand for Compute Power

相关文章


